
У матеріалі
26 розд.Робот без пам’яті — золота рибка з маніпуляторами
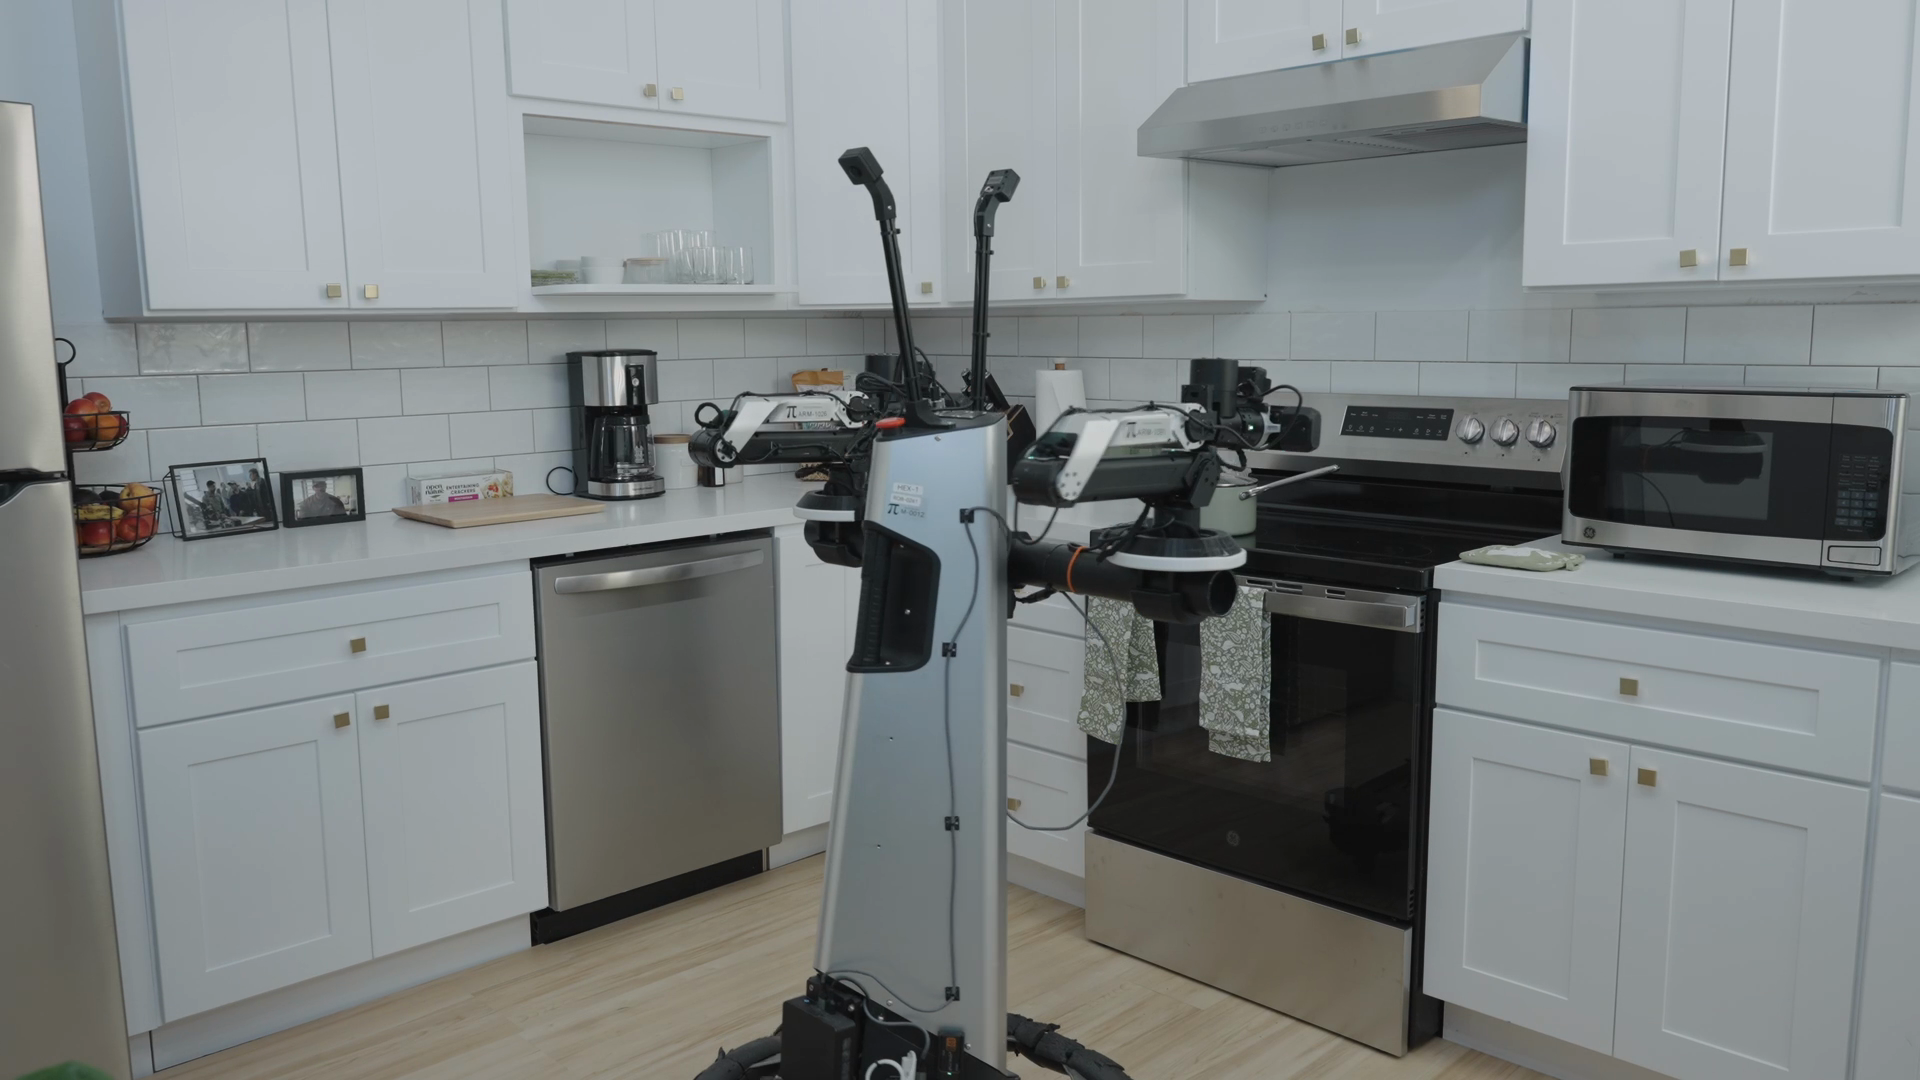
Уявімо кухонного робота, який уже вміє відкрити холодильник, взяти тарілку, витерти стіл і покласти продукт у шафу. Це звучить майже як домашній помічник. Але якщо після невдалої спроби він через десять секунд повторює ту саму помилку, а через п’ять хвилин забуває, яку шафу вже прибирав, інтелект раптом виглядає набагато менш магічно. Моторна навичка є; цілісної поведінки — ще немає.
Саме до цієї межі підійшли сучасні vision-language-action models, або VLA: вони навчилися перетворювати зображення, текстову команду й стан робота на рухи. Наступна задача значно прозаїчніша й водночас фундаментальніша — не загубити нитку власного життя. Роботу потрібно знати, що він щойно робив, де лежить потрібний предмет, що вже не спрацювало і який крок узагалі наступний.
Чому ChatGPT-підхід не переноситься у фізичний світ одним натисканням кнопки
У мовних моделей був гігантський подарунок: інтернет. Тексти вже існували у цифровому вигляді, їх можна було збирати мільярдами сторінок. У робототехніці такого готового «інтернету дій» немає. Щоб отримати одну якісну trajectory, фізична машина має реально рухатися, оператор — показати дію, камери й сенсори — записати стан, а обладнання — не розбитися об стіл у процесі.
Тому data bottleneck у robotics жорсткіший. Berkeley прямо формулює проблему: robot pre-training datasets набагато менші за мовні та візуальні, а реальний світ має безліч варіацій — інший стіл, інше освітлення, інша рука, інший gripper, інший friction. Модель повинна не лише «знати багато», а ще й відповідати в реальному часі, бо чашка не чекатиме, поки transformer десять секунд думає.
800 тисяч демонстрацій — велика цифра для роботів і крихітна для інтернету
У новій дисертації Homer Walke описує foundation model, навчений приблизно на 800 тисячах demonstrations для single-arm manipulators. Для robotics це вже серйозний масштаб: сотні тисяч фізичних епізодів із камерами, proprioception та actions. Для порівняння з LLM це майже смішно мало — і саме ця різниця пояснює, чому «загальний робот» рухається повільніше, ніж чатботи.
Цінність таких даних не тільки у кількості. Вони повинні покривати різні objects, tasks, scenes та способи виконання. Якщо модель сто тисяч разів бачила одну й ту саму коробку на одному столі, це не generalization, а дуже дорога форма запам’ятовування. Сильний dataset має вчити інваріантам: що означає «взяти», «відкрити», «поставити» незалежно від конкретної форми предмета.
Один мозок, різні тіла: найцікавіша ставка сучасної robotics
Людина може сісти на велосипед, взяти молоток або вперше керувати новою кавомашиною, не створюючи окремий мозок під кожний інструмент. У роботів поки навпаки: policy часто настільки прив’язана до конкретної arm geometry, cameras та action space, що новий hardware означає нове навчання.
Walke описує спільне training на bimanual arms, wheeled robots і quadrupeds та повідомляє про ознаки positive transfer між embodiments. Ідея дуже сильна: досвід однієї фізичної форми може частково покращувати іншу. Не тому, що колесо раптом «розуміє» лапу, а тому що високорівневі закономірності світу — object permanence, contact, geometry, cause and effect — спільні для різних тіл.
Octo показав, що generalist policy може бути не лише закритою демонстрацією
Open-source проєкт Octo став важливим попередником цієї лінії. Transformer-based diffusion policy навчали на 800 тисячах robot episodes із суміші 25 datasets. Її перевіряли на дев’яти реальних robot setups у чотирьох institutions, а architecture спеціально дозволяє підключати нові observations та action spaces.
У finetuning tests Octo використовував приблизно по сто target demonstrations на задачу й у середньому суттєво випереджав baseline, що навчався з нуля. Тут цікава не конкретна таблиця score, а engineering lesson: великий загальний policy може бути не фінальним «мозком», а хорошою стартовою точкою. Як pretrained vision model, який потім швидко адаптується до вузької камери чи нового gripper.
Але навіть хороший generalist без пам’яті живе короткими сценами
Коротка manipulation task зручна для benchmark: «візьми чашку», «поклади ложку», «закрий drawer». У такій сцені майже вся потрібна інформація міститься у поточному frame. Довга задача інша. Щоб прибрати кухню, треба пам’ятати, що брудна тарілка вже в раковині, що пакет із картоплею був у холодильнику, а половина countertop уже витерта.
Якщо подавати моделі всі raw camera frames за 15 хвилин, context роздується до абсурдних розмірів, inference сповільниться, а важлива подія загубиться у морі майже однакових кадрів. Якщо історію просто відкинути — робот поводиться як людина, яку кожні кілька секунд знайомлять із власною кухнею заново.
MEM розділяє пам’ять так само практично, як це зробили б ми
Multi-scale Embodied Memory від Physical Intelligence використовує два різні формати. Short-term memory зберігає недавні visual observations у компактному video representation — щоб пам’ятати точний рух, occlusion або невдалий grasp. Long-term memory перетворює минулі події на текстові нотатки: «поставив каструлю в раковину», «нижні дверцята холодильника відкриті», «тарілки вже прибрані».
Це красиве інженерне рішення, бо різні часові масштаби потребують різної деталізації. Щоб через дві секунди зрозуміти, куди ковзнула ложка, потрібні frames. Щоб через десять хвилин не почати мити вже чисту миску, достатньо короткого факту. Відео — подробиці, текст — щоденник.
Робот сам вирішує, що варто пам’ятати
Найцікавіший момент MEM — memory не просто автоматичний log. Високорівневий reasoning process одночасно обирає subtask і формує нові memories. Система може записати конкретну подію, а може узагальнити кілька кроків у компактніший опис. Це економить tokens і, що важливіше, змушує модель відрізняти інформацію від шуму.
Тут виникає майже філософське питання, але цілком практичне для software: хороша пам’ять — це не здатність зберегти все, а здатність забути правильні речі. Камера генерує тисячі майже однакових observations; для майбутнього рішення важливі лише кілька змін стану. Роботичний memory system фактично вчиться редагувати власну біографію.
Невдалий grasp стає досвідом, а не циклом покарання
Physical Intelligence показує простий, але дуже переконливий приклад із пласким chopstick. Policy без memory кілька разів повторює майже ту саму невдалу спробу підхопити предмет. Для неї кожний новий момент схожий на першу зустріч. Memory-augmented version бачить власну невдачу в короткій історії, змінює approach і зрештою підбирає chopstick.
Ще кращий приклад — дверцята холодильника, напрямок відкривання яких погано видно з image. Модель спочатку пробує один бік, помиляється, а потім пробує інший. Це крихітна поведінка, але саме з таких речей складається реальна автономність: intelligence — не відсутність помилок, а здатність не робити одну й ту саму помилку з ентузіазмом двадцять разів.
До 15 хвилин: grilled cheese, рецепти й ціла кухня
MEM демонстрували на tasks тривалістю до приблизно 15 хвилин. Серед них — приготування grilled cheese, де треба не лише маніпулювати ingredients, а ще й стежити за timing; збір ingredients за рецептом із cabinet/fridge; та прибирання цілої kitchen з миттям dishes, wiping surfaces і stowing objects.
П’ятнадцять хвилин не звучать як «робот працює цілий день», але для learned policy це якісно інша зона. За такий час scene багато разів змінюється, предмети зникають з camera, виникають проміжні цілі, а mistakes накопичуються. Це вже не single action benchmark, а маленька історія з початком, серединою й кінцем.
Погана пам’ять може зробити AI дурнішим
Додавання memory не автоматично покращує model. Автори MEM окремо описують causal confusion: система може запам’ятати випадкову кореляцію й потім використовувати її як нібито причину. Наприклад, якщо певний visual cue часто з’являвся перед успішною дією у training data, memory може надмірно підсилити цю асоціацію.
Це знайома проблема людям: пам’ять не є безпомилковою базою даних, вона впливає на інтерпретацію нового. Для robotics наслідок серйозний — memory architecture треба оцінювати так само суворо, як perception чи control. Система, що дуже впевнено пам’ятає неправильне, небезпечніша за систему, яка чесно нічого не пам’ятає.
Чому це справжня кібернетика, а не просто ще один transformer
Класична кібернетика цікавилася feedback loop: система діє, спостерігає наслідок, порівнює його з ціллю й коригує наступну дію. Memory додає у цей loop історію. Тепер state — це не лише «що я бачу зараз», а «що відбулося раніше і що це означає для наступного кроку».
Саме тому robot foundation models стають цікавішими за просте «LLM прикрутили до руки». У хорошій architecture language reasoning, perception, learned motor policy, proprioception, memory і classical control виконують різні ролі. LLM не повинен керувати motor current; він має допомагати системі розуміти context, планувати й вчасно змінювати стратегію.
Що ще відділяє кухонну демонстрацію від робота, якому можна довірити дім
П’ятнадцять хвилин memory — тільки початок. Реальний помічник має пам’ятати години й дні, розрізняти тимчасові та постійні факти, знати, що людина переставила предмет, а не «світ зламався». Він повинен розуміти uncertainty: не впевнений — перевір; бачиш людину — сповільнись; не знаєш, чи можна мити предмет водою — не імпровізуй ціною чужого ноутбука.
Друга проблема — evaluation. У короткому benchmark легко порахувати success/fail. У годинній задачі важливі recovery, кількість непотрібних дій, safety, енергія, час і те, чи залишив робот кухню у кращому стані, ніж знайшов. General intelligence у physical world вимірюється не красивим demo, а нудною надійністю.
Найцікавіший сценарій: досвід перестає належати одному тілу
Якщо cross-embodiment transfer і memory зійдуться в одній architecture, з’явиться дуже сильна ідея: robot fleet накопичує досвід незалежно від конкретного chassis. Wheeled platform може навчитися high-level sequence у warehouse, інший manipulator — точному grasp, а спільний foundation model використає обидва типи knowledge там, де вони сумісні.
Це ще не «колективна свідомість роботів», і добре, що не треба продавати статтю таким заголовком. Але це реальний engineering direction: від тисяч ізольованих machines із власними scripts — до моделей, для яких нове тіло стає новим interface до вже накопиченого physical knowledge. Ось тут robotics починає нагадувати той момент, коли software перестав бути прив’язаний до одного конкретного комп’ютера.
Справжній general-purpose robot потребує не одного трюку, а зв’язки data + cross-embodiment + memory + feedback.
- Berkeley описує foundation-model training на приблизно 800 тисячах robot demonstrations.
- Joint training охоплює arms, wheeled robots і quadrupeds та дає ознаки transfer між embodiments.
- MEM розділяє short-term visual memory і long-term language memory.
- Physical Intelligence демонструє long-horizon tasks до приблизно 15 хвилин.
Масштаб роботичного навчання
Масштаб foundation-model data у Berkeley/Octo line of work.
Суміш Open X-Embodiment, використана для Octo.
Реальні evaluation setups Octo у чотирьох institutions.
Довгі tasks, показані MEM.
Мовна модель і роботичний foundation model
| Проблема | LLM | Robot VLA |
|---|---|---|
| Data | Величезний готовий corpus тексту | Фізичні demonstrations дорогі й повільні |
| Output | Tokens | Continuous/high-frequency actions |
| Latency | Секунди часто прийнятні | Control має реагувати в реальному часі |
| Помилка | Невдале речення | Розбита чашка або небезпечний рух |
| Memory | Conversation/context | Visual history + task state + physical consequences |
Як робот стискає власну історію
Бачить
Камери й proprioception дають поточний стан та коротку visual history.
Стискає
Video encoder лишає detail, потрібний для недавніх рухів і occlusions.
Записує
High-level model формує текстові memories про важливі зміни стану.
Планує
Наступний subtask вибирається з урахуванням current scene та memories.
Адаптується
Невдала дія стає evidence для іншої стратегії, а не просто повтором.
Що варто запам’ятати читачеві
800 тисяч demonstrations — це вже «ChatGPT для роботів»?
Чи може одна модель керувати будь-яким роботом?
Навіщо long-term memory зберігати текстом?
15 хвилин — це багато?
Що читати далі
Ще дві теми з цієї серії — щоб не закривати вкладку на найцікавішому.
Джерела та перевірка
- UC Berkeley EECSBuilding Generally Intelligent Robots
- Physical IntelligenceVLAs with Long and Short-Term Memory
- Octo Model TeamOcto: An Open-Source Generalist Robot Policy
Читайте більше
Коментарі0 коментарів
Коментарі