
В материале
26 разд.Робот без памяти — золотая рыбка с манипуляторами
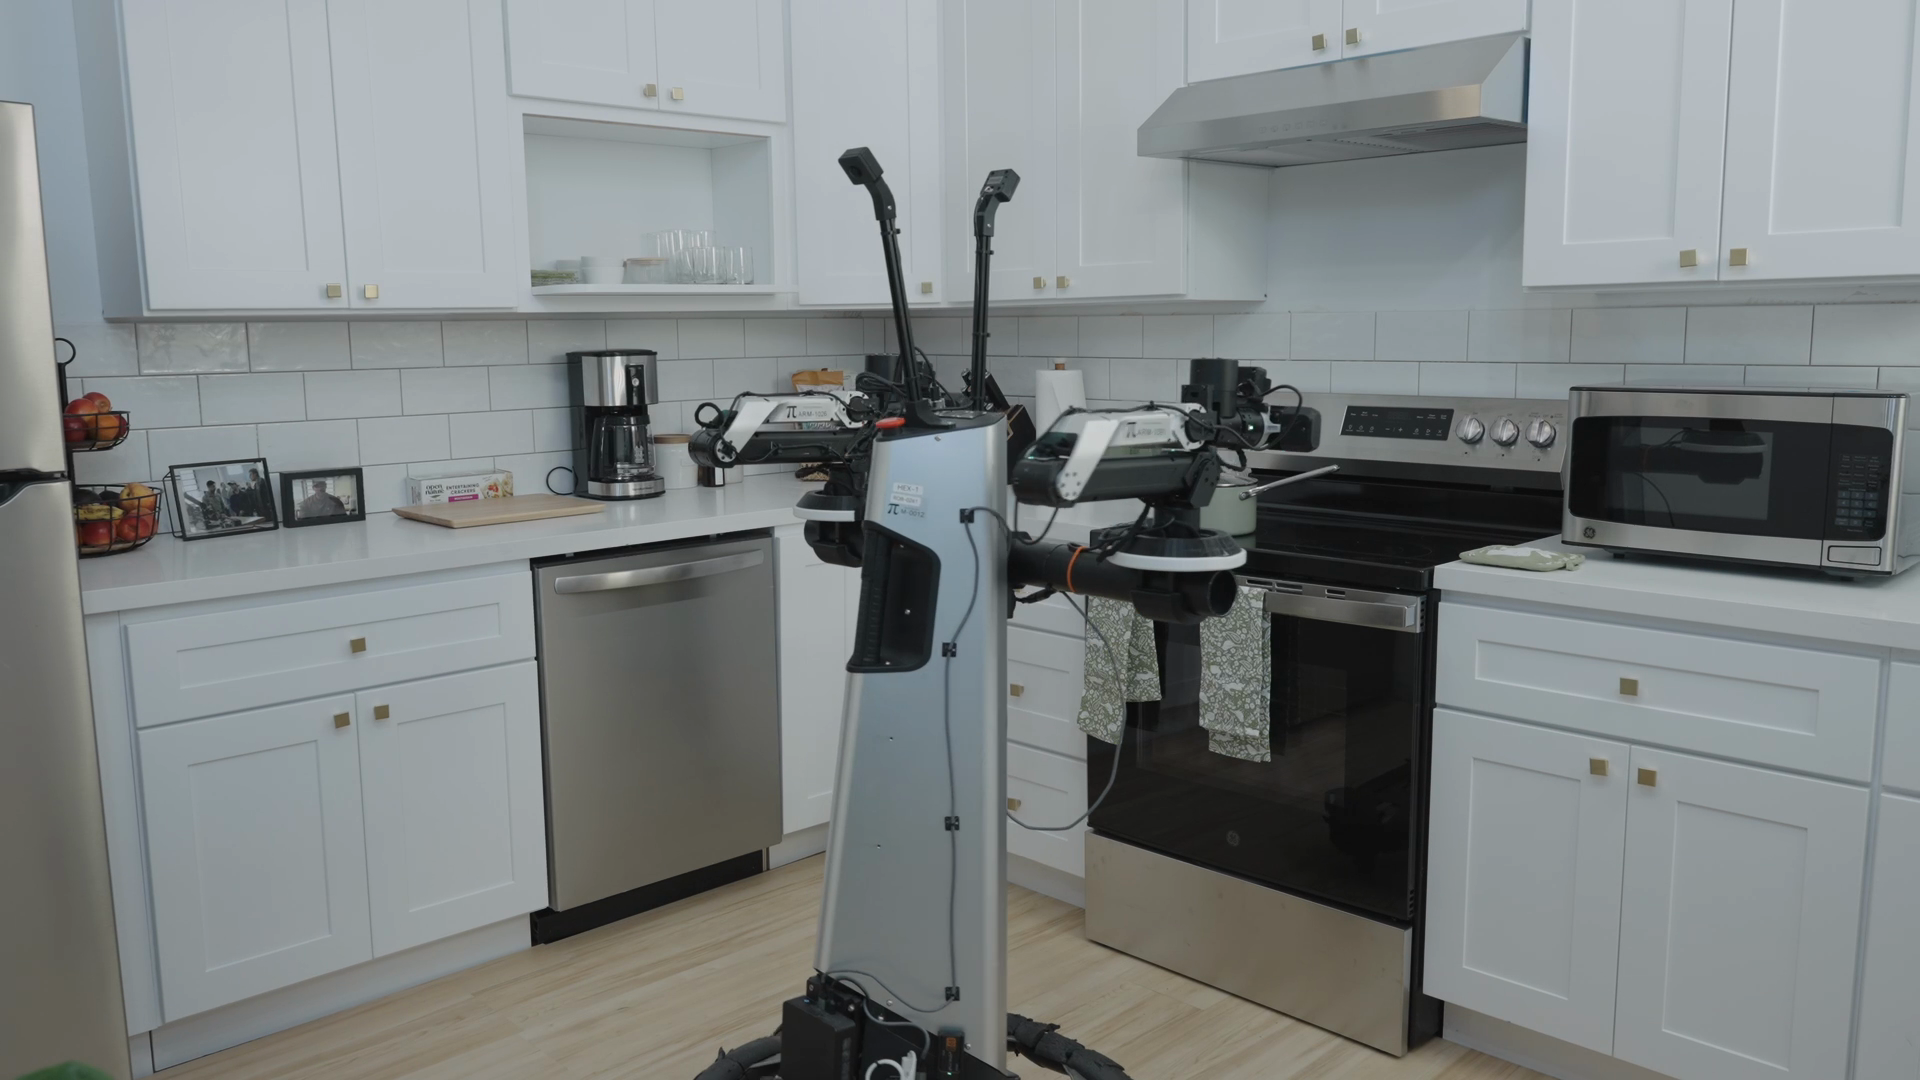
Представим кухонного робота, который уже умеет открыть холодильник, взять тарелку, протереть стол и убрать продукт в шкаф. Почти домашний помощник. Но если после неудачной попытки он через десять секунд повторяет ту же ошибку, а через пять минут забывает, какой шкаф уже убирал, интеллект внезапно выглядит гораздо менее магически. Моторный навык есть; цельного поведения — ещё нет.
Именно к этой границе подошли современные vision-language-action models, или VLA: они научились превращать изображения, текстовую команду и состояние робота в движения. Следующая задача прозаичнее и фундаментальнее — не потерять нить собственной жизни. Роботу нужно помнить, что он только что делал, где находится нужный предмет, что уже не сработало и какой шаг вообще следующий.
Почему подход ChatGPT не переносится в физический мир одной кнопкой
У языковых моделей был гигантский подарок — интернет. Тексты уже существовали в цифровом виде, их можно было собирать миллиардами страниц. В робототехнике готового «интернета действий» нет. Чтобы получить одну качественную trajectory, физическая машина должна реально двигаться, оператор — показать действие, камеры и сенсоры — записать состояние, а hardware — желательно не встретиться с полом слишком эмоционально.
Поэтому data bottleneck в robotics жёстче. Berkeley прямо формулирует проблему: robot pre-training datasets намного меньше языковых и визуальных, а реальный мир содержит бесконечные вариации — другой стол, свет, gripper, friction. И модель должна отвечать в реальном времени: чашка не обязана ждать, пока transformer закончит размышлять.
800 тысяч демонстраций — много для роботов и почти ничего для интернета
В новой диссертации Homer Walke описывает foundation model, обученный примерно на 800 тысячах demonstrations для single-arm manipulators. Для robotics это серьёзный масштаб: сотни тысяч физических эпизодов с cameras, proprioception и actions. На фоне LLM эта цифра крошечная — и именно разница в доступных данных объясняет, почему «универсальный робот» развивается медленнее чатботов.
Важно не только число episodes. Dataset должен покрывать разные objects, tasks, scenes и способы выполнения. Если модель сто тысяч раз видела одну коробку на одном столе, это не generalization, а очень дорогая форма зубрёжки. Сильные данные должны учить инвариантам: что означает «взять», «открыть» или «поставить» независимо от конкретной формы предмета.
Один мозг, разные тела — самая интересная ставка robotics
Человек может сесть на велосипед, взять молоток или впервые пользоваться новой кофемашиной, не выращивая отдельный мозг под каждый инструмент. У роботов часто наоборот: policy привязана к geometry руки, cameras и action space настолько, что новый hardware требует нового обучения.
Walke описывает совместный training на bimanual arms, wheeled robots и quadrupeds и сообщает о признаках positive transfer между embodiments. Опыт одной формы может частично помогать другой, потому что высокоуровневые закономерности мира — object permanence, contact, geometry, cause and effect — общие для разных тел.
Octo показал: generalist policy может быть открытой, а не только сценическим demo
Open-source Octo стал важным предшественником этой линии. Transformer-based diffusion policy обучали на 800 тысячах robot episodes из смеси 25 datasets. Её проверяли на девяти реальных robot setups в четырёх institutions, а architecture позволяет подключать новые observations и action spaces.
В finetuning tests Octo использовал примерно по сто target demonstrations на задачу и в среднем заметно превосходил baseline, обученный с нуля. Главное здесь не конкретный score, а engineering lesson: большой generalist policy может быть хорошей стартовой точкой, как pretrained vision model, который быстро адаптируется под новую camera или gripper.
Но хороший generalist без памяти всё равно живёт короткими сценами
Короткий benchmark удобен: «возьми чашку», «положи ложку», «закрой drawer». Почти вся нужная информация есть в текущем frame. Долгая задача другая. Чтобы убрать кухню, нужно помнить, что грязная тарелка уже в раковине, пакет картофеля был в холодильнике, а половина countertop уже вытерта.
Если передавать модели все raw frames за 15 минут, context раздувается, inference замедляется, а важное событие теряется среди тысяч похожих кадров. Если историю отбросить — робот ведёт себя как человек, которого каждые несколько секунд заново знакомят с собственной кухней.
MEM разделяет память так же практично, как сделал бы человек
Multi-scale Embodied Memory использует два формата. Short-term memory хранит недавние visual observations в компактном video representation — чтобы помнить точное движение, occlusion или неудачный grasp. Long-term memory превращает прошлые события в текстовые заметки: «поставил кастрюлю в раковину», «нижняя дверь холодильника открыта», «тарелки уже убраны».
Разным временным масштабам нужна разная детализация. Чтобы через две секунды понять, куда соскользнула ложка, нужны frames. Чтобы через десять минут не начать мыть уже чистую миску, достаточно короткого факта. Видео — подробности, текст — дневник.
Робот сам решает, что стоит запомнить
В MEM memory — не просто автоматический log. Высокоуровневый reasoning process одновременно выбирает subtask и формирует новые memories. Система может записать конкретное событие или обобщить несколько шагов в более компактное описание. Это экономит tokens и заставляет модель отличать информацию от шума.
Хорошая память — не способность сохранить всё, а способность забыть правильные вещи. Camera генерирует тысячи почти одинаковых observations; для будущего решения важны лишь несколько изменений состояния. Robot memory system фактически учится редактировать собственную биографию.
Неудачный grasp становится опытом, а не вечным наказанием
Physical Intelligence показывает пример с плоской chopstick. Policy без memory несколько раз повторяет почти одну и ту же неудачную попытку. Для неё каждый момент похож на первую встречу. Memory-augmented version видит собственную ошибку, меняет approach и в итоге подбирает предмет.
Ещё лучше пример с дверцей холодильника, направление которой плохо видно на image. Модель пробует одну сторону, ошибается, затем другую. Это маленькая сцена, но в ней суть автономности: intelligence — не отсутствие ошибок, а способность не совершать одну и ту же ошибку с одинаковым энтузиазмом двадцать раз.
До 15 минут: grilled cheese, рецепты и целая кухня
MEM демонстрировали на tasks длительностью до примерно 15 минут. Среди них приготовление grilled cheese, где важно следить и за timing; поиск ingredients по рецепту в cabinet/fridge; и уборка целой kitchen с мытьём dishes, wiping surfaces и stowing objects.
Пятнадцать минут не звучат как «робот работает весь день», но для learned policy это качественно другой режим. Scene многократно меняется, предметы исчезают из camera, появляются промежуточные цели, а mistakes накапливаются. Это уже не single-action benchmark, а небольшая история с началом, серединой и концом.
Плохая память может сделать AI глупее
Добавление memory не автоматически улучшает model. Авторы MEM отдельно описывают causal confusion: система может запомнить случайную корреляцию и использовать её как будто причинную. Если visual cue часто появлялся перед успешным действием в training data, память способна чрезмерно усилить эту ассоциацию.
Это знакомая человеческая проблема: память не безошибочная база данных, она влияет на интерпретацию нового. Для robotics вывод серьёзный — memory architecture нужно тестировать так же строго, как perception и control. Система, которая уверенно помнит неправильное, опаснее системы, честно ничего не помнящей.
Почему это настоящая кибернетика, а не просто transformer на колёсах
Классическая кибернетика изучала feedback loop: система действует, наблюдает результат, сравнивает его с целью и корректирует следующее действие. Memory добавляет в loop историю. State теперь означает не только «что я вижу сейчас», но и «что произошло раньше и что это меняет».
Поэтому robot foundation models интереснее схемы «LLM прикрутили к руке». В хорошей architecture language reasoning, perception, learned motor policy, proprioception, memory и classical control выполняют разные роли. LLM не должен управлять motor current; его место выше — понимать context, планировать и вовремя менять стратегию.
Что отделяет кухонное demo от робота, которому можно доверить дом
Пятнадцать минут memory — начало. Реальный помощник должен помнить часы и дни, различать временные и постоянные факты, понимать, что человек переставил предмет, а не «мир сломался». Нужна uncertainty: не уверен — проверь; рядом человек — замедлись; не знаешь, можно ли мочить предмет — не устраивай эксперимент ценой чужого ноутбука.
Вторая проблема — evaluation. В коротком benchmark легко посчитать success/fail. В часовой задаче важны recovery, ненужные действия, safety, энергия, время и то, оставил ли робот комнату в лучшем состоянии, чем нашёл. General intelligence в physical world измеряется не красивым demo, а скучной надёжностью.
Самый интересный сценарий: опыт перестаёт принадлежать одному телу
Если cross-embodiment transfer и memory сойдутся в одной architecture, появится сильная идея: robot fleet накапливает опыт независимо от конкретного chassis. Wheeled platform может выучить high-level sequence в warehouse, другой manipulator — точный grasp, а общий foundation model использует оба типа knowledge там, где они совместимы.
Это не «коллективное сознание роботов», и хорошо — нам не нужен дешёвый заголовок. Это инженерное направление: от тысяч изолированных machines со своими scripts к моделям, для которых новое тело становится новым interface к уже накопленному physical knowledge. Примерно так software когда-то перестал быть привязан к одному конкретному компьютеру.
Настоящему general-purpose robot нужна связка data + cross-embodiment + memory + feedback.
- Berkeley описывает foundation-model training примерно на 800 тысячах robot demonstrations.
- Joint training включает arms, wheeled robots и quadrupeds и показывает признаки transfer между embodiments.
- MEM разделяет short-term visual memory и long-term language memory.
- Physical Intelligence демонстрирует long-horizon tasks до примерно 15 минут.
Масштаб роботического обучения
Масштаб foundation-model data в Berkeley/Octo line of work.
Смесь Open X-Embodiment, использованная для Octo.
Реальные evaluation setups Octo в четырёх institutions.
Длинные tasks, показанные MEM.
Языковая модель и роботический foundation model
| Проблема | LLM | Robot VLA |
|---|---|---|
| Data | Огромный готовый corpus текста | Физические demonstrations дорогие и медленные |
| Output | Tokens | Continuous/high-frequency actions |
| Latency | Секунды часто допустимы | Control должен реагировать в реальном времени |
| Ошибка | Плохое предложение | Разбитая чашка или опасное движение |
| Memory | Conversation/context | Visual history + task state + physical consequences |
Как робот сжимает собственную историю
Видит
Cameras и proprioception дают current state и короткую visual history.
Сжимает
Video encoder сохраняет detail, нужный для recent movements и occlusions.
Записывает
High-level model формирует textual memories о важных изменениях state.
Планирует
Следующий subtask выбирается с учётом current scene и memories.
Адаптируется
Неудачное действие становится evidence для другой стратегии.
Что стоит запомнить читателю
800 тысяч demonstrations — это уже «ChatGPT для роботов»?
Одна модель сможет управлять любым роботом?
Зачем long-term memory хранить текстом?
15 минут — это много?
Что читать дальше
Ещё две темы из этой серии — чтобы не закрывать вкладку на самом интересном.
Источники и проверка
- UC Berkeley EECSBuilding Generally Intelligent Robots
- Physical IntelligenceVLAs with Long and Short-Term Memory
- Octo Model TeamOcto: An Open-Source Generalist Robot Policy
Читайте также
Комментарии0 комментариев
Комментарии