
У матеріалі
27 розд.Один розумний робот — складно. П’ять різних роботів — уже менеджмент
У лабораторії легко сказати: «robot, принеси пляшку». У реальному multi-robot team питання інше: хто саме? Wheeled platform швидша на підлозі, quadruped проходить там, де wheelbase застрягне, arm уміє grasp, drone бачить зверху, але нічого важкого не несе. Команда має розкласти людську фразу на tasks, dependencies і capabilities.
CoMuRoS цікава тим, що автори не намагаються зробити один LLM безпосереднім водієм кожного motor. Вони будують hierarchy, схожу на нормальну організацію: зверху task manager, нижче robot-level agents, ще нижче ROS2 skills, perception та classical control. Іншими словами, AI тут більше бригадир, ніж джойстик.
Task manager читає людське бажання, а не готовий DAG
User може дати high-level instruction природною мовою. Central LLM отримує description environment, список robots, їхні skills/constraints і dynamic context: які tasks уже виконані, хто зайнятий, які events відбулися. На цій основі він decomposes goal на executable subtasks.
Classical planning часто вимагає вручну описати preconditions та dependencies. Це дає сильні guarantees, але стає крихким у open world. CoMuRoS обирає іншу trade-off: dependencies частково виводяться з context. Система гнучкіша, але correctness тепер залежить від reasoning LLM і quality scenario description.
Чотири класи задач: independent, sequential, coordinated та infeasible
Якщо drone може шукати survivor, поки quadruped несе aid kit, tasks independent і можуть йти паралельно. Якщо robot arm спершу повинен покласти object у box, а mobile formation потім везе box — є sequential dependency. Якщо три mobile robots одночасно несуть один box, це coordinated task.
Infeasible classification не менш важлива. Нормальний autonomous system має вміти сказати «у нашої команди немає такого skill», а не генерувати heroic plan із повітря. У physical world hallucination дуже швидко перетворюється з кумедного тексту на collision або нескінченне очікування.
Local LLM не вигадує моторну фізику — він складає відомі skills
Після allocation кожний robot-level LLM отримує свою subtask і набір primitive ROS2 skills. Його роль — compose executable Python/commands із дозволених building blocks: navigate, detect, grasp, place, wait, report. Low-level locomotion або manipulator control виконується specialized controller, а не наступним token із language model.
Це здорове розділення відповідальності. LLM добре працює з semantic plan і flexible language; classical robotics добре працює з kinematics, trajectories та feedback at high rate. Спроба змусити один model одночасно міркувати про «доставити аптечку» й стабілізувати wheel velocity — архітектурний мазохізм.
Найрозумніша подія іноді та, яку система ігнорує
У hardware experiment людина кинула red object перед Burger robot. Perception помітив подію, але local event classifier визначив: вона не впливає на current task. Message не пішов central manager, Waffle і quadruped продовжили роботу. Для цього setup authors reported 10/10 success.
Це звучить дрібницею, але у real environment events нескінченні: хтось пройшов повз, двері відчинилися, коробка з’явилася у camera, інший robot чхнув — добре, останнього поки немає. Якщо кожна зміна викликає expensive replanning, система потоне у власній уважності. Intelligence — ще й ability правильно не звертати увагу.
Коли пляшка падає — тоді replanning справді потрібний
Інша hardware sequence перевіряла collaborative recovery. Якщо один robot стикається з event, який заважає task, він повідомляє manager. Той оновлює context, може зупинити частину execution, перепризначити subtask іншому robot і після recovery продовжити основний plan.
У paper hardware collaborative object-recovery scenario мав 9 successes із 10 trials. Це не industrial reliability, але важливо, що test перевіряє mid-execution failure, а не лише красивий plan до натискання Start. Життя починається після першої помилки — робототехніка теж.
Три маленькі mobile robots несуть коробку як одна машина
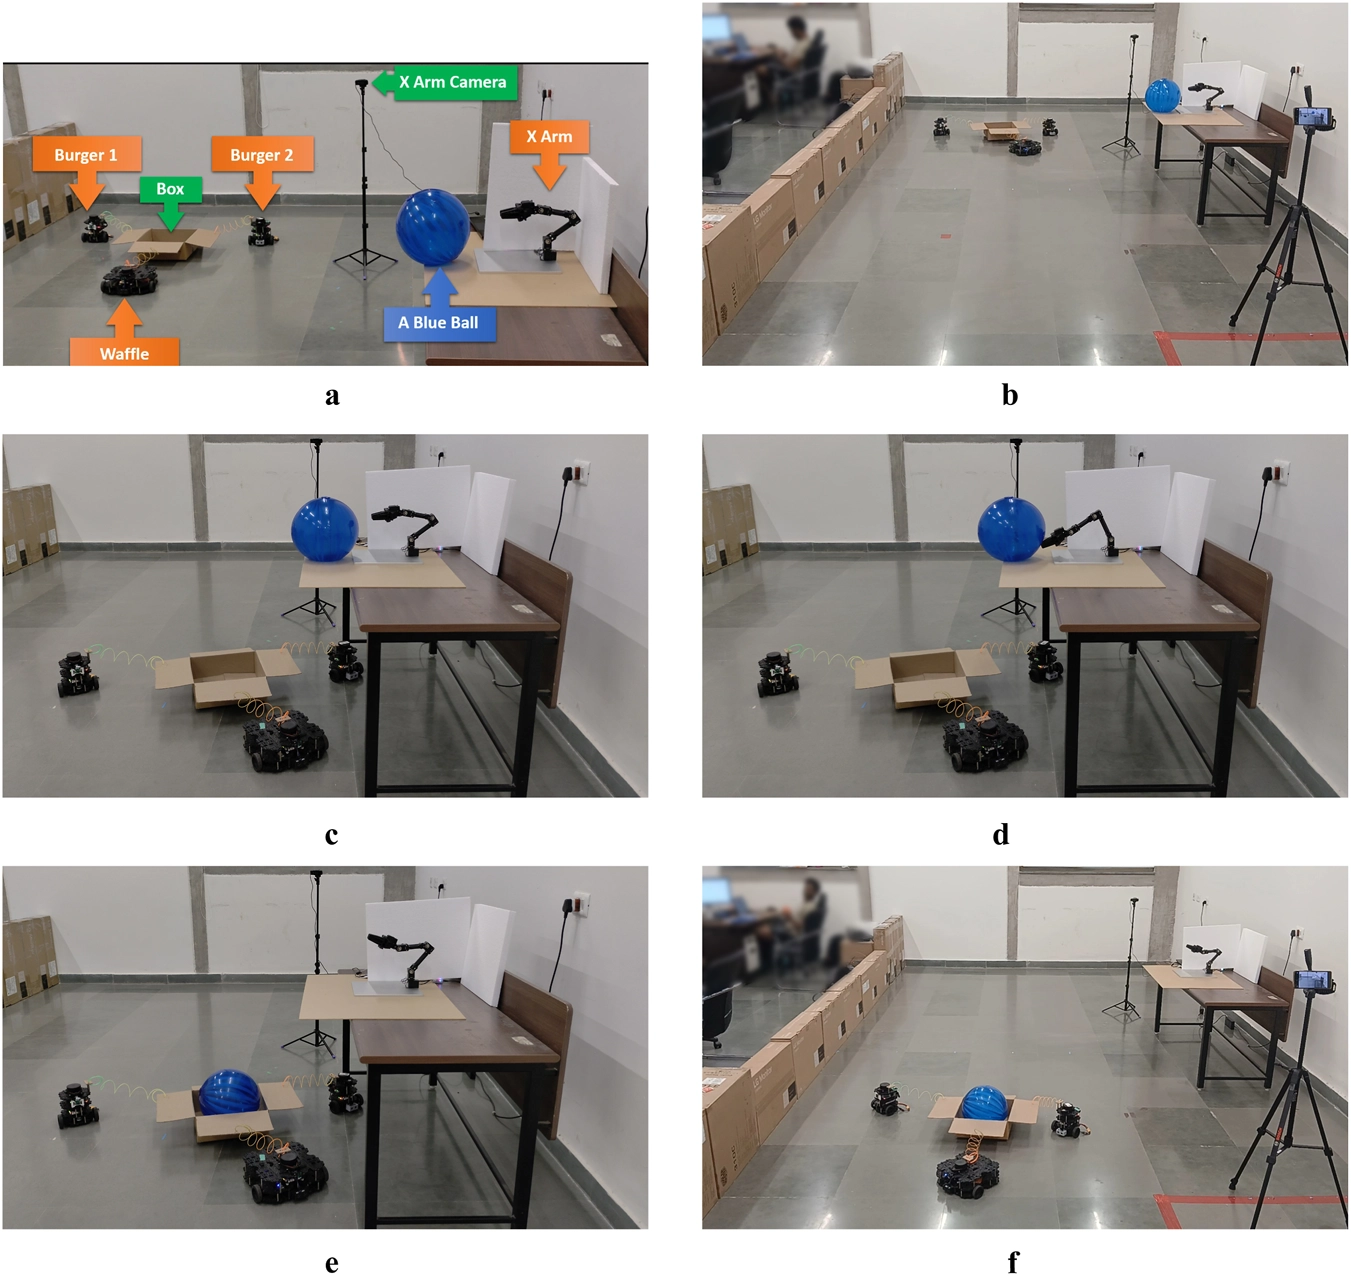
У coordinated transport experiment Waffle та два Burger robots формують групу, яка фізично переносить box. Окремо X-arm повинен скинути blue ball зі столу в box. Manager має синхронізувати formation arrival, manipulator action і delivery до target coordinates.
Successful path пройшов 8/8 trials. Цікавий момент не у тому, що три wheels здатні тягнути cardboard box, а у shared task model: кожний агент має лише частину capabilities, але high-level system повинна бачити team як composite actuator. Це вже справжня multi-agent cybernetics — control object розподілений по кількох bodies.
А якщо синя кулька впала повз коробку — кличемо найуніверсальнішого робота: людину
Автори спеціально змінили geometry, щоб X-arm іноді штовхав blue ball повз box. Camera бачить failure, event визнається relevant, manager запускає replanning. Далі виникає прекрасний момент чесності: жоден доступний robot не має skill, щоб повернути ball у box.
CoMuRoS призначає recovery task user. Людина кладе ball у box, система бачить новий state і formation продовжує delivery. Human-assisted recovery пройшов 5/5 trials. Це виглядає менш «автономно», ніж sci-fi, але значно доросліше: хороший AI має знати межу власних capabilities й уміти організовано попросити допомогу.
Hospital scenario показує, що intention теж може змінитися
У simulation user може сказати щось на кшталт «я голодний». Task manager інтерпретує intent, знає available robots та skills і будує plan. Але людина здатна передумати, environment змінюється, одна task стає непотрібною — event loop має врахувати це так само, як physical obstacle.
Для human-robot systems це принципово. Goal не завжди immutable command, виданий на початку shift. Люди додають context, скасовують прохання, змінюють priority. Система, яка продовжує ідеально виконувати вже непотрібну задачу, формально obedient і практично безглузда.
Disaster relief: drone шукає, quadruped не чекає завершення пошуку
В іншому simulation drone survey area і знаходить survivors. Коли координата з’являється, це relevant event: manager відправляє quadruped із first-aid kit до знайденої людини, а drone продовжує пошук. Tasks переплітаються у event-driven pipeline.
Це хороший приклад, чому rigid plan «спочатку знайти всіх, потім усім допомогти» може бути гіршим. Feedback дозволяє почати корисну action раніше. Cybernetics у практичній формі — не чекати кінця світу, щоб оновити план.
Zero-shot тут має конкретне, не магічне значення
Authors називають architecture generalizable/zero-shot, але пояснюють definition: один і той самий task-manager prompt із правилами coordination застосовують до різних scenarios без scenario-specific fine-tuning або prompt rewrite. Змінюється textual configuration environment і robot capabilities.
Це важливе уточнення. System не заходить у невідому factory взагалі без опису й не телепатично відкриває всі skills. Generalization означає, що framework може перебудувати plan із нового declarative context, не переписуючи core logic вручну під кожний demo.
22 scenarios, 54 tasks і близько 20 robots — benchmark уже не на двох кубиках
Curated benchmark охоплює 22 scenarios, 54 tasks і приблизно 20 robot types/configurations. Authors оцінювали classification, task allocation, executability, correctness та robustness до phrasing і різних LLM backends. Planning correctness у benchmark доходила до 0.91 ± 0.053.
Replanning benchmark містив 20 scenarios; для одного з evaluated backends, Grok 3, reported correctness було 0.948 ± 0.034. Це не означає, що «CoMuRoS правильний у 94,8% будь-яких реальних ситуацій». Це score конкретного curated benchmark — корисний, але не universal safety guarantee.
Чому central + local hierarchy краща за чат, де всі robots сперечаються між собою
Fully decentralized LLM agents виглядають романтично: кожний robot має personality, усі домовляються у dialogue. На scale це перетворюється на token factory. Кількість messages росте, shared state розмивається, а latency стає непередбачуваною.
Central manager тримає team-level picture, а local agents не засмічують його raw execution details. У свою чергу manager не пише кожний motor command. Hierarchy зменшує communication complexity і схожа на human organization не через любов до менеджменту, а тому що abstraction layers — старий добрий спосіб не збожеволіти від complexity.
LLM у control loop створює нові failure modes
Language model недетермінована, може неправильно parse intent, пропустити dependency або generate code, який формально syntactic, але semantically дивний. Authors пом’якшують це constrained primitive skills, execution checks, context, event feedback і separation low-level control — але ризик не зникає.
Для high-stakes robotics потрібні formal safety envelopes, access control, verification generated code, fail-safe states і logs. Якщо manager вирішив, що forklift «може трохи допомогти» поруч із людиною, ніякий красивий benchmark не повинен дозволити цій фантазії стати actuator command.
Чому це одна з найчистіших сучасних історій про кібернетику
CoMuRoS буквально будує loop: goal → plan → action → perception → event relevance → updated state → replan. Людина теж залишається всередині loop, але не як кнопка emergency stop, а як agent із capabilities, до якого system може звернутися за recovery.
Це дуже відрізняється від образу AI як oracle, який один раз видає правильну відповідь. Real intelligence у dynamic world більше схожа на хорошу організацію: ніхто не знає все, кожний виконує свою роль, інформація піднімається нагору лише коли змінює рішення, а план живе до першої зустрічі з реальністю — після чого його треба спокійно переписати.
LLM тут не крутить motors — він керує abstraction level вище: хто що робить, у якому порядку й коли plan треба переписати.
- Central task-manager LLM decomposes natural-language goals і allocates tasks за capabilities.
- Local robot LLMs compose executable actions із primitive ROS2 skills.
- Onboard perception filters relevant/irrelevant events до central replanning.
- Human може стати частиною recovery plan, якщо robots не мають потрібного skill.
Що перевіряли
Curated planning benchmark.
Різні dependencies та robot roles.
Приблизний масштаб heterogeneous configurations.
До 0.91 ±0.053 у planning benchmark.
Як живе plan після натискання Start
Interpret
Task manager читає human goal і available capabilities.
Allocate
Subtasks стають independent, sequential, coordinated або infeasible.
Execute
Robot-level agents викликають constrained ROS2 skills.
Observe
Perception ловить changes/failures та оцінює relevance.
Replan
Relevant event оновлює context і може змінити allocation, sequence або додати human.
Хто за що відповідає
| Рівень | LLM / reasoning | Deterministic robotics |
|---|---|---|
| Team | Goal decomposition, allocation, replanning | Task state / interfaces |
| Robot | Compose known primitive skills | ROS2 actions, checks |
| Motion | Не повинен генерувати raw motor current | Controllers, navigation, kinematics |
| Safety | Reasoning може запропонувати plan | Execution layer має enforce hard limits |
Чому AI-бригадир цікавіший за «один суперробот»
Що означає zero-shot у paper?
Чому local agents потрібні окремо?
Навіщо просити людину, якщо система автономна?
Чому ігнорування event — feature?
Що читати далі
Ще дві теми з цієї серії — щоб не закривати вкладку на найцікавішому.
Джерела та перевірка
- Frontiers in Robotics and AICoMuRoS - An LLM-based generalizable hierarchical task planning and execution framework for heterogeneous robot teams with event-driven re-planning
- CoMuRoS ProjectCoMuRoS project and open-source resources
Читайте більше
Коментарі0 коментарів
Коментарі