
В материале
5 разд.8 сентября 2026 года OpenAI сделала заявление, которое еще несколько лет назад звучало бы как научная фантастика: внутренняя AI-система компании нашла конструкцию, отвечающую на одну из официальных постановок задачи существования и гладкости уравнений Навье—Стокса — одной из семи Millennium Prize Problems.
Компания опубликовала математическое доказательство и его формализацию в Lean. По данным OpenAI, ключевая группа для Navier–Stokes масштабировалась примерно до 10 000 одновременно работающих AI-агентов, результат был получен приблизительно за 88 часов, а агенты обменялись около 2,7 млн сообщений и сгенерировали примерно 130 млрд выходных токенов. Еще около 17 часов ушло на формализацию и машинную проверку в Lean с помощью GPT‑6 Astra.
Само по себе это выглядит как одна из самых масштабных демонстраций AI в фундаментальной науке. Но почти сразу история получила второй сюжет: спор о научном приоритете с математиками Tristan Buckmaster и Levent Alpöge. Поэтому Navier–Stokes внезапно стала не только историей о математике, но и о том, как определять авторство открытий в мире, где одна лаборатория способна за несколько суток запустить тысячи AI-исследователей на одну проблему.
Что именно утверждает OpenAI
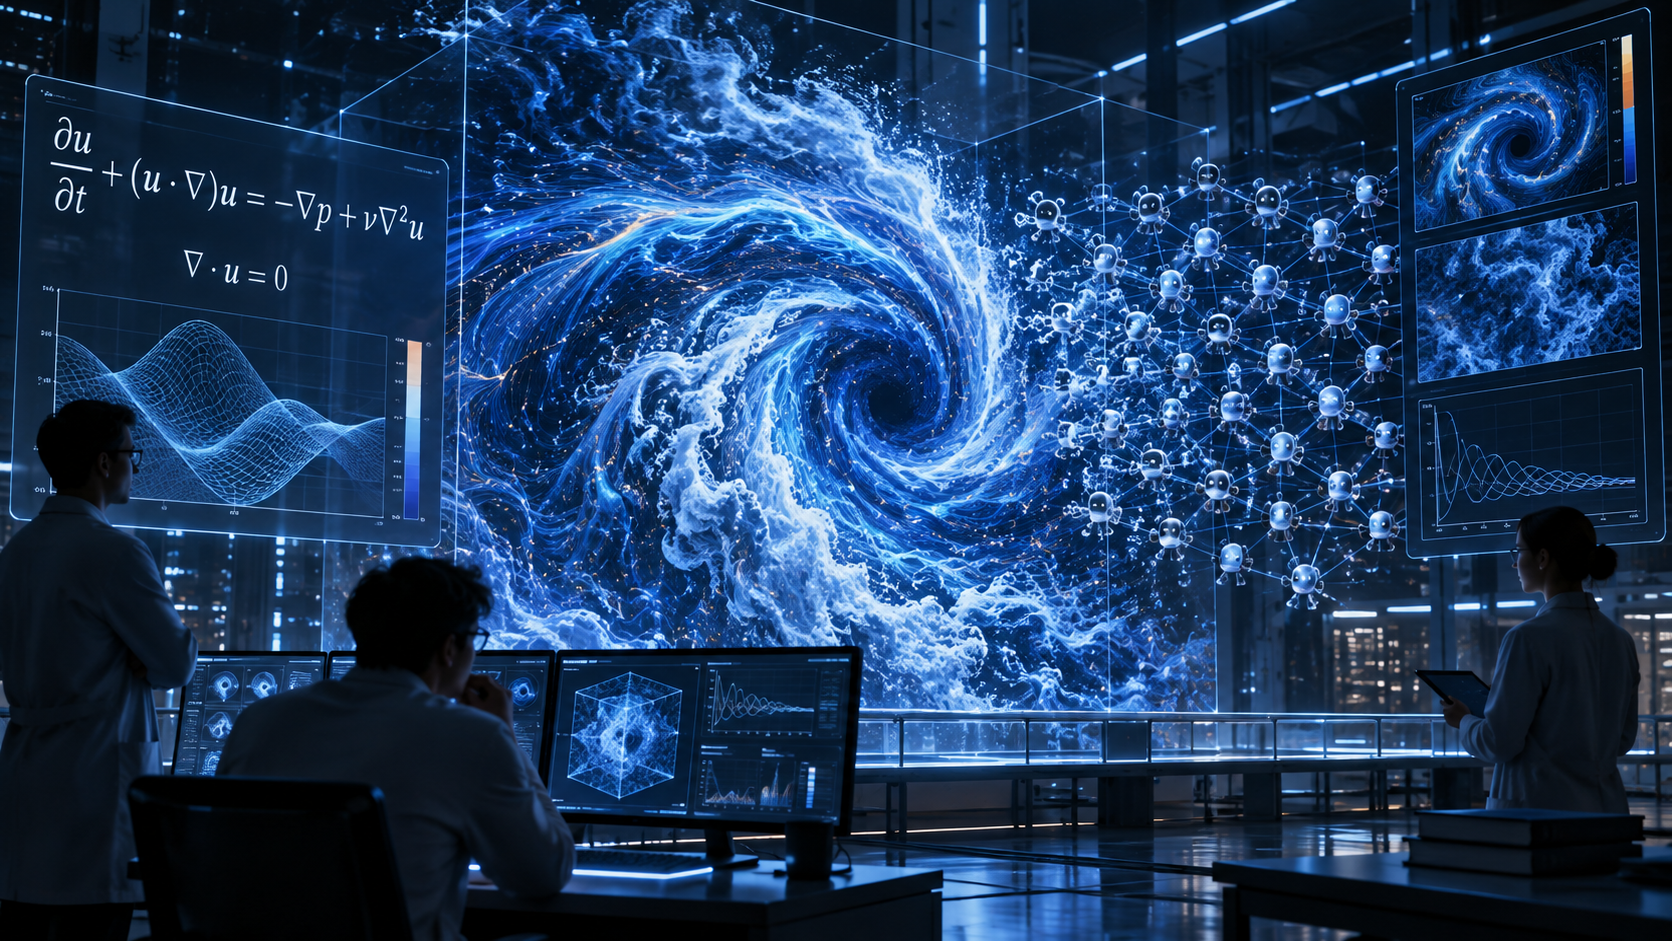
Уравнения Навье—Стокса описывают движение жидкостей и газов. Они лежат в основе аэродинамики, моделей атмосферы, гидродинамики, инженерных расчетов и множества других задач. Однако за их практической пользой скрывается фундаментальная математическая проблема: если начать с достаточно гладкого состояния трехмерной несжимаемой жидкости, останется ли решение гладким навсегда или в определенный момент может возникнуть сингулярность — режим, в котором некоторые величины неограниченно растут за конечное время?
Именно этот вопрос Clay Mathematics Institute в 2000 году включил в семь задач тысячелетия. OpenAI сообщает о контрпримере для вариантов C и D официальной формулировки: в предложенной конструкции жидкость начинает движение из состояния покоя, на нее действует гладкая внешняя сила, суммарная энергия остается конечной, но внутри потока все равно формируется сингулярность.
Компания описывает ее как вихревую структуру, которая все сильнее вытягивается и сжимается к центральной области. Локальная скорость растет, но общая энергия системы не становится бесконечной. Это важное уточнение: фраза «AI решил Navier–Stokes» может создать ошибочное впечатление, будто найдена универсальная формула для любой турбулентности. На самом деле речь идет об очень конкретном фундаментальном вопросе существования гладких решений в постановке Millennium Problem.
10 000 агентов вместо одного чат-бота
Не менее важно то, как был получен результат. OpenAI пишет, что в конце августа начала обучение новой внутренней модели, показавшей чрезвычайно сильные результаты в математике и значительно превосходившей GPT‑6 Astra. В начале сентября лаборатория решила проверить ее на нескольких открытых задачах тысячелетия.
Но это был не один prompt в чате. OpenAI построила многоагентную систему: разные группы получали разные постановки, запускали код, работали с доступными материалами, проверяли гипотезы и передавали полезные находки другим агентам. Сначала около сотни агентов примерно 50 часов работали над родственной проблемой для уравнений Эйлера. Когда появился перспективный путь, ресурсы перебросили на Navier–Stokes.
Группа, давшая финальный результат, масштабировалась примерно до 10 000 параллельных агентов. От запуска до основного результата прошло около 88 часов. Только в работе над Navier–Stokes система обменялась примерно 2,7 млн сообщений и использовала около 130 млрд output tokens; во всех математических экспериментах этого цикла — около 300 млрд.
Это меняет само представление об «AI, который решает задачу». Перед нами не один цифровой собеседник, внезапно выдающий гениальное доказательство, а скорее виртуальный исследовательский институт: тысячи параллельных траекторий, отсев тупиковых направлений, обмен идеями, код, автоматическое обобщение и отдельный слой формальной проверки.
Зачем здесь Lean — и почему проверка еще не закончена
Формализация в Lean особенно важна для результатов такого масштаба. В обычном математическом тексте даже опытный автор может пропустить небольшой, но критический логический разрыв. Proof assistant заставляет разложить утверждение на формальные шаги, которые проверяет компьютер.
Однако между фразами «Lean принял формализацию» и «математическое сообщество окончательно признало Millennium Prize Problem решенной» существует большая дистанция. Независимым специалистам необходимо проверить, формализована ли именно нужная постановка, корректно ли перенесены все аналитические предпосылки и нет ли разрыва между интуитивным описанием конструкции и тем, что реально доказано в формальной системе.
OpenAI отдельно заявляет, что не претендует на $1 млн Millennium Prize. Это тоже показательный момент: компания отделяет публикацию результата от официальной процедуры признания, которая по правилам Clay Mathematics Institute требует времени и независимой проверки.
Спор о научном приоритете
Параллельно над родственными вопросами работали Tristan Buckmaster из NYU и Levent Alpöge из Anthropic. После анонса OpenAI возникли вопросы о том, когда именно компания узнала об их прогрессе и повлиял ли этот сигнал на решение резко масштабировать вычисления в том же направлении.
По сообщению WIRED, Buckmaster и Alpöge высказали претензии к тому, как лаборатория коммуницировала вопрос приоритета. OpenAI отрицает использование их неопубликованной работы и утверждает, что ее исследователи и агенты не видели доказательств коллег до публичного релиза. Поэтому сейчас корректно говорить именно о споре и разных версиях сторон, а не об установленном факте неправомерного заимствования.
Именно здесь начинается вопрос, который потенциально важнее одной задачи. Как определять авторство, если AI обучается на огромном количестве человеческой работы, а затем самостоятельно комбинирует идеи и генерирует новые результаты? Где проходит граница между общим обучением, косвенным влиянием предыдущих взаимодействий и использованием конкретной неопубликованной идеи? И как будет работать научный приоритет, если одна AI-лаборатория способна за несколько суток направить 10 000 агентов на проблему, над которой человеческое сообщество работало десятилетиями?
Даже если независимая проверка впоследствии обнаружит проблему в доказательстве, сама демонстрация многоагентной исследовательской системы уже важна. Научное исследование начинает превращаться в масштабируемый вычислительный процесс. Поэтому после этого анонса самый интересный вопрос звучит уже не «какую задачу AI решит следующей», а как изменится сама наука, когда 10 000 цифровых исследователей можно будет запускать на одну проблему почти так же, как сегодня запускают вычислительный кластер.
Это не «формула всей турбулентности», а результат для конкретной постановки Millennium Problem.
- OpenAI сообщает о контрпримере для вариантов C и D официальной постановки.
- Финальная независимая научная проверка еще необходима.
- Отдельный сюжет — спор о приоритете с другими математиками.
Ключові цифри
Порядок одновременно задействованных агентов в ключевой группе.
Время от запуска соответствующего этапа до основного результата.
Оценочный объем генерации агентов в Navier–Stokes run.
Источники и проверка
- OpenAINavier–Stokes solution
- WIREDOpenAI Says Its AI Solved a Millennium Prize Math Problem. Mathematicians Are Raising Questions

Комментарии0 комментариев
Комментарии