
У матеріалі
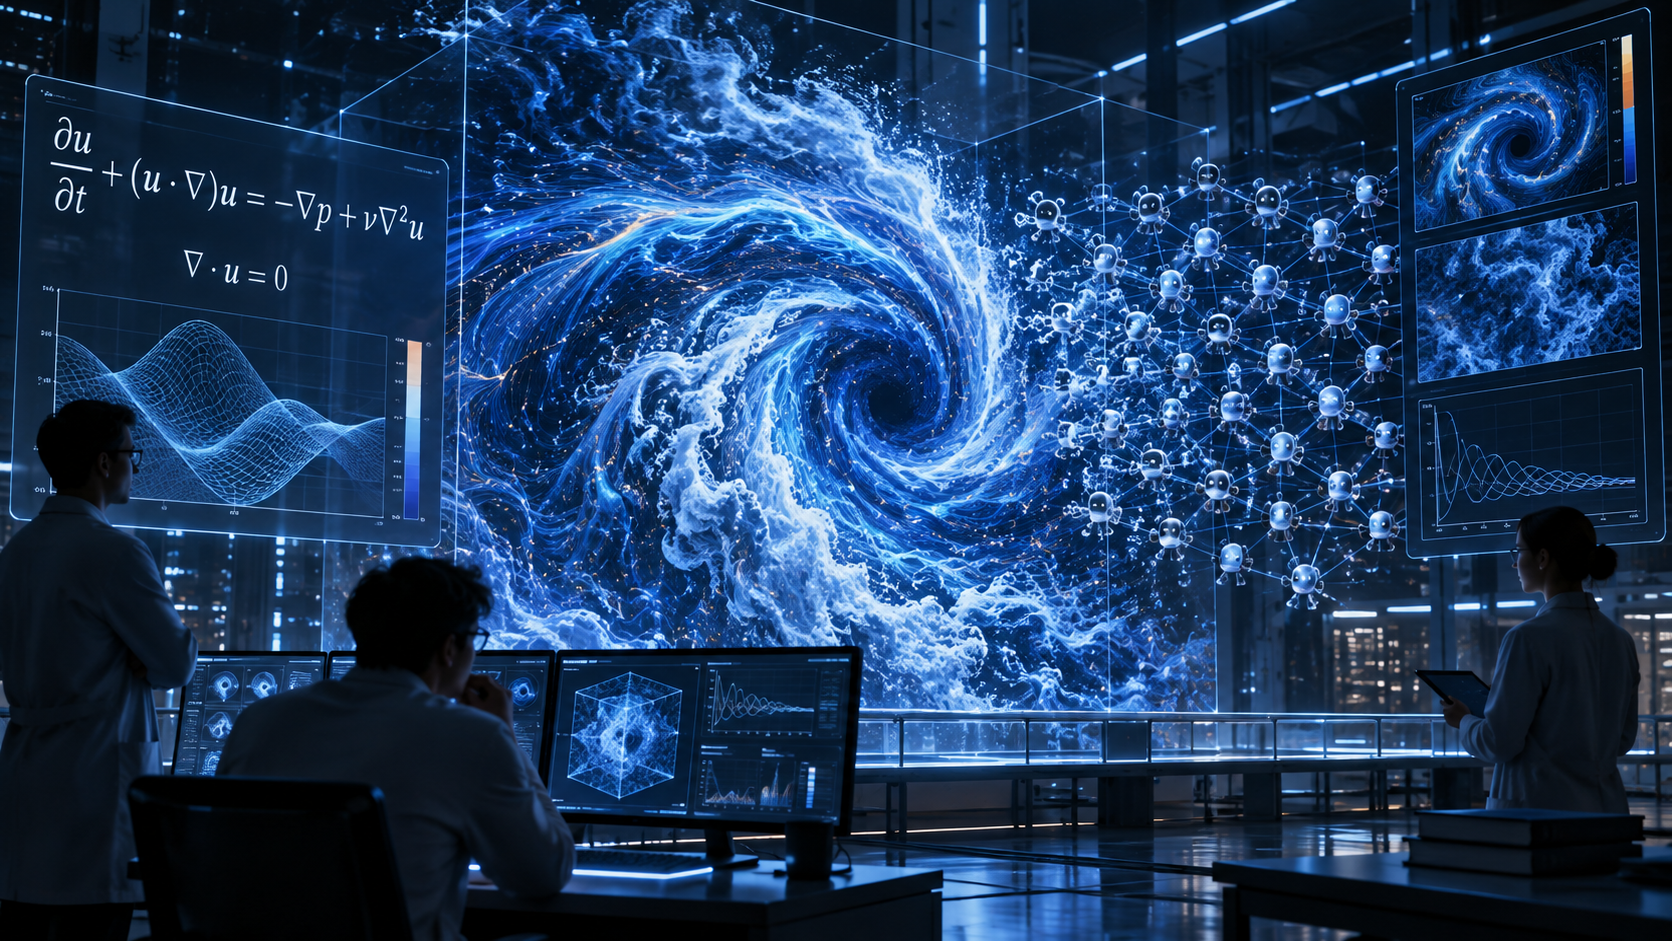
5 розд.8 вересня 2026 року OpenAI зробила заяву, яка ще кілька років тому звучала б як наукова фантастика: внутрішня AI-система компанії знайшла конструкцію, що відповідає на одну з офіційних постановок задачі існування та гладкості рівнянь Нав’є—Стокса — однієї із семи Millennium Prize Problems.
Компанія опублікувала математичний доказ і його формалізацію в Lean. За даними OpenAI, ключова група для Navier–Stokes масштабувалася до порядку 10 000 одночасно працюючих AI-агентів, результат було отримано приблизно за 88 годин, а агенти обмінялися близько 2,7 млн повідомлень і згенерували приблизно 130 млрд вихідних токенів. Ще близько 17 годин пішло на формалізацію та машинну перевірку в Lean за допомогою GPT‑6 Astra.
Це вже саме по собі виглядає як одна з наймасштабніших демонстрацій AI у фундаментальній науці. Але майже одразу історія отримала другий сюжет: суперечку навколо наукового пріоритету з математиками Tristan Buckmaster і Levent Alpöge. Через це Navier–Stokes раптом стала не лише історією про математику, а й про те, як визначати авторство відкриттів у світі, де одна лабораторія може за кілька діб запустити тисячі AI-дослідників на одну проблему.
Що саме стверджує OpenAI
Рівняння Нав’є—Стокса описують рух рідин і газів. Вони лежать в основі аеродинаміки, моделей атмосфери, гідродинаміки, інженерних розрахунків і багатьох інших задач. Проте за їхньою практичною користю ховається фундаментальна математична проблема: якщо почати з достатньо гладкого стану тривимірної нестисливої рідини, чи залишатиметься розв’язок гладким завжди, або в певний момент може виникнути сингулярність — режим, у якому деякі величини необмежено зростають за скінченний час?
Саме це питання Clay Mathematics Institute у 2000 році включив до семи задач тисячоліття. OpenAI повідомляє про контрприклад для варіантів C і D офіційного формулювання: у запропонованій конструкції рідина починає рух зі спокою, на неї діє гладка зовнішня сила, сумарна енергія залишається скінченною, але всередині потоку все одно формується сингулярність.
Компанія описує її як вихрову структуру, яка дедалі сильніше витягується й стискається до центральної області. Швидкість руху локально зростає, але загальна енергія системи не стає нескінченною. Це важливе уточнення: фраза «AI розв’язав Navier–Stokes» може створити хибне враження, ніби знайдено універсальну формулу для будь-якої турбулентності. Насправді йдеться про дуже конкретне фундаментальне питання існування гладких розв’язків у постановці Millennium Problem.
10 000 агентів замість одного чат-бота
Не менш важливо те, як отримано результат. OpenAI пише, що наприкінці серпня почала навчання нової внутрішньої моделі, яка показувала надзвичайно сильні результати в математиці й була значно потужнішою за GPT‑6 Astra. На початку вересня лабораторія вирішила протестувати її на кількох відкритих задачах тисячоліття.
Але це не був один prompt у чаті. OpenAI побудувала багатoагентну систему: різні групи отримували різні постановки, запускали код, працювали з доступними матеріалами, перевіряли гіпотези та передавали корисні знахідки іншим агентам. Спочатку близько сотні агентів приблизно 50 годин працювали над спорідненою проблемою для рівнянь Ейлера. Коли з’явився перспективний напрям, ресурси перекинули на Navier–Stokes.
Група, що дала фінальний результат, масштабувалася приблизно до 10 000 паралельних агентів. Від запуску до основного результату минуло близько 88 годин. Лише в процесі роботи над Navier–Stokes система обмінялася приблизно 2,7 млн повідомлень і використала близько 130 млрд output tokens; у всіх математичних експериментах цього циклу — близько 300 млрд.
Це змінює саме уявлення про «AI, який вирішує задачу». Перед нами не один цифровий співрозмовник, що раптом видає геніальний доказ, а радше віртуальний дослідницький інститут: тисячі паралельних траєкторій, відсіювання тупикових напрямків, взаємний обмін ідеями, код, автоматичне узагальнення та окремий шар формальної перевірки.
Навіщо тут Lean — і чому це ще не кінець перевірки
Формалізація в Lean особливо важлива для результатів такого масштабу. У звичайному математичному тексті навіть досвідчений автор може пропустити невеликий, але критичний логічний розрив. Proof assistant змушує розкласти твердження на формальні кроки, які перевіряє комп’ютер.
Проте між фразами «Lean прийняв формалізацію» та «математична спільнота остаточно визнала Millennium Prize Problem розв’язаною» є велика дистанція. Незалежним фахівцям потрібно перевірити, чи формалізовано саме потрібну постановку, чи коректно перенесено всі аналітичні передумови і чи немає розриву між інтуїтивним описом конструкції та тим, що реально доведено у формальній системі.
OpenAI окремо заявляє, що не претендує на $1 млн Millennium Prize. Це теж показовий момент: компанія намагається відокремити публікацію результату від офіційної процедури визнання, яка за правилами Clay Mathematics Institute потребує часу та незалежної перевірки.
Суперечка за науковий пріоритет
Паралельно над спорідненими питаннями працювали Tristan Buckmaster з NYU та Levent Alpöge з Anthropic. Після анонсу OpenAI виникли питання про те, коли саме компанія дізналася про їхній прогрес і чи вплинув цей сигнал на рішення різко масштабувати обчислення в тому самому напрямку.
За повідомленням WIRED, Buckmaster і Alpöge висловили претензії щодо того, як лабораторія комунікувала питання пріоритету. OpenAI заперечує використання їхньої неопублікованої роботи й стверджує, що її дослідники та агенти не бачили доказів колег до публічного релізу. Тому наразі коректно говорити саме про суперечку й різні версії сторін, а не про встановлений факт неправомірного запозичення.
Саме тут починається питання, яке потенційно важливіше за одну задачу. Як визначати авторство, якщо AI навчається на величезній кількості людської роботи, а потім самостійно комбінує ідеї й генерує нові результати? Де проходить межа між загальним навчанням, непрямим впливом попередніх взаємодій і використанням конкретної неопублікованої ідеї? І як працюватиме науковий пріоритет, якщо одна AI-лабораторія може за кілька діб спрямувати 10 000 агентів на проблему, над якою людська спільнота працювала десятиліттями?
Навіть якщо незалежна перевірка згодом знайде проблему в доказі, сама демонстрація багатoагентної дослідницької системи вже важлива. Наукове дослідження починає перетворюватися на масштабований обчислювальний процес. Тому після цього анонсу найцікавіше питання звучить уже не «яку задачу AI розв’яже наступною», а як зміниться сама наука, коли 10 000 цифрових дослідників можна буде запускати на одну проблему майже так само, як сьогодні запускають обчислювальний кластер.
Це не «формула всієї турбулентності», а результат для конкретної постановки Millennium Problem.
- OpenAI повідомляє про контрприклад для варіантів C і D офіційної постановки.
- Фінальний незалежний науковий розгляд ще потрібен.
- Окремий сюжет — суперечка щодо пріоритету з іншими математиками.
Ключові цифри
Порядок одночасно задіяних агентів у ключовій групі.
Час від запуску відповідного етапу до основного результату.
Орієнтовний обсяг генерації агентів у Navier–Stokes run.
Джерела та перевірка
- OpenAINavier–Stokes solution
- WIREDOpenAI Says Its AI Solved a Millennium Prize Math Problem. Mathematicians Are Raising Questions

Коментарі0 коментарів
Коментарі