
В материале
15 разд.Представьте лабораторию, где исследователь не открывает по очереди PubMed, десяток биоинформатических сервисов, Python-ноутбук, таблицу с пациентами и протокол для мокрой лаборатории. Вместо этого он формулирует задачу обычным языком: найти вероятный причинный ген, предложить способ проверки, проанализировать данные и подготовить эксперимент. Дальше часть этой рутины берет на себя AI-агент. Именно такую идею реализует Biomni — система, которую команда из Stanford и партнерских организаций описала в Science. Она интересна не тем, что «еще лучше отвечает на вопросы», а тем, что пытается выполнять целый исследовательский workflow: планировать, искать инструменты, писать код, работать с базами данных и формировать проверяемые экспериментальные шаги.
Biomni — не медицинский чатбот
Самая простая ошибка — поставить Biomni в один ряд с чатботами, пересказывающими медицинскую литературу. Авторы называют ее general-purpose biomedical AI agent. То есть языковая модель здесь лишь один компонент. Система сочетает reasoning, retrieval-augmented planning и выполнение кода, а также работает со специализированными инструментами, базами данных и протоколами.
Разница принципиальна. Обычная модель может сказать: «для такого анализа стоит использовать инструмент X». Агентный подход пытается сделать следующий шаг: построить план, вызвать нужный инструмент, подготовить входные данные, проверить промежуточный результат, а затем использовать его в следующей части workflow. В удачном сценарии исследователь получает не красивый текст, а воспроизводимую цепочку действий.
Почему биомедицине вообще нужен такой агент
Современная биомедицина парадоксальна. Данных и программных инструментов стало невероятно много, но сама работа часто остается фрагментированной. Генетик использует одну базу, специалист по single-cell RNA-seq — другой стек, молекулярный биолог — отдельные протоколы, клинический исследователь — еще один набор систем. Большая доля времени уходит не на новое научное вопрос, а на «склеивание» компонентов.
Именно это пытается атаковать Biomni. Ее action-discovery компонент, по описанию авторов, анализировал инструменты, базы и протоколы из тысяч публикаций и сформировал единое агентное окружение для 25 биомедицинских направлений. Stanford AI Index 2026 дополнительно описывает масштаб среды: 150 специализированных инструментов, 105 программных пакетов и 59 баз данных. Эти цифры не нужно читать как рейтинг «интеллекта». Их ценность — в ширине набора, который агент может комбинировать под конкретную задачу.
Как работает цикл «вопрос → план → код → результат»
В упрощенном виде workflow Biomni можно представить как несколько повторяющихся шагов. Исследователь задает вопрос. Агент разбивает его на подзадачи, извлекает релевантный контекст, выбирает инструменты, генерирует или запускает код, читает промежуточные результаты и корректирует следующие шаги. Это гораздо ближе к работе технического ассистента в лаборатории, чем к одноразовому prompt-response.
Ключевое слово — динамически. Авторы подчеркивают, что Biomni не полагается только на заранее прописанные шаблоны под каждую задачу. Она должна собирать workflow под проблему. Именно такая гибкость делает агентов интересными для науки: реальный эксперимент редко идеально соответствует одному стандартному tutorial.
Что система уже умеет
В статье Science перечислен широкий набор задач: приоритизация причинных генов, drug repurposing, диагностика редких заболеваний, анализ микробиома, molecular cloning и другие сценарии. В отдельных реальных кейсах Biomni работала с мультимодальными данными, оптимизацией стабильности белков, лабораторными инструментами и созданием протоколов, которые можно проверять экспериментально.
Это важнее демонстрации на одном красивом benchmark. Биомедицина состоит из очень разных типов работы: чтение литературы, статистика, программирование, физический эксперимент. Агент, претендующий на универсальность, должен не только знать терминологию, но и переходить между этими режимами.
Benchmark почти на уровне эксперта — и почему это не означает «AI стал биологом»
В более ранней полной версии исследования авторы приводили показательный результат на подмножестве LAB-Bench DbQA: около 74,4% accuracy у Biomni против примерно 74,7% у эксперта-человека; более простой ReAct+Code baseline был существенно ниже. Цифра эффектная, но ее легко прочитать неправильно.
Benchmark измеряет определенный набор задач в определенном формате. Он не проверяет способность выбрать действительно важную научную проблему, заметить плохо поставленный эксперимент, распознать скрытый confounder или понять, что статистически красивый результат биологически бессмысленен. Наука — это не одна таблица accuracy. Корректный вывод скромнее: агент уже способен конкурировать с людьми на части сложных инструментальных задач, но это не доказательство полной автономности ученого.
Самое интересное начинается там, где AI касается мокрой лаборатории
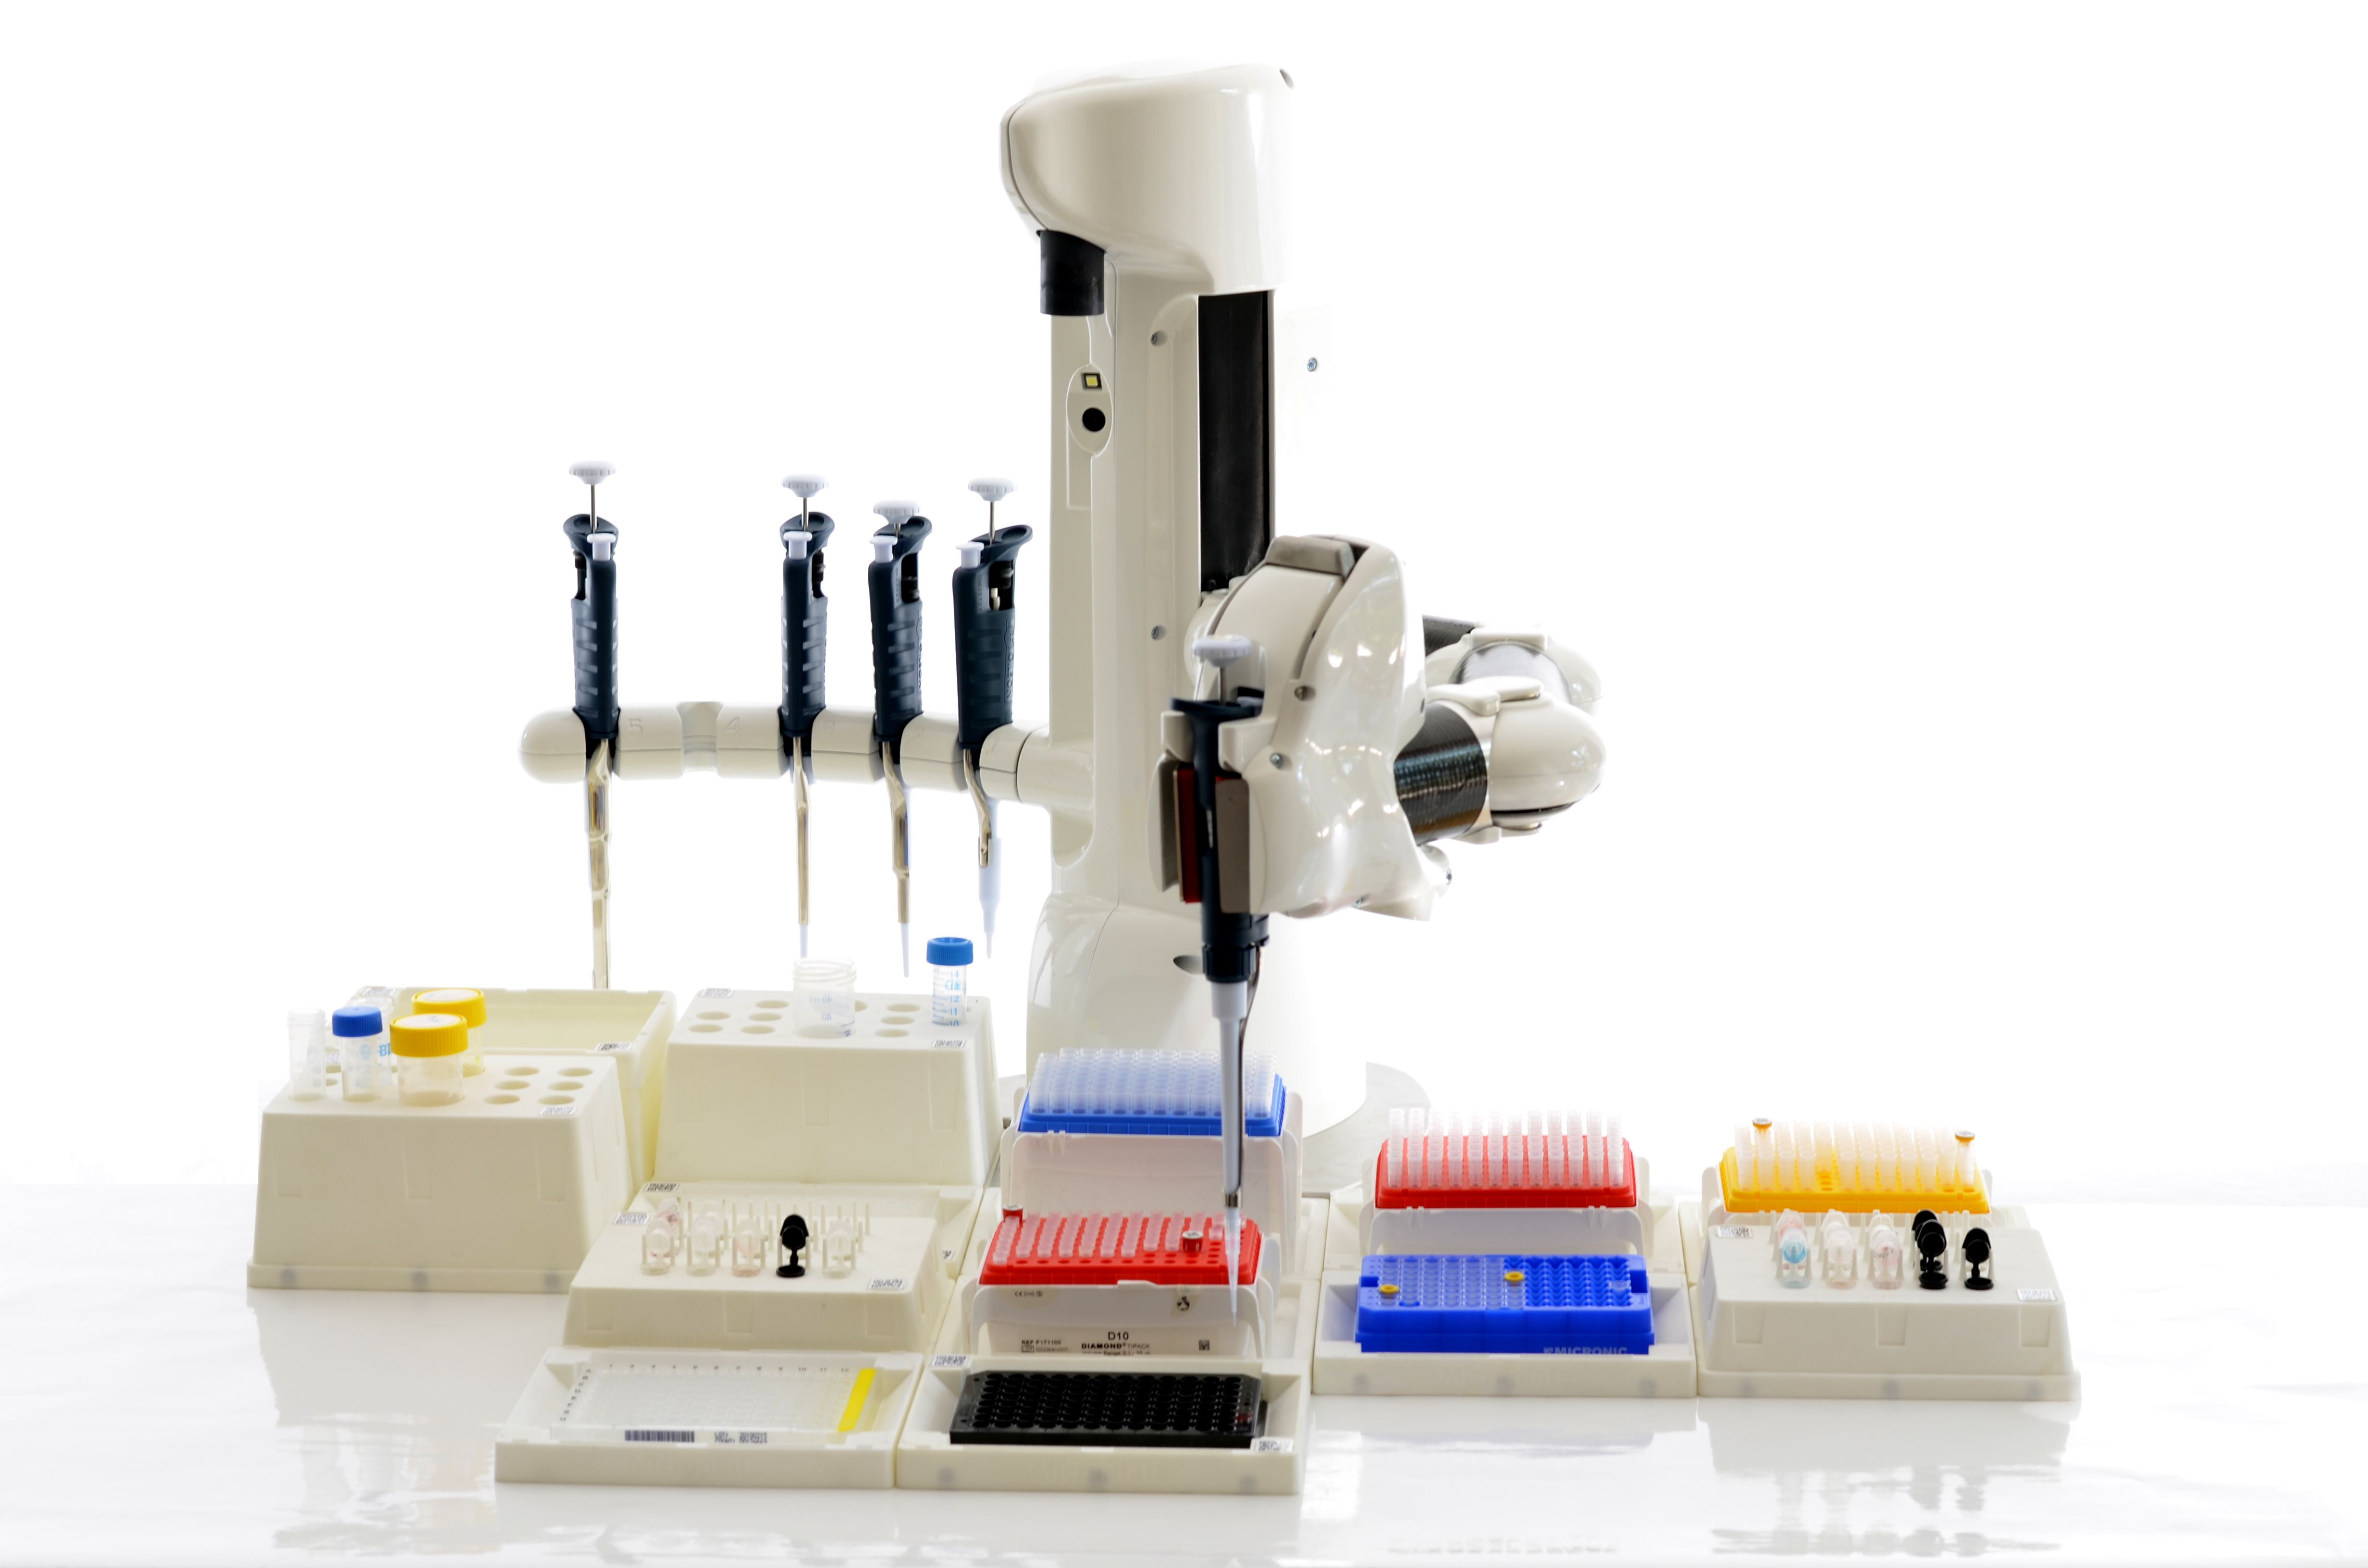
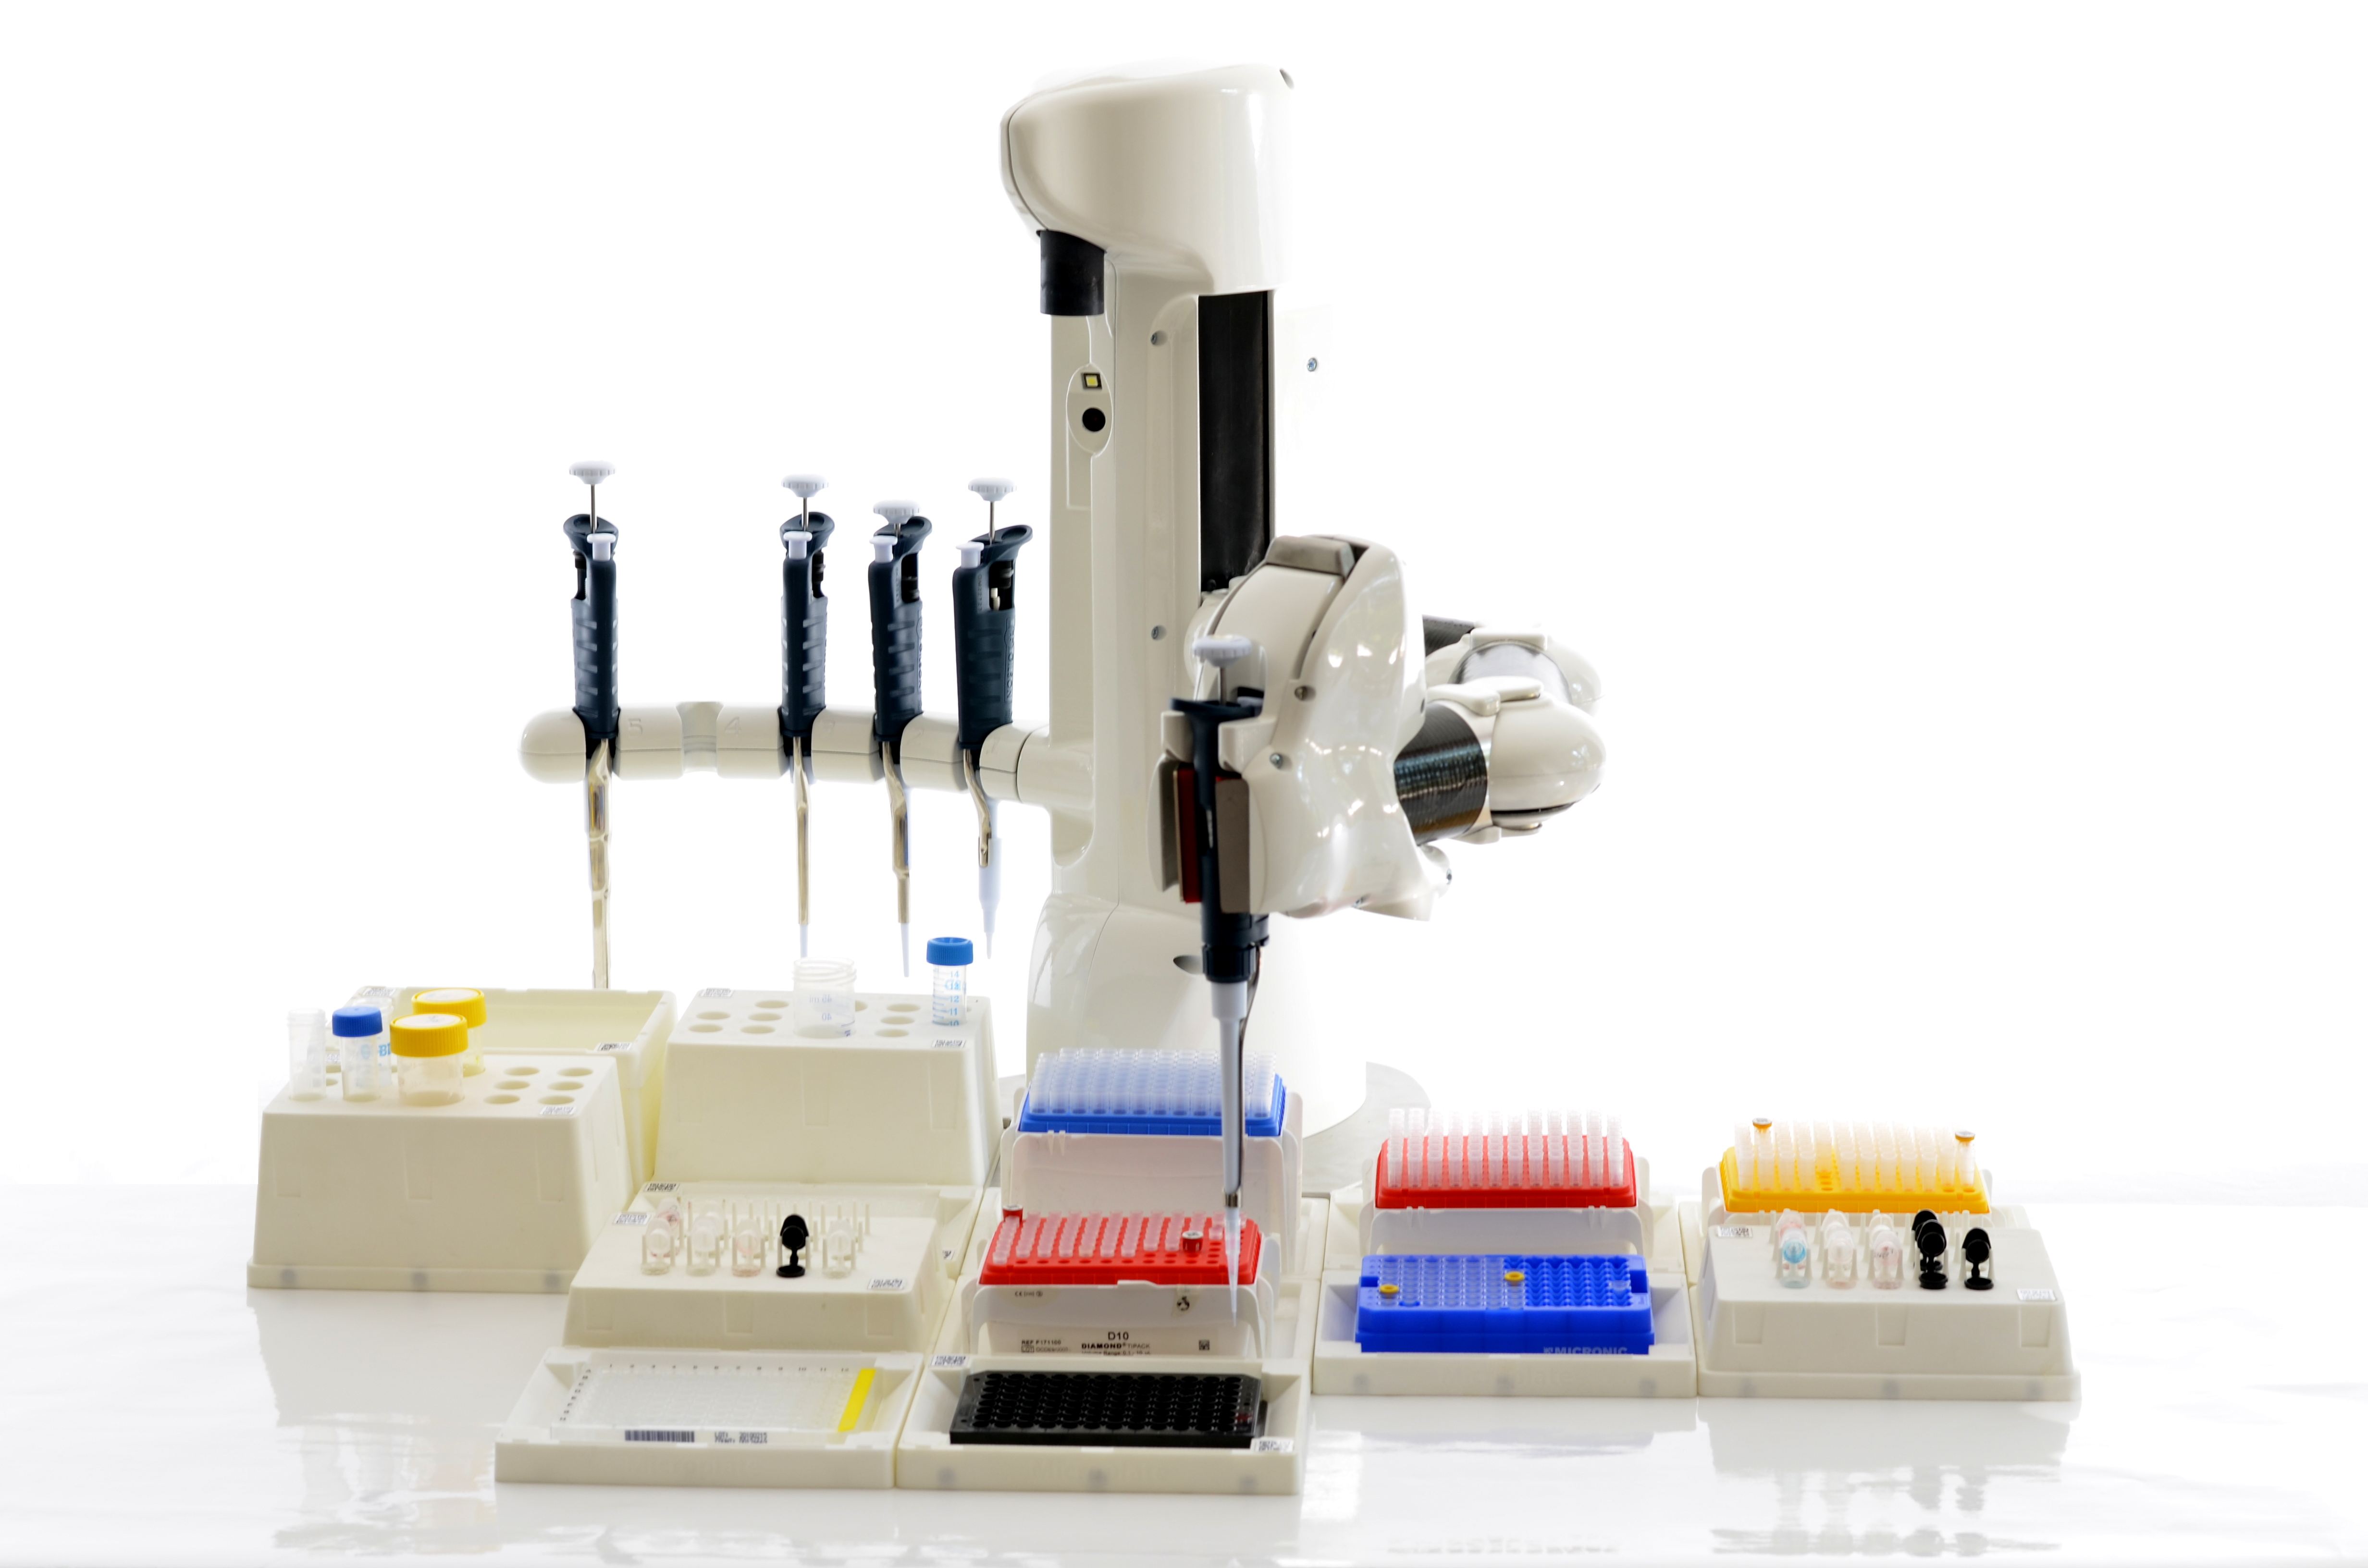
Когда агент только анализирует открытый датасет, ошибка часто стоит времени. Когда он формирует protocol или взаимодействует с лабораторным оборудованием, ошибка может стоить дорогих реагентов, испорченной серии измерений и недель работы. Поэтому упоминание orchestration wet-lab instruments в Science — не просто эффектный пункт capabilities. Это граница, после которой надежность становится физически ощутимой.
В таких системах необходимы журналы всех действий, контроль версий инструментов и баз, sandbox для выполнения кода, белые списки допустимых операций, provenance каждого промежуточного результата и возможность независимо воспроизвести workflow. Иначе «автономность» быстро превращается в сложную ошибку, которую никто не может реконструировать.
Галлюцинация в науке дороже галлюцинации в чате
Если обычный чатбот выдумает название книги, пользователь может быстро это заметить. В биомедицинском workflow ошибка может спрятаться в коде, неверно выбранном reference genome, несовместимой версии пакета, путанице единиц измерения или неправильно примененном статистическом тесте. Результат при этом способен выглядеть очень убедительно.
Поэтому для научных агентов важны не только «умные ответы», но и механизмы верификации. Система должна показывать источники, параметры, код, версии, причины выбора метода и неопределенность. Чем больше действий агент выполняет самостоятельно, тем сильнее должен быть его audit trail.
Может ли Biomni сильнее помочь маленьким лабораториям
Одна из самых интересных возможностей — демократизация сложных инструментов. Большая фармкомпания может нанять отдельных bioinformatics engineers, statisticians и data scientists. Небольшая академическая группа часто не может. Если агент действительно снижает барьер входа в сложный анализ, самый большой относительный выигрыш могут получить команды, где один человек сегодня вынужден совмещать пять ролей.
Это не делает экспертизу ненужной. Наоборот: агент снимает часть рутины, но решение «имеет ли этот результат биологический смысл?» остается доменной работой. Лучший сценарий — не лаборатория без людей, а лаборатория, где ученые меньше времени тратят на установку пакетов и ручное преобразование форматов и больше — на гипотезы, дизайн экспериментов и критическое мышление.
Biomni похожа на раннюю «операционную систему лаборатории»
Сегодня научные AI-агенты часто выглядят как надстройка над языковой моделью. Но логика развития подсказывает другой образ. Если одна система знает доступные базы, инструменты, протоколы, вычислительные ресурсы, лабораторных роботов и историю эксперимента, она начинает напоминать orchestration layer — своеобразную операционную систему между человеком и научной инфраструктурой.
Именно здесь может появиться долгосрочная ценность. Модель под капотом можно заменить. Отдельный инструмент тоже. А среда, которая знает, как безопасно связать их в воспроизводимый процесс, накапливает другую форму преимущества: стандартизированные workflows, provenance и интеграции.
Что пока не доказано
Авторы сами указывают, что оцененные задачи — лишь часть биомедицины и важные домены остаются непроверенными. Это существенное ограничение. Публикация в Science повышает уровень доказательности, но не означает, что агента уже можно без контроля помещать в любую клиническую или исследовательскую систему.
Нужны независимые повторные оценки, stress tests на плохих данных, проверки reproducibility, моделирование failure modes и сравнение не только с другими AI, но и с реальными научными командами на полных проектах. Особенно интересный показатель — не «сколько правильных ответов», а сколько времени и денег агент экономит до момента получения валидированного экспериментального результата.
Заменит ли это ученого
Ближайший реалистичный ответ — нет, но распределение работы изменится. В науке много механических шагов, подходящих для автоматизации: поиск релевантных ресурсов, переформатирование данных, запуск типовых анализов, первичная визуализация, подготовка набора гипотез. И есть этапы, где контекст, скепсис и ответственность критичны.
Поэтому более сильная метафора для Biomni — не «AI-ученый, который уволит лабораторию», а очень быстрый технический сотрудник, которому можно поручить значительную часть инструментальной работы, но результаты которого необходимо проверять. Если эта модель окажется стабильной, она способна изменить темп исследований и без фантастического сценария полностью автономной науки.
Почему эта работа важна именно сейчас
2024–2025 годы показали, что LLM хорошо справляются с текстом и кодом. Следующий этап — агенты, которые не просто генерируют ответ, а взаимодействуют с внешним миром. Биомедицина — один из самых сложных тестов этой идеи: здесь огромное количество инструментов, дорогие ошибки и высокая цена воспроизводимости.
Biomni переводит дискуссию с «может ли AI объяснить биологию?» на практический вопрос: «может ли он связать десятки профессиональных инструментов в полезный и проверяемый workflow?». Ответ пока не окончательный, однако публикация в Science показывает, что это уже больше, чем демонстрация на одном игрушечном benchmark.
За чем следить дальше
Главные сигналы ближайших лет — независимые replication studies, работа в реальных мокрых лабораториях, стандарты аудита для agentic science и общие форматы provenance. Если разные агенты смогут повторить один workflow на одинаковых данных и получить согласованный результат, это будет важнее очередного рекорда benchmark.
И если научный AI действительно станет инфраструктурой, революция может выглядеть очень буднично: аспирант формулирует хороший вопрос вечером, а утром получает не «ответ чатбота», а документированный набор анализов, код, источники, варианты эксперимента и список мест, где система сама не уверена. Именно такая автоматизация способна ускорить науку, не подменяя ее.
Biomni — не еще один медицинский чатбот. Разбираем AI-агента из Science, который работает с 25 биомедицинскими направлениями, пишет код, комбинирует инструменты и формирует экспериментальные протоколы.
- Biomni — general-purpose biomedical AI agent, а не обычный чатбот.
- Action-discovery среда охватывает 25 биомедицинских направлений.
- Система сочетает LLM reasoning, retrieval-augmented planning и выполнение кода.
- В кейсах агент работал с генами, drug repurposing, rare disease, microbiome, cloning и wet-lab workflows.
- Главное ограничение — результаты требуют проверки, provenance и независимой валидации.
Ключевые цифры
Единая агентная среда.
По Stanford AI Index 2026.
Benchmark в ранней полной версии.
DOI 10.1126/science.adz4351.
Вопросы и ответы
Что такое Biomni?
Чем он отличается от ChatGPT?
Может ли Biomni работать с лабораторией?
Заменяет ли это ученого?
Источники и проверка
- ScienceAutonomous biomedical research with an artificial intelligence agent
- PubMedAutonomous biomedical research with an artificial intelligence agent
- Stanford University / EurekAlertMeet Biomni – an AI-powered biomedical co-scientist
- Stanford HAIAI Index Report 2026 — Medicine
- Wikimedia CommonsAutomated pipetting system using manual pipettes.jpg
Комментарии0 комментариев
Комментарии