
У матеріалі
15 розд.Уявіть лабораторію, де дослідник не відкриває по черзі PubMed, десяток біоінформатичних сервісів, Python-ноутбук, таблицю з пацієнтами і протокол для мокрої лабораторії. Замість цього він формулює задачу звичайною мовою: знайти ймовірний причинний ген, запропонувати спосіб перевірки, проаналізувати дані та підготувати експеримент. Далі частину цієї рутини бере на себе AI-агент. Саме таку ідею реалізує Biomni — система, яку команда зі Stanford та партнерських організацій описала у Science. Її цікавість не в тому, що вона «ще краще відповідає на питання», а в тому, що вона намагається виконувати цілий дослідницький workflow: планувати, шукати інструменти, писати код, працювати з базами даних і формувати перевірювані експериментальні кроки.
Biomni — не медичний чатбот
Найпростіша помилка — поставити Biomni в один ряд із чатботами, які переказують медичну літературу. Автори описують її як general-purpose biomedical AI agent. Тобто мовна модель тут лише один компонент. Система поєднує reasoning, retrieval-augmented planning і виконання коду, а також має доступ до спеціалізованих інструментів, баз даних і протоколів.
Різниця принципова. Звичайна модель може сказати: «для такого аналізу варто використати інструмент X». Агентний підхід намагається зробити наступний крок: побудувати план, викликати відповідний інструмент, підготувати вхідні дані, перевірити результат, а потім використати його в наступній частині workflow. У хорошому сценарії дослідник отримує не красиву відповідь, а відтворюваний ланцюжок дій.
Чому біомедицині взагалі потрібен такий агент
Сучасна біомедицина парадоксальна. Даних і програмних інструментів стало неймовірно багато, але сама робота часто залишається фрагментованою. Генетик використовує одну базу, фахівець із single-cell RNA-seq — інший стек, молекулярний біолог — окремі протоколи, а клінічний дослідник — ще один набір систем. Значна частина часу витрачається не на формулювання нового питання, а на «склеювання» цих компонентів.
Саме це намагається атакувати Biomni. Її action-discovery компонент, за описом авторів, аналізував інструменти, бази та протоколи з тисяч публікацій і сформував єдине агентне середовище для 25 біомедичних напрямів. Stanford AI Index 2026 додатково описує масштаб середовища: 150 спеціалізованих інструментів, 105 програмних пакетів і 59 баз даних. Важливо не сприймати ці числа як «магічний рейтинг інтелекту». Їхня цінність у ширині інструментарію, який агент може комбінувати під конкретну задачу.
Як працює цикл «питання → план → код → результат»
У спрощеному вигляді workflow Biomni можна уявити як кілька повторюваних кроків. Дослідник задає питання. Агент розкладає його на підзадачі, дістає релевантний контекст, обирає інструменти, генерує або запускає код, читає проміжний результат і коригує наступні кроки. Це набагато ближче до роботи асистента в лабораторії, ніж до одноразового prompt-response.
Ключове слово тут — динамічно. Автори наголошують, що Biomni не покладається лише на наперед записані шаблони для кожної задачі. Вона повинна складати workflow під проблему. Саме ця гнучкість і робить агентів цікавими для науки: реальний експеримент рідко ідеально відповідає одному стандартному tutorial.
Що вона вже вміє робити
У статті Science наведений широкий набір тестів: пріоритизація причинних генів, drug repurposing, діагностика рідкісних захворювань, аналіз мікробіому, molecular cloning та інші задачі. В окремих кейсах Biomni працювала з мультимодальними даними, оптимізацією стабільності білків, лабораторними інструментами та створенням протоколів, які можна перевірити експериментально.
Це важливіше за демонстрацію на одному «красивому» benchmark. Біомедицина складається з дуже різних типів роботи: від читання літератури до статистики, від програмування до фізичного експерименту. Агент, який претендує на універсальність, повинен не просто знати терміни, а переходити між цими режимами.
Benchmark майже на рівні експерта — і чому це не означає «AI став біологом»
У попередній повній версії роботи автори наводили показовий результат на підмножині LAB-Bench DbQA: близько 74,4% accuracy для Biomni проти приблизно 74,7% у експертної людини; простіший ReAct+Code baseline був значно нижче. Ця цифра ефектна, але її легко неправильно прочитати.
Benchmark перевіряє певний набір задач у певному форматі. Він не вимірює здатність вибрати справді важливу наукову проблему, помітити погано поставлений експеримент, зрозуміти прихований confounder або вирішити, що статистично красивий результат біологічно безглуздий. Наука — це не одна таблиця accuracy. Тому чесний висновок звучить так: Biomni демонструє, що агентна система вже може конкурувати з людьми на частині складних інструментальних завдань, але це не доказ повної автономності дослідника.
Найцікавіше починається там, де AI торкається мокрої лабораторії
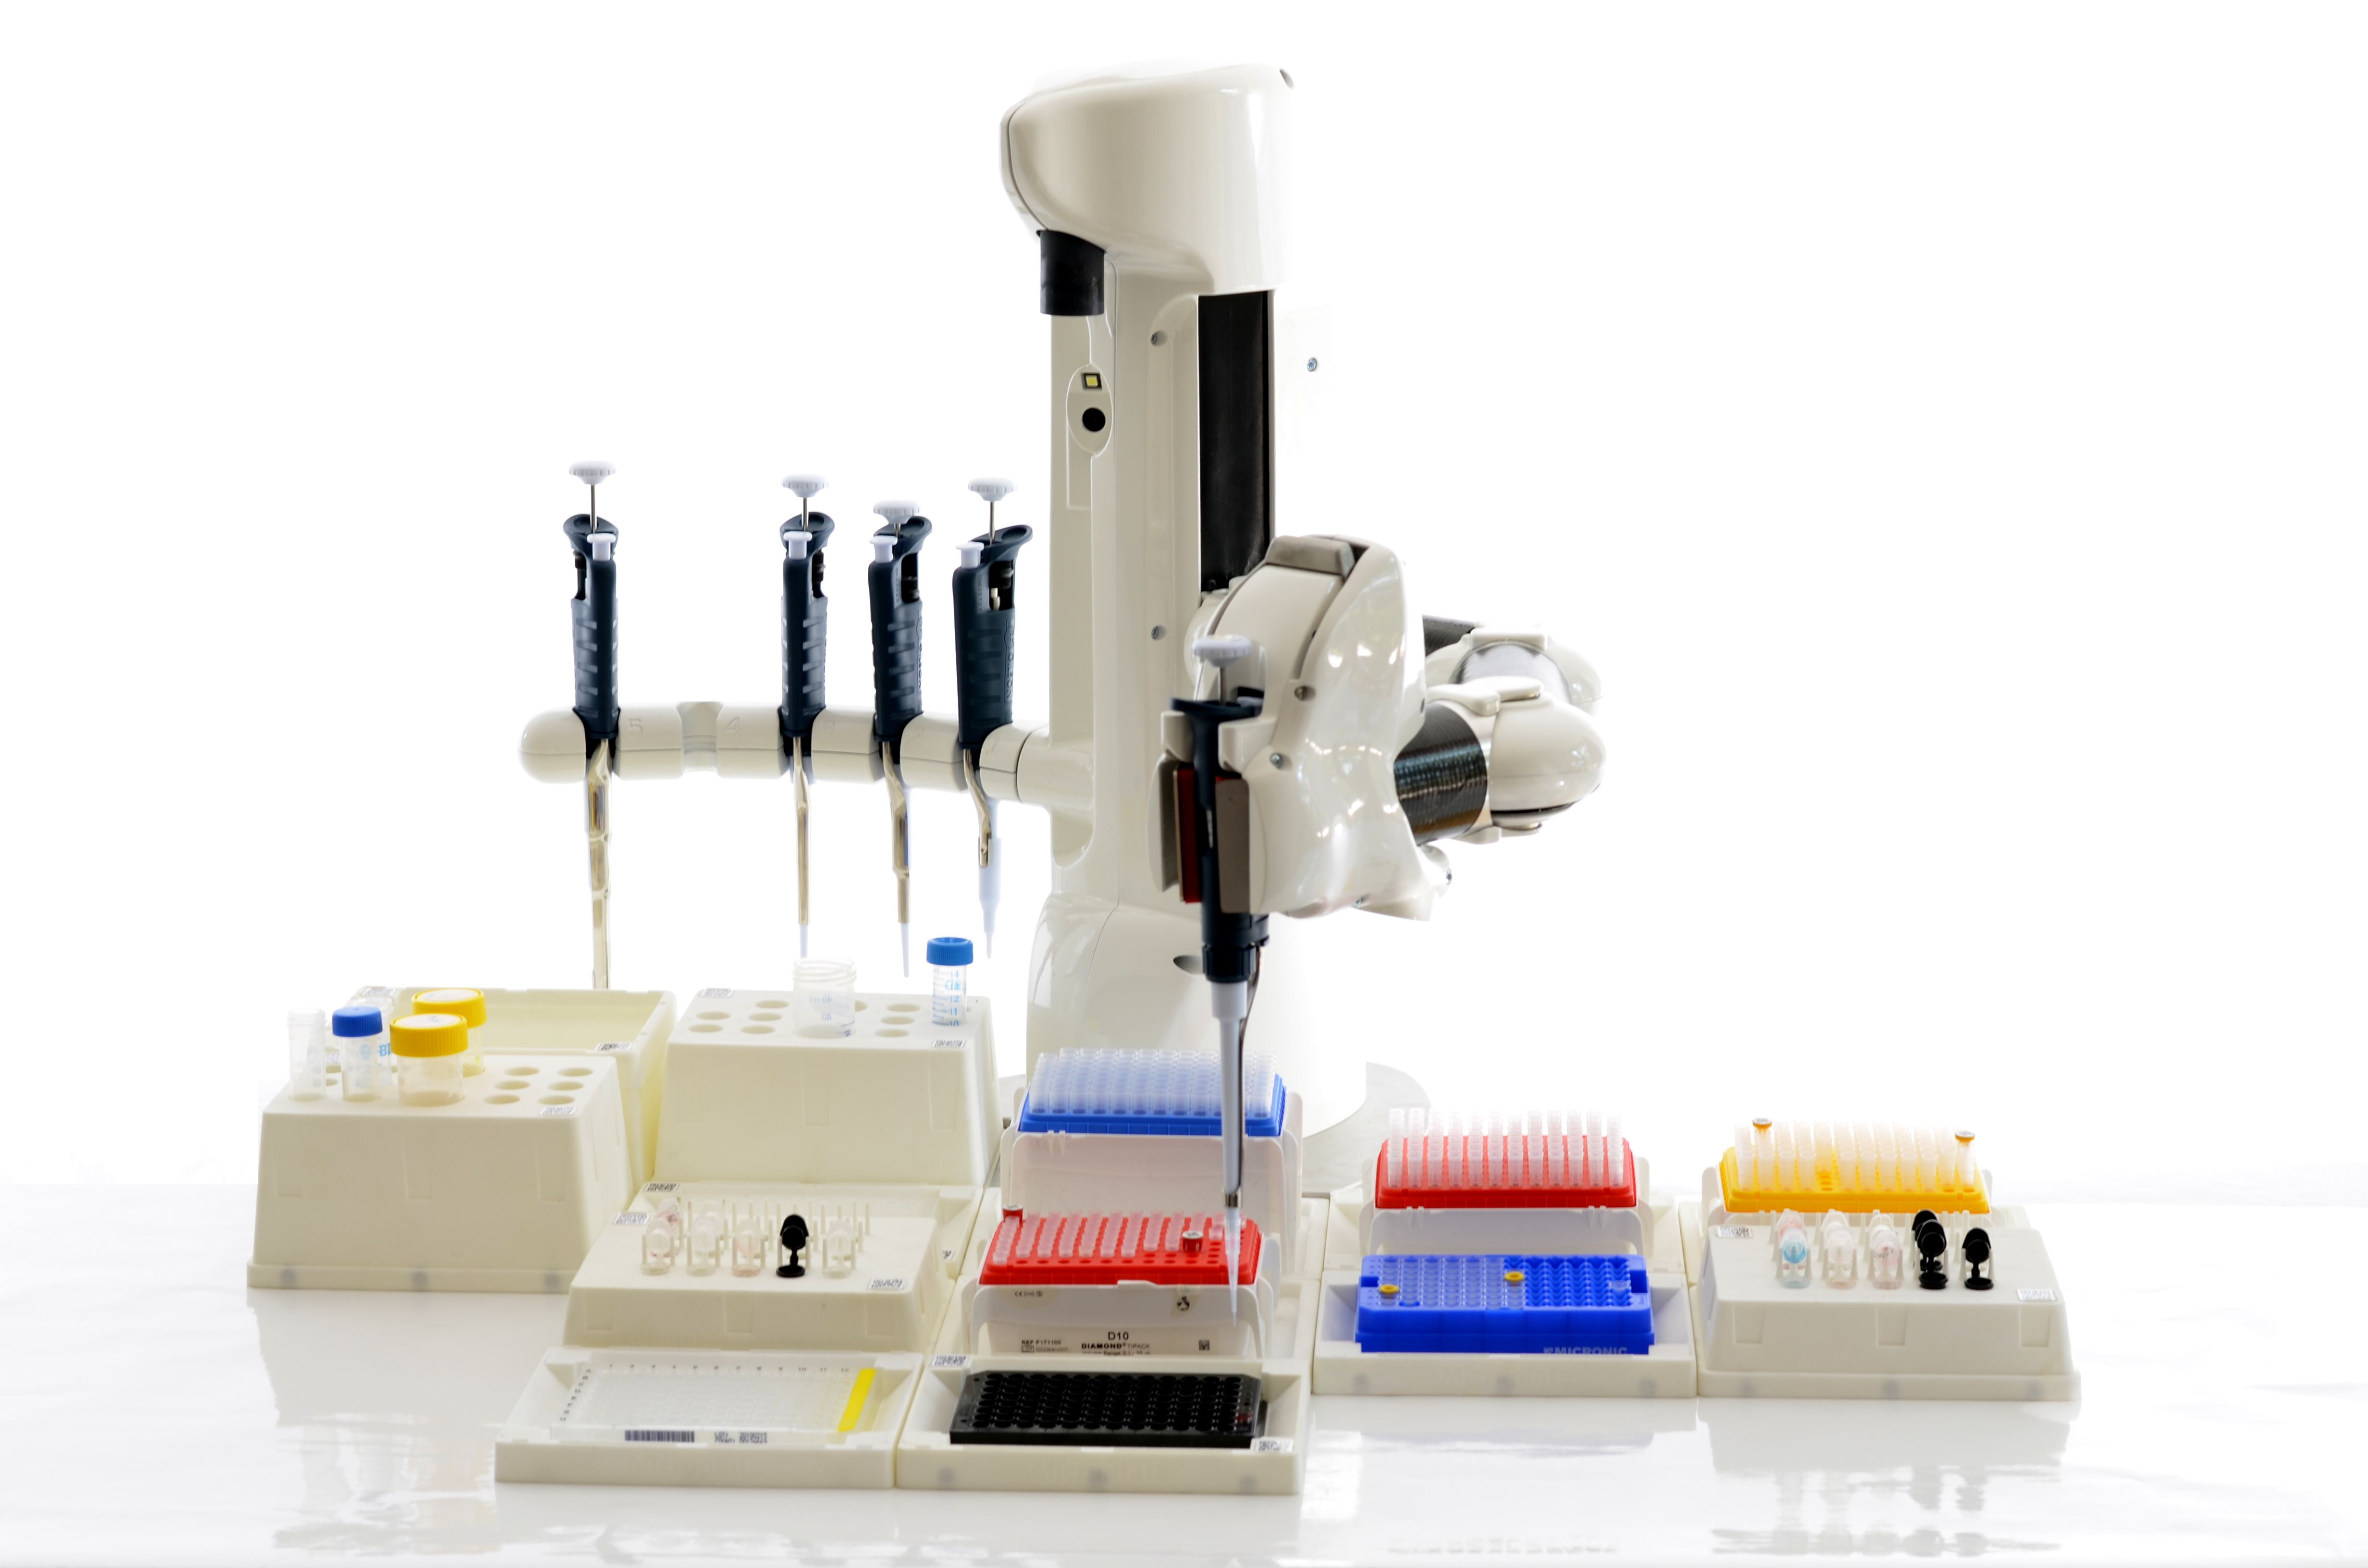
Коли агент лише аналізує відкритий датасет, помилка часто коштує часу. Коли він формує protocol або керує лабораторним обладнанням, помилка може коштувати дорогих реагентів, зіпсованої серії вимірювань і тижнів роботи. Тому згадка про оркестрацію wet-lab instruments у Science — не просто ефектний пункт у списку capabilities. Це рубіж, після якого питання надійності стає практичним.
У такій системі потрібні журналювання всіх дій, контроль версій інструментів і баз, sandbox для виконання коду, перевірка дозволених операцій, provenance кожного проміжного результату і можливість відтворити workflow незалежно. Інакше «автономність» швидко перетворюється на складну помилку, яку ніхто не може реконструювати.
Галюцинація в науці дорожча, ніж галюцинація в чаті
Якщо звичайний чатбот вигадає назву книжки, користувач може швидко це помітити. У біомедичному workflow помилка може бути захована в коді, неправильно підібраному reference genome, несумісній версії пакета, плутанині між одиницями вимірювання або невірно застосованому статистичному тесті. Результат при цьому може виглядати переконливо.
Саме тому для наукових агентів важливі не тільки «розумні відповіді», а механізми верифікації. Система має показувати джерела, параметри, код, версії, причини вибору методу та невизначеність. Чим більше дій агент виконує сам, тим сильнішою повинна бути його audit trail.
Чи може Biomni прискорити маленькі лабораторії сильніше, ніж великі
Одна з найцікавіших можливостей — демократизація інструментів. Велика фармкомпанія може найняти окремих bioinformatics engineers, statisticians і data scientists. Невелика академічна група часто не може. Якщо агент справді знижує бар’єр входу в складний аналіз, найбільший відносний виграш можуть отримати саме команди, де одна людина сьогодні змушена поєднувати п’ять ролей.
Це не робить експертизу непотрібною. Навпаки: агент може прибрати рутину, але рішення «чи має цей результат біологічний сенс?» залишається доменною роботою. Найкращий сценарій — не лабораторія без людей, а лабораторія, де вчені витрачають менше часу на встановлення пакетів і ручне переписування форматів, а більше — на гіпотези, дизайн експериментів і критичне мислення.
Biomni схожа на ранню версію «операційної системи лабораторії»
Сьогодні наукові AI-агенти часто виглядають як надбудова над мовною моделлю. Але логіка розвитку підказує інший образ. Якщо одна система знає доступні бази, інструменти, протоколи, обчислювальні ресурси, лабораторні роботи й історію експерименту, вона починає нагадувати orchestration layer — своєрідну операційну систему між людиною та науковою інфраструктурою.
Саме тут може з’явитися довгострокова цінність. Модель під капотом можна замінити. Окремий інструмент теж. Але середовище, яке знає, як безпечно зв’язати їх у відтворюваний процес, накопичує іншу форму переваги: стандартизовані workflows, provenance і інтеграції.
Що поки не доведено
Автори самі зазначають, що оцінені задачі — лише підмножина біомедицини, а важливі домени залишаються неперевіреними. Це суттєве обмеження. Публікація в Science підвищує рівень доказовості, але не означає, що агент уже можна без нагляду ставити в будь-яку клінічну або дослідницьку систему.
Потрібні незалежні повторні оцінки, стрес-тести на поганих даних, перевірки reproducibility, моделювання failure modes і порівняння не лише з іншими AI, а з реальними командами вчених на повних проектах. Особливо цікавий критерій — не «скільки правильних відповідей», а скільки часу й коштів агент економить до моменту отримання валідованого експериментального результату.
Чи замінить це науковця
Найближча правдоподібна відповідь — ні, але змінить розподіл роботи. У науці багато механічних кроків, які добре підходять автоматизації: пошук релевантних ресурсів, переформатування даних, запуск типових аналізів, первинна візуалізація, підготовка списку гіпотез. І є кроки, де контекст, скепсис і відповідальність критичні.
Тому сильніша метафора для Biomni — не «AI-вчений, який звільнить лабораторію», а дуже швидкий технічний співробітник, якому можна доручити значну частину інструментальної роботи, але результати якого потрібно перевіряти. Якщо ця модель виявиться стабільною, вона може змінити темп досліджень навіть без фантастичного сценарію повністю автономної науки.
Чому ця робота важлива саме зараз
2024–2025 роки показали, що LLM можуть добре працювати з текстом і кодом. Наступний етап — агенти, які не просто генерують відповідь, а взаємодіють із зовнішнім світом. Біомедицина є одним із найскладніших тестів для цієї ідеї: тут надзвичайно багато інструментів, дорогі помилки і висока ціна відтворюваності.
Biomni цікава тим, що переводить дискусію з «чи може AI пояснити біологію?» у практичніше питання: «чи може він зв’язати десятки професійних інструментів у корисний, перевірюваний workflow?». Відповідь поки не остаточна, але робота в Science показує, що це вже не лабораторна іграшка на одному benchmark.
Що варто стежити далі
Найважливіші сигнали наступних років — незалежні replication studies, реальні мокрі лабораторії, стандарти аудиту для agentic science і поява спільних форматів provenance. Якщо різні агенти зможуть повторити один workflow на однакових даних і отримати узгоджений результат, це буде значно важливішим за ще один рекорд у benchmark.
І якщо науковий AI справді стане інфраструктурою, найбільша революція може виглядати дуже буденно: аспірант формулює хороше питання ввечері, а вранці отримує не «відповідь від чатбота», а документований набір аналізів, код, джерела, варіанти експерименту і список місць, де система сама не впевнена. Саме така автоматизація здатна прискорити науку, не підміняючи її.
Biomni — не ще один медичний чатбот. Розбираємо AI-агента зі Science, який працює з 25 біомедичними напрямами, пише код, комбінує інструменти та формує експериментальні протоколи.
- Biomni — general-purpose biomedical AI agent, а не звичайний чатбот.
- Action-discovery середовище охоплює 25 біомедичних напрямів.
- Система поєднує LLM reasoning, retrieval-augmented planning і виконання коду.
- У кейсах агент працював із генами, drug repurposing, rare disease, microbiome, cloning і wet-lab workflows.
- Головне обмеження — результати потребують перевірки, provenance і незалежної валідації.
Ключові цифри
Єдине агентне середовище.
За Stanford AI Index 2026.
Benchmark у ранній повній версії.
DOI 10.1126/science.adz4351.
Питання й відповіді
Що таке Biomni?
Чим він відрізняється від ChatGPT?
Чи може Biomni працювати з лабораторією?
Чи замінює це науковця?
Джерела та перевірка
- ScienceAutonomous biomedical research with an artificial intelligence agent
- PubMedAutonomous biomedical research with an artificial intelligence agent
- Stanford University / EurekAlertMeet Biomni – an AI-powered biomedical co-scientist
- Stanford HAIAI Index Report 2026 — Medicine
- Wikimedia CommonsAutomated pipetting system using manual pipettes.jpg
Коментарі0 коментарів
Коментарі