
У матеріалі
164 розд.Частина I. Чи справді вам треба навчати LLM
1. Що ми взагалі називаємо «навчити свою LLM»
Почнемо з найважливішого розмежування. Якщо ви завантажили готову Qwen, Llama або Mistral і навчили LoRA на власних відповідях — ви зробили корисний fine-tuning, але не створили базову мовну модель з нуля. У цьому гайді головний маршрут інший: tokenizer навчається на вашому corpus, weights ініціалізуються випадково, а модель уперше в житті бачить текст саме у вашому training run.
Це принципово інший досвід. На старті модель буквально не «знає» ні української, ні російської, ні Python, ні навіть того, що після відкривної дужки часто буває закривна. Усе це виникає лише через next-token prediction. Саме тому маленька 100M-модель, яку ви самі провели від random noise до зв’язного тексту, часто вчить про LLM більше, ніж місяць експериментів із промптами до чужої 70B-моделі.
2. LLM — не база даних, а машина стискання закономірностей
Найкраща інтуїція для pretraining: ми змушуємо neural network стискати статистичну структуру величезного text stream у parameters. Вона не зберігає корпус як SQL-таблицю. На кожній позиції вона отримує попередні tokens і повинна розподілити probability mass між усім vocabulary: який token наступний? Якщо правильний token отримав низьку probability — loss великий; якщо високу — малий.
Повторіть це мільярди разів, і щоб зменшувати loss, model вимушена винаходити всередині себе корисні representations: орфографію, синтаксис, стилі, факти, шаблони коду, relations між поняттями, частину world knowledge. Це не означає, що вона «розуміє» світ так само, як людина. Але next-token objective дивовижно жорстко винагороджує все, що допомагає передбачати продовження.
3. Чотири маршрути: from scratch, continued pretraining, SFT і LoRA
From-scratch pretraining потрібен, коли ви хочете власну base model, тестуєте architecture, будуєте модель для особливої мови/послідовностей або просто хочете навчитися всьому pipeline. Continued pretraining бере готову base model і продовжує next-token training на новому domain чи language mix. Це у десятки разів практичніше, якщо ваша мета — сильний продукт, а не власні random-initialized weights.
SFT змінює не стільки знання, скільки поведінку: prompt → бажана completion. LoRA — спосіб дешевше зробити fine-tuning, заморозивши base weights і навчаючи low-rank adapters. У реальному бізнесі найчастіше виграє «готова base → continued pretraining за потреби → SFT/LoRA → preference tuning». Але щоб розуміти, що відбувається під капотом, ми пройдемо найважчий шлях — з нуля.
3A. Можливо, вам взагалі не треба тренувати weights
Перш ніж купувати GPU, варто поставити незручне питання: яку саме проблему ви намагаєтеся вирішити? Якщо модель повинна відповідати за вашими документами, каталогом товарів, технічною базою або документацією, яка змінюється щотижня, найчастіше правильна перша відповідь — не pretraining, а RAG. Retrieval-Augmented Generation тримає знання у зовнішньому індексі, знаходить релевантні fragments під час запиту і додає їх у context. Так knowledge можна оновити без переписування мільярдів weights.
Якщо потрібен інший стиль відповіді, формат JSON, певна манера діалогу або надійне виконання інструкцій — дивіться на SFT/LoRA. Якщо готова base model уже знає мову, але слабко володіє вашою спеціальною термінологією, кодом чи доменом — continued pretraining часто набагато дешевший за training from scratch. І лише коли вам потрібні власний tokenizer, власна base distribution, нова architecture, research-контроль або сам досвід побудови LLM від random weights — from scratch стає логічним вибором.
| Ваше завдання | Що пробувати першим | Чому |
|---|---|---|
| Свіжі приватні документи й факти | RAG | Знання оновлюються без retraining weights |
| Новий стиль/формат/поведінка | SFT або LoRA | Вчимо поведінку, не будуємо base model заново |
| Глибока адаптація до domain/language | Continued pretraining | Продовжуємо next-token learning на потрібному distribution |
| Власна base model або research | From scratch | Повний контроль над tokenizer, data mixture, architecture і weights |
Ця таблиця не «відмовляє» вас від власної LLM. Навпаки: вона не дає витратити місяць на найдорожчий інструмент там, де задача вирішується за два дні простішим способом.
4. Спочатку напишіть test, а вже потім модель
Перед corpus і GPU сформулюйте, що означає «добра модель». Якщо ціль — українсько-російський технічний помічник, вам потрібні окремі held-out набори української, російської, змішаного technical prose, code, factual QA і instruction-following. Якщо ціль — code completion, головними можуть бути syntax validity, unit tests і pass@k. Без цього ви легко витратите два тижні й отримаєте loss, який красиво падає, але не знаєте, чи модель стала кориснішою.
Практичний прийом: до training створіть 50–200 «золотих» prompts, які ніколи не потрапляють у corpus. Раз на checkpoint генеруйте на них samples. Це не замінює benchmark, зате дуже швидко показує regressions: модель раптом почала повторюватися, перемішувати кирилицю, ламати Markdown або втратила domain vocabulary.
5. Якого розміру модель будувати першою
Перший from-scratch project не повинен бути 7B. Розумний навчальний діапазон — приблизно 50–150M parameters. Така model уже достатньо велика, щоб продемонструвати справжню language-model behaviour: syntax, короткі facts, style imitation, прості continuations. І водночас її можна запускати на одному 16–24 GB-class accelerator з малим micro-batch, mixed precision і gradient checkpointing.
Наступний клас — 300M–1B. Тут data quality починає відчуватися значно сильніше, а один GPU швидко перетворюється на bottleneck. 3B+ — уже cluster territory, якщо ви хочете не toy run, а сотні мільярдів чи трильйони tokens. SmolLM3 добре протвережує: «всього 3B» model тренували на 11.2T tokens із 384 H100 протягом 24 днів.
6. Parameters — це capacity, tokens — це досвід
Уявіть parameters як місткість мозку моделі, а tokens — як кількість прикладів життя. Занадто велика model на малому corpus запам’ятовує й недонавчається. Занадто маленька model на нескінченному corpus упирається у capacity. Scaling laws намагаються формалізувати цей баланс.
Chinchilla показала, що за фіксованого training compute варто одночасно масштабувати і model size, і кількість training tokens. Звідси народився популярний грубий орієнтир близько 20 tokens на parameter для compute-optimal regime. Але не перетворюйте його на закон природи: сучасні inference-oriented recipes часто «перетреновують» відносно Chinchilla менші models на набагато більшій кількості tokens, бо дешевша inference потім важливіша за мінімальний training compute.
7. Перша формула бюджету: C ≈ 6ND
Для dense decoder-only Transformer часто використовують грубу оцінку training FLOPs: C ≈ 6 × N × D, де N — кількість parameters, D — training tokens. Це не бухгалтерія до останнього multiply: attention, embeddings, recomputation і implementation details зсувають цифру. Але як порядок величини формула надзвичайно корисна.
Наприклад, 100M parameters × 1B tokens дає приблизно 6×10^17 FLOPs. Це вже не «кілька хвилин Python». Але головний practical trick — не вираховувати час із theoretical TFLOPS. Запустіть 1 000 steps на своєму hardware, виміряйте real tokens/sec, і лише тоді extrapolate ETA. Реальний utilization може відрізнятися від marketing peak у кілька разів.
C ≈ 6 × N_parameters × N_training_tokens
ETA_days = total_tokens / measured_tokens_per_second / 86400
7A. FLOPs — це теорія, tokens/sec — ваша реальність
Формула C ≈ 6ND потрібна для sanity check, але вона не знає нічого про ваші kernels, драйвер, sequence length, data loader, gradient checkpointing чи те, що сусідній процес раптом забрав 3 GB VRAM. Тому головна одиниця домашньої лабораторії — не TFLOPS із коробки GPU, а реальні tokens/sec після прогріву. Вимірюйте їх не на перших десяти steps: CUDA graphs, кеші, JIT/compile і filesystem можуть зробити початок нерепрезентативним.
Правильний pilot виглядає так: 50–100 warmup steps, потім кількасот стабільних steps, із яких ви берете median tokens/sec. Далі ETA рахується вже без магії: remaining_tokens / measured_tokens_per_second. Якщо після зміни FlashAttention, checkpointing або batch size throughput виріс на 18%, це реальна економія. Якщо «теоретичні FLOPS» стали красивішими, а tokens/sec не змінилися — для вашого run нічого не покращилося.
7B. Визначте Definition of Done до того, як купите ще одну GPU
Навчання LLM дуже легко перетворити на нескінченний проєкт: loss ще падає, можна додати ще data, ще 100k steps, ще один benchmark. Тому до запуску варто записати критерії завершення. Наприклад: validation loss нижче певного baseline; український і російський held-out loss не розходяться; 100 golden prompts не деградують; модель стабільно генерує без циклів; code subset проходить визначений набір syntax/unit tests; немає очевидного memorization на canary prompts.
Цей список важливіший за красиву назву моделі. Він дозволяє зупинити run, коли ви отримали потрібний результат, а не коли закінчилися гроші або терпіння. Для першої 100M-моделі «вміє зв’язно продовжувати технічний текст двома мовами і не розвалюється на 500 tokens» — уже чесний інженерний успіх.
8. Три реалістичні проєкти: домашній, лабораторний і кластерний
Домашній/навчальний: ~100M parameters, context 1024–2048, 0.5–2B якісних tokens. Це модель, на якій ви реально пройдете corpus → tokenizer → checkpoints → sampling → SFT. Вона не переможе готові сучасні assistants, але дасть повний engineering experience.
Лабораторний: 300M–1B, приблизно 10–100B curated tokens, одна або кілька машин із 1–8 GPUs залежно від context і stack. Кластерний: 3B+, сотні billions/trillions tokens, FSDP/ZeRO/Megatron, fast storage, observability і дисципліна, схожа вже на distributed systems engineering. Межі умовні: sequence length, architecture та accelerator сильно змінюють memory/time.
Частина II. Data factory: звідки беруться хороші tokens
9. У LLM є дві фабрики: data factory і training factory
Новачки часто одразу відкривають PyTorch. Великі команди спочатку будують data factory: ingestion, normalization, language detection, quality scoring, exact/fuzzy dedup, PII filtering, source weighting, benchmark decontamination, tokenization, packing, manifests. Лише потім training factory перетворює це на gradient updates.
Це не бюрократія. Якщо GPU cluster коштує дорого, він не повинен чекати Python parser, повільний network filesystem або gzip decompression. І ще важливіше: жоден optimizer не виправить корпус, у якому 30% SEO-spam, дублікати форумних цитат і випадково включені answers із validation benchmark.
10. Дані мають мати provenance, а не просто папку «texts»
Для кожного source зберігайте хоча б origin URL/dataset, acquisition date, license/terms, language, domain, processing version і причину включення. Якщо через пів року з’ясується, що один dump треба видалити, без provenance ви не зможете ні знайти його contribution, ні відтворити новий corpus.
Public web не дорівнює «можна все». Умови використання, copyright, privacy, opt-out requirements і jurisdiction різняться. FineWeb сам публікується з data documentation і нагадує про source terms. Для комерційної моделі потрібен окремий legal review; технічний гайд не замінює його.
11. Звідки брати corpus
Джерела залежать від цілі: licensed books/articles, Wikipedia та open encyclopedic corpora, Common Crawl derivatives, open code, public technical documentation, scientific papers із відповідними правами, forums/Q&A, власні support logs після privacy review, synthetic data. Важлива не максимальна різноманітність, а керований mix.
Для українсько-російської technical model я б окремо рахував частки: український якісний prose, російський якісний prose, English technical/science, code, math/structured data. Якщо просто злити «все, що знайшли», English через свою масу легко витіснить менші мови, а model почне відповідати англійською навіть на кириличні prompts.
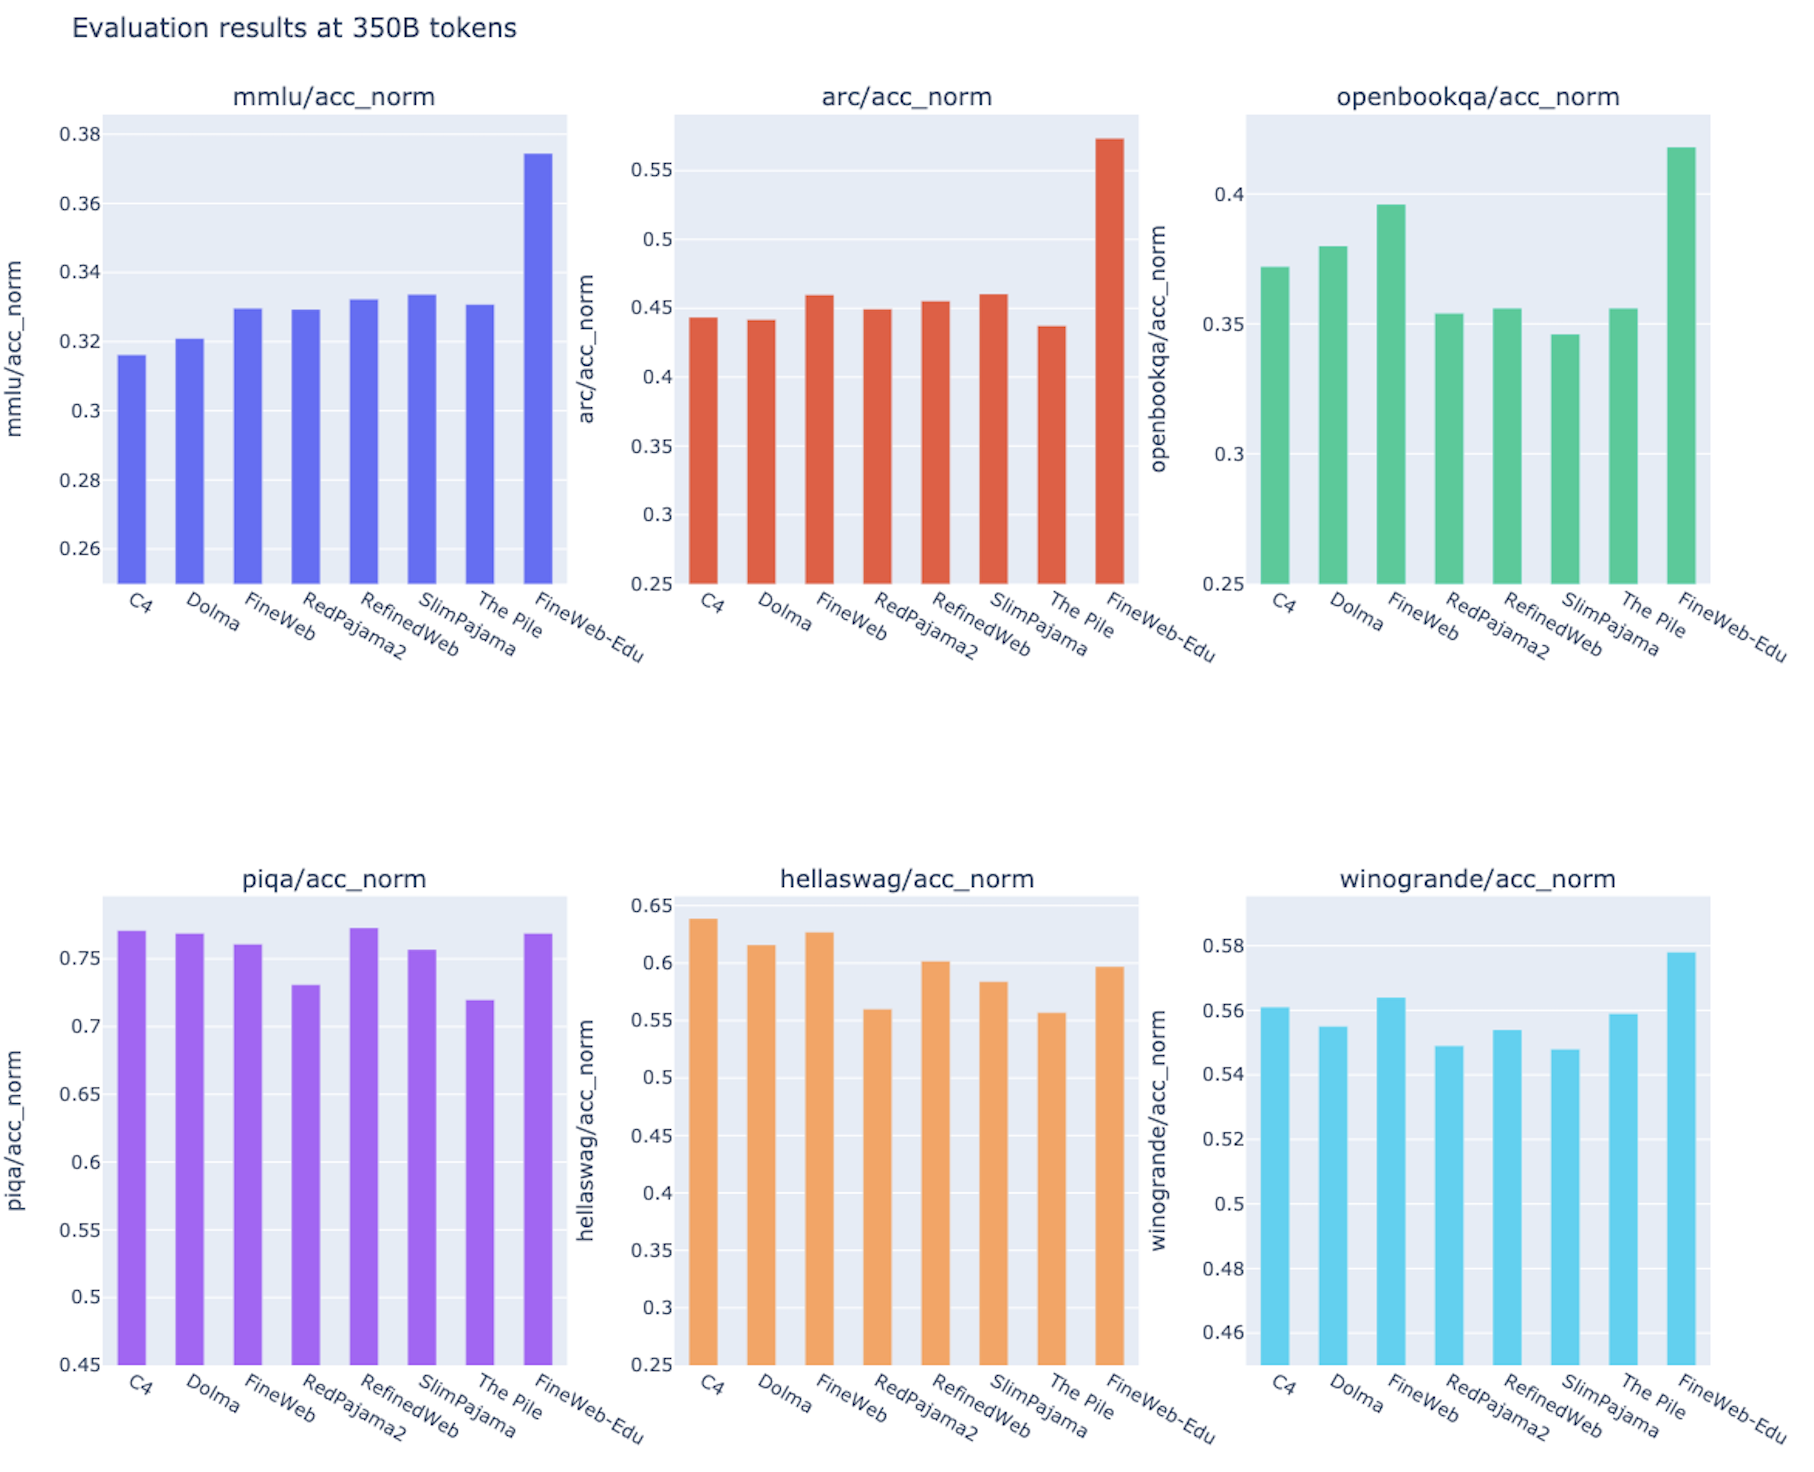
12. FineWeb-Edu: один із найкращих доказів, що якість б’є кількість
FineWeb-Edu починався з величезного web corpus, але Hugging Face навчив classifier оцінювати educational quality і залишив лише сторінки вище threshold. Для threshold 3 відсіяли близько 92% даних — і залишилося приблизно 1.3T tokens. При цьому ablation models на filtered data показували кращі результати на knowledge/reasoning benchmarks, ніж на значно більшому сирішому web mix.
Особливо показова ціна самого filtering: класифікація приблизно 15T tokens, за даними dataset card, коштувала близько 6 000 H100 GPU-hours. Тобто сучасне LLM engineering витрачає серйозний compute ще до pretraining. «Data quality» давно перестала означати regex на HTML tags.
12A. Quality classifier — це не оракул, а ще одна модель із власними упередженнями
FineWeb-Edu добре показує силу quality filtering, але з цього легко зробити неправильний висновок: ніби достатньо натренувати classifier «хороший/поганий текст» і натиснути Delete. Насправді classifier оптимізує те визначення якості, яке ви дали йому через labels. Якщо ваші позитивні приклади — академічні англомовні пояснення, він може систематично занижувати живу українську технічну дискусію, форуми, документацію з короткими фрагментами або нестандартну математику.
Тому quality score краще використовувати як feature для sampling, а не як абсолютний суд. Побудуйте гістограми score за мовами й domains, вручну перегляньте випадкові приклади з різних deciles, окремо перевірте false positives/false negatives. Часто корисніше не видалити весь «середній» контент, а дати high-quality bucket більшу sampling weight. Так ви збережете різноманітність, не дозволивши шуму домінувати.
12B. Source diversity: десять мільярдів token одного стилю — не те саме, що десять мільярдів досвіду
Дві однакові за кількістю tokens суміші можуть дати дуже різні моделі. 10B tokens із документації одного типу вчать стабільний стиль, але звужують distribution. 10B із книжок, наукових текстів, code, Q&A, документації, діалогів і якісного web дають ширшу структуру задач. Тому в manifest варто рахувати не лише bytes/tokens, а й кількість independent documents, domains, hosts, authors/collections там, де це законно й технічно можливо.
Особливо небезпечні агрегатори: тисячі URL можуть насправді містити один syndicated text. Exact/fuzzy dedup лікує частину проблеми, але source-level statistics допомагають побачити концентрацію ще до складного processing. Для маленької моделі diversity часто дає більше користі, ніж ще один мільярд слабко відмінних token.
13. Спочатку прибираємо сміття: parsing і normalization
Web page — це не готовий training document. Там navigation, cookie banners, repeated headers, JavaScript fragments, comments, boilerplate, hidden text, encoding garbage. На першому етапі data pipeline має витягнути основний content і привести його до стабільного UTF-8 representation. Але «нормалізувати» не означає стерти всю структуру: Markdown headings, code fences, lists і paragraph boundaries часто корисні моделі.
Для mixed Cyrillic corpus окремо перевіряйте Unicode normalization, zero-width symbols, homoglyphs, broken mojibake і неприродні repetitions. Не замінюйте автоматично всі літери «ё/е» чи українські апострофи заради уявної чистоти: ви можете знищити справжню мовну інформацію. У data cleaning краще мати вимірювані правила й samples «до/після», а не магічний скрипт із 200 regex.
14. Language identification: «кирилиця» — це ще не мова
Якщо ви тренуєте multilingual model, визначайте language на document або навіть paragraph level. Російська, українська, білоруська, сербська можуть мати спільні symbols, а technical text легко змішує English terms і code. Примітивне правило «є і — значить українська» дасть великий шум.
Зберігайте language confidence і не соромтеся класу unknown/mixed. Краще мати 3% документів, які підуть в окремий bucket на ручну перевірку, ніж впевнено псувати language balance. Після tokenization порахуйте фактичну частку tokens за мовами: 30% documents українською не обов’язково означають 30% tokens.
15. Exact dedup: найдешевші tokens — ті, які ви не тренуєте двічі
Спочатку видаляйте exact duplicates за hash нормалізованого document або large chunk. Web corpora переповнені mirrors, copied press releases, duplicated terms pages, quoted forum messages. Якщо одна й та сама сторінка трапляється 20 разів, model бачить її як 20 голосів і витрачає compute на repetition.
Exact dedup робиться дешево: canonicalize whitespace/encoding, обчислити stable hash, залишити одну representative copy і записати provenance усіх duplicates. Не видаляйте source metadata: якщо одна копія має чистішу license/provenance, саме її варто зробити canonical.
16. Fuzzy dedup: справжній web майже ніколи не дублюється байт у байт
Дві новинні сторінки можуть містити той самий article, але різні timestamps, меню або один додатковий paragraph. Exact hash їх не зловить. Тому великі pipelines використовують MinHash/LSH, n-gram fingerprints або інші approximate similarity techniques, щоб знаходити near-duplicates.
Paper Deduplicating Training Data Makes Language Models Better дає прекрасний «вау»-факт: автори знайшли 61-word sentence, що повторювався понад 60 000 разів. Після dedup моделі приблизно в десять разів рідше генерували memorized text verbatim і потребували менше train steps для тієї самої або кращої accuracy. Це одночасно quality, compute і privacy win.
17. Benchmark decontamination: не дозволяйте моделі списати екзамен
Якщо answers із benchmark потрапили у training corpus, результат evaluation перестає означати generalization. Це особливо небезпечно для популярних MMLU-like questions, coding tasks, math problems і open benchmark repos, які багато разів копіюють в tutorials та blogs.
Decontamination роблять до training: будують fingerprints evaluation items і шукають exact/near matches у corpus, часто на n-gram level. Краще трохи переочистити training data, ніж потім святкувати benchmark gain, який насправді є leakage. Dedup paper показував, що train-test overlap може зачіпати помітну частку standard validation datasets.
18. PII, secrets і токсичне сміття: «все з інтернету» — погана стратегія
Перед pretraining шукайте emails, phone numbers, addresses, API keys, access tokens, private identifiers та інший sensitive material. Regex — лише перший шар: частина PII потребує NER/classifiers, а secrets — entropy/pattern scanners. У власних customer logs потрібні особливо суворі permission і anonymization rules.
Content filtering теж має бути цільовим. Ви не зможете видалити «все погане», не знищивши корисний knowledge про security, medicine або history. Краще мати taxonomy: illegal/secret/PII, low-quality spam, explicit content, hate/toxicity, personal attacks, malware code тощо — і для кожного класу окрему policy, а не один opaque «safety score».
18A. Карантин даних: не кожен підозрілий документ треба одразу видаляти
Практичний data pipeline виграє від третього стану між «train» і «delete» — quarantine. Туди відправляють документи з secrets-like patterns, невпевненою language ID, дивною license metadata, надмірною repetition, підозрілими benchmark fragments або дуже високим toxicity score. Потім вибірку з quarantine можна перевірити вручну або сильнішим classifier.
Це корисно з двох причин. По-перше, агресивний filter часто знищує легітимний security/code content, де API key виглядає як приклад, а не реальний secret. По-друге, ви зберігаєте audit trail: чому документ не потрапив у training. У production-проєкті можливість пояснити «цей source був відкинутий правилом X у pipeline v17» набагато цінніша, ніж безповоротний rm -rf bad_data.
18B. Synthetic data: корисний прискорювач, але поганий єдиний корм
Synthetic text дозволяє закрити рідкісні domains, створити reasoning traces, переписати слабкі пояснення або згенерувати instruction pairs. Але якщо модель покоління за поколінням харчується переважно outputs інших моделей, distribution може звужуватися: помилки teacher-а множаться, рідкісні людські стилі зникають, а «типовий AI voice» стає самопідсилюваним.
Тому synthetic data треба маркувати provenance окремо від human/original sources, мати teacher/model/version/prompt metadata, дедуплікувати від seed data й вимірювати, що саме вона додає. Сильний підхід — використовувати synthetic як targeted supplement: math solutions із verifier, code із unit tests, multilingual rewrites із quality checks, важкі instructions. Коли можливо, приймайте synthetic sample не тому, що teacher упевнено його написав, а тому, що існує зовнішня перевірка.
19. Data mixture: corpus — це рецепт, а не відро
Після cleaning у вас є buckets: web, books, code, math, science, Ukrainian, Russian, English, Q&A. Тепер треба вирішити sampling weights. Якщо sampling proportional to raw size, найбільший bucket завжди переможе. Якщо зробити equal weights, маленький dataset може повторюватися сотні epochs і модель його запам’ятає.
Поширена практика — temperature sampling або вручну задані weights із caps на oversampling. Для маленьких мов можна свідомо підняти probability, але паралельно стежити за effective epochs: скільки разів кожен unique token буде побачений. Data mix — один із найсильніших hyperparameters; сучасні recipes на кшталт SmolLM3 змінюють proportions по stages, підсилюючи code/math/high-quality data ближче до кінця.
20. Train/validation/test split робіть на рівні documents — до packing
Розділяйте corpus до tokenization/packing, бажано deterministic hash by document. Якщо спочатку розрізати documents на chunks, а потім випадково розкидати chunks по train і validation, сусідні шматки однієї статті опиняться по обидва боки. Validation loss стане красивішим, але брехливим.
Для великого pretraining corpus validation може бути відносно маленьким — головне, щоб він був representative і достатньо стабільний для порівняння checkpoints. Test set тримайте недоторканим до фінальної оцінки. Окремо зберігайте domain-specific eval, який не є просто «ще 0.5% web text».
Частина III. Tokenizer: алфавіт, який модель винаходить перед навчанням
20A. Dataset manifest — це «git commit» ваших даних
Якщо training run триває тиждень, фраза «ми тренували на приблизно тому самому corpus» неприйнятна. Збережіть manifest із точним списком shards, їхніми SHA-256/ETag, кількістю documents і tokens, tokenizer hash, processing version, sampling weights та seed. Для streaming data також зафіксуйте порядок або спосіб його детермінованого відтворення.
Це дає суперсилу: через місяць ви можете повторити run, змінюючи лише одну змінну. Якщо validation раптом покращилася, ви знаєте — це новий optimizer, а не непомітно оновлений web dump. Великі open recipes цінні саме тим, що показують не тільки weights, а й data mixes, configs і checkpoints.
20B. Canary strings: простий спосіб побачити, коли модель починає запам’ятовувати
Для власних експериментів можна створити кілька унікальних, безпечних «канаркових» рядків, які навмисно з’являються у training corpus відому кількість разів, але не несуть реальних секретів. Після checkpoints перевіряйте, чи модель здатна відтворити їх із короткого prefix. Це не повна privacy-аудит методика, але чудовий навчальний датчик memorization.
Експеримент особливо цікавий із повтореннями: один canary побачити раз, інший — 10 разів, третій — 100. Ви буквально спостерігаєте, як frequency змінює memorization pressure. А потім повторюєте після dedup і бачите, чому «дублікати» — не косметична проблема data engineering.
21. Tokenizer — це компресор між текстом і нейромережею
Transformer не читає letters. Він читає integer token IDs. Tokenizer визначає, чи слово «електромагнітний» стане одним token, трьома morpheme-like pieces або двадцятьма bytes. Це прямо впливає на effective context, training cost і те, наскільки легко model бачить patterns.
Поганий tokenizer для вашої мови — прихований податок. Якщо український текст у середньому розбивається вдвічі дрібніше, ніж English, то 2 048-token context містить удвічі менше змісту, а кожен billion «українських слів» коштує більше training FLOPs. Тому from-scratch model заслуговує from-scratch tokenizer.
22. BPE, WordPiece, Unigram: що вибрати
BPE починає з дрібних symbols і поступово merge найчастіші сусідні pairs. WordPiece схожий, але вибирає merges за іншою scoring logic. Unigram стартує з великого набору pieces і видаляє менш корисні, оптимізуючи probabilistic model. Усі три можуть працювати; різниця часто менша, ніж різниця між хорошим і поганим training corpus tokenizer-а.
Для практичного UK/RU/English/code starter ми використовуємо ByteLevel BPE. Byte-level base гарантує, що практично будь-який UTF-8 input можна представити без UNK для кожного нового символу, а merges стискають часті patterns. Це особливо зручно для mixed alphabets, punctuation, source code і рідкісних symbols.
23. Vocabulary size: 8k, 32k, 64k — це не косметика
Малий vocabulary дає довші sequences, зате embedding/output matrices менші й rare words комбінуються з reusable pieces. Великий vocabulary стискає текст у менше tokens, але кожен token має окремий vector, а rare pieces можуть тренуватися дуже мало. Для невеликої model величезний vocab може з’їсти непропорційно багато parameters.
32k — хороший practical starting point для multilingual/code model, але не святе число. Проведіть tokenizer ablation: 16k/32k/48k на sample corpus, порахуйте tokens per character/word за мовами й code, перевірте, чи common suffixes, identifiers, numbers і punctuation не розсипаються дивно. Вибирайте за statistics, а не за тим, що «Llama теж має приблизно стільки».
23A. Tokenizer fairness: однакові 2 048 tokens можуть містити зовсім різну кількість думки
Для multilingual model я б зробив окрему таблицю compression ratio: characters/token, words/token і bytes/token для української, російської, англійської, code та math. Якщо українська потребує, скажімо, на 35% більше tokens для того самого обсягу тексту, вона фактично отримує коротший semantic context і дорожчий training budget. Це не «естетика tokenizer-а», а fairness і compute.
Порівнюйте tokenizers на одному held-out наборі документів, а не на кількох красивих словах. І дивіться tails: median може бути нормальним, але URLs, довгі українські слова, формули чи snake_case identifiers можуть вибухати у десятки pieces. Для 32k vocabulary хороший tokenizer — той, що стабільно поводиться на ваших domains, а не той, що виграв один середній показник.
24. Special tokens — маленький контракт, який потім неможливо безболісно забути
Мінімальний набір: PAD, UNK, BOS, EOS. Для pure causal pretraining BOS інколи не потрібен у кожному sample, а PAD у packed dataset майже не використовується, але downstream libraries часто очікують чіткі IDs. Зафіксуйте їх у tokenizer config і model config однаково.
Не додавайте на старті сотні «майбутніх» special tokens без потреби. Кожен займає vocabulary slot і вимагає semantics. Chat markers (``, ``) можна додати перед SFT, але зміна tokenizer після pretraining потребує resize embeddings і нові rows починають із random/untrained state. Краще планувати format завчасно.
25. Перевірка tokenizer: не довіряйте одному красивому прикладу
Після training tokenizer проганяйте thousands of samples і будуйте statistics: average tokens/character, tokens/word, percentile sequence expansion, fraction byte-level fallback pieces, distribution за languages/domains. Окремо дивіться URLs, numbers, formulas, Markdown, code, emoji, Cyrillic-English switches і long identifiers.
Ручний smoke test теж безцінний: encode → decode має повертати той самий meaningful text; common technical words не повинні розлітатися на десятки pieces; українські відмінки та російські закінчення мають виглядати розумно. Якщо tokenizer поганий, не «вилікуєте» його більшим Transformer — ви просто дорожче навчите модель працювати з поганим alphabet.
Частина IV. Transformer під мікроскопом
26. Decoder-only Transformer: чому саме він став стандартом генеративних LLM
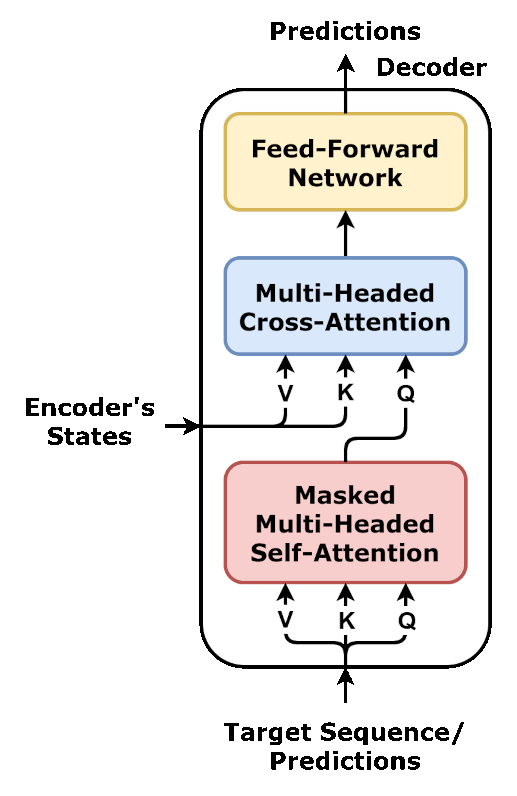
Оригінальний Transformer 2017 року мав encoder і decoder для sequence-to-sequence задач. GPT-подібні LLM відкинули encoder і залишили stack causal decoder blocks. На вході tokens перетворюються на vectors, далі кожен layer змішує інформацію через self-attention та MLP, а фінальний linear head видає logits для наступного token.
Causal означає, що позиція t не має бачити future tokens t+1, t+2… Під час training ми можемо обчислити predictions для всіх positions паралельно завдяки triangular attention mask. Під час generation future ще не існує, тому модель autoregressively додає token за token.
27. Embedding: перший переклад із token ID у геометрію
Integer 17342 сам по собі нічого не означає. Embedding table перетворює кожен token ID у dense vector розмірності d_model, наприклад 768 або 4096. На початку ці vectors random. Training поступово розміщує related tokens у корисній high-dimensional geometry, хоча «схожість» там складніша за просту semantic карту.
Embedding matrix має V × d parameters. Для vocab 32k і d=768 це близько 24.6M weights — величезна частка 100M-model. Тому vocabulary size особливо болючий у маленьких architectures. Tied embeddings дозволяють використовувати ту саму matrix і для input embeddings, і для output logits projection, економлячи parameters.
28. Self-attention: кожен token ставить питання всім попереднім
Для кожного hidden vector layer створює Query, Key і Value через learned projections. Інтуїтивно Query питає «що мені зараз потрібно?», Key описує «що я можу запропонувати?», а Value — «яку інформацію передати, якщо мене виберуть». Scores — scaled dot products Q·K; softmax перетворює їх на weights; weighted sum Values формує новий representation.
У causal model matrix scores маскується вище diagonal, щоб future positions мали probability −∞ до softmax. Це проста операція, але саме вона дозволяє одному token у кінці речення напряму звернутися до імені, числа чи variable, що з’явилися сотні positions раніше.
Q = X W_Q
K = X W_K
V = X W_V
Attention(Q,K,V) = softmax(Q K^T / sqrt(d_k) + causal_mask) V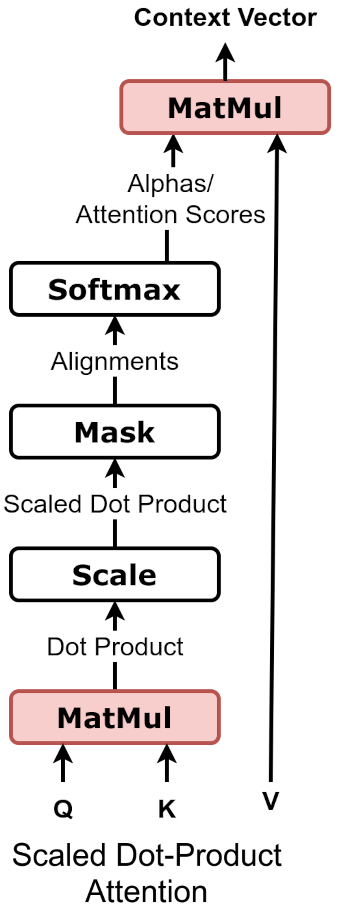
28A. Softmax і numerical stability: «просто exp» може перетворитися на NaN
Attention scores проходять через softmax, а exponentials дуже швидко переповнюються. Реальні kernels використовують стабільний трюк: перед exponentiation віднімають максимум у рядку. Математично probability не змінюється, бо softmax інваріантний до додавання однакової константи всім logits, зате найбільший exponent стає exp(0)=1 замість астрономічного числа.
Ця маленька деталь пояснює ширший принцип LLM engineering: правильна формула недостатня — важливо, як саме вона обчислюється у finite precision. BF16/FP16, fused kernels, normalization і accumulation dtype можуть перетворити теоретично еквівалентні implementations на стабільний run або нічний NaN о 03:17.
29. Multi-head attention: одна голова не повинна робити все
Замість одного великого attention mapping hidden dimension ділять на heads. Різні heads можуть спеціалізуватися на різних relations: local syntax, indentation, quotation boundaries, long-range references, positional patterns. Не треба буквально приписувати кожній head одну людську роль, але parallel subspaces підвищують expressiveness.
Після attention outputs усіх heads concatenated і projected назад у d_model. Кількість heads має ділити hidden size; head dimension часто тримають у знайомому діапазоні, наприклад 64/128, але сучасні architectures мають багато варіацій. Важливіше не копіювати число heads із чужої model, а зберегти sensible dimensions і протестувати throughput.
30. GQA і MQA: чому Key/Value heads можна мати менше
У classic multi-head attention кожна query head має власні K і V projections. Multi-Query Attention ділить один K/V head між усіма query heads; Grouped-Query Attention — компроміс, де група Q heads ділить K/V. Головна вигода особливо помітна на inference: KV cache стає меншим і memory bandwidth падає.
Current Llama-style configs мають `num_key_value_heads`, саме тому у starter model ми ставимо 12 query heads і 4 KV heads. Це не магічний optimum. Для маленького training experiment можна використовувати full MHA; GQA цікава, якщо ви хочете architecture ближчу до сучасних deployment-oriented LLM.
30A. QK normalization: іноді attention треба не прискорювати, а спочатку приборкати
У великих runs проблемою можуть стати надмірні magnitudes Query/Key, через які attention logits ростуть, softmax насичується, а gradients стають нестабільними. Сучасні architectures експериментують із QK normalization або clipping-подібними механізмами, щоб контролювати цей режим. Kimi K2, наприклад, описує MuonClip і qk-clip як відповідь на attention-logit explosions під час масштабного training.
Для вашої першої 100M-моделі це не причина терміново винаходити новий attention block. Навпаки: тримайте architecture простою, але логуйте attention/activation/gradient statistics. Якщо колись масштабування породить системний spike, ви будете бачити симптом, а не лише фінальний NaN.
31. MLP/SwiGLU: більша частина parameters живе не в attention
Після attention кожен position незалежно проходить feed-forward network. У Llama-style block часто використовується gated MLP на базі SiLU/SwiGLU: одна projection створює gate, інша value-like branch, їх elementwise перемножують і проектують назад. Intermediate dimension зазвичай у кілька разів більша за hidden size.
Саме MLP часто містить найбільшу частину layer parameters. Attention вирішує, звідки взяти контекст; MLP нелінійно перетворює representation у кожній position. Зменшуючи `intermediate_size`, ви сильно зменшуєте model capacity і compute, навіть якщо кількість heads не змінюється.
32. Residual connections і RMSNorm: як не втратити сигнал у десятках layers
Кожен Transformer block додає результат attention/MLP назад до residual stream. Це створює highway для інформації та gradients: layer може навчитися невеликій correction замість повного переписування representation. Без residuals глибокі networks значно важче оптимізувати.
Normalization стабілізує scale activations. Багато сучасних decoder LLM використовують RMSNorm замість LayerNorm і pre-norm arrangement: norm перед sublayer, потім residual add. `rms_norm_eps` — маленька numerical constant. Це звучить як дрібниця config, але невдала normalization/initialization легко перетворює large training run на NaN generator.
33. Позиція: без неї «кіт вкусив собаку» і «собака вкусила кота» майже однакові
Self-attention сам по собі бачить набір vectors і не має природного поняття order. Старий Transformer додавав absolute positional encodings. Сучасні decoder LLM часто використовують RoPE — Rotary Position Embeddings, які обертають Q/K components залежно від position і кодують relative displacement у attention scores.
RoPE parameters і base/context extension мають значення, якщо ви хочете довгі contexts. Не починайте першу 100M-model із 128k context: training cost та memory attention різко зростуть, а corpus може не містити достатньо long-document signal. Краще 1k–2k context для smoke project, потім окремий long-context stage.
34. Context length — квадратний рахунок, який приходить непомітно
Для dense attention matrix має L×L pairwise scores на кожну head. Якщо sequence length збільшити з 2k до 4k, кількість attention pairs зростає приблизно у 4 рази. Інші частини model scale ближче до linearly with L, тому довгий context особливо тисне на memory та compute.
FlashAttention робить exact attention набагато практичнішим, мінімізуючи expensive reads/writes і не materializing повну attention matrix у звичайній формі. Але це не перетворює mathematical dense attention на O(L). Квадратичний compute нікуди не зникає; kernels лише радикально краще використовують hardware.
34A. Чому context 8k може коштувати не «вдвічі», а значно більше, ніж 4k
У classic dense attention кількість pairwise score interactions росте приблизно як L². Подвоїли sequence length із 4k до 8k — потенційна attention matrix стала у чотири рази більшою. FlashAttention радикально зменшує memory traffic і peak memory, але не скасовує саму залежність роботи від довжини sequence.
Саме тому open recipes часто навчають основну масу tokens на коротшому context, а потім роблять окремий long-context stage. SmolLM3 після основного pretraining додатково проходив довгі контексти staged-переходом, OLMo 3 теж має окрему long-context фазу. Це економічно логічно: не платити quadratic-like attention cost за трильйони коротких documents, яким 64k контекст взагалі не потрібен.
35. Як приблизно порахувати parameters до того, як створили model
У rough dense decoder count входить embedding V×d; для кожного layer attention projections (порядку кількох d², менше з GQA), MLP projections (порядку 3×d×d_ff для SwiGLU), плюс normalization/bias terms. Final output head або окремий V×d, або tied із embeddings.
Найнадійніше — не сперечатися з формулами після створення config: `sum(p.numel() for p in model.parameters())`. Але rough math потрібна до запуску, щоб побачити, куди йде capacity. Якщо у 70M-core model 25M parameters раптом сидять у embeddings через завеликий vocab, це може бути не той trade-off, який ви хотіли.
parameter_count = sum(p.numel() for p in model.parameters())
print(f"{parameter_count/1e6:.1f}M parameters")
Для нашої конкретної starter config арифметика вже достатньо точна. Vocab 32 768 × hidden 768 дає приблизно 25,17M embedding parameters. Один layer з GQA attention (12 query heads, 4 KV heads) і SwiGLU MLP дає близько 6,29M parameters; 12 layers — приблизно 75,52M. Додаємо final norm і отримуємо близько 100,7M parameters, якщо output head tied з embeddings. Тобто чверть model capacity у такій маленькій LLM реально може сидіти в vocabulary table — чудовий приклад того, чому tokenizer і architecture не можна проектувати окремо.
36. Наша starter architecture: навмисно маленька, але сучасна
У комплекті до статті є Llama-style config: hidden_size 768, 12 layers, 12 query heads, 4 KV heads, intermediate_size 2048, context 2048, RMSNorm, SiLU, tied embeddings. За vocab близько 32k це виходить приблизно у класі ~100M parameters — точне число script друкує перед training.
Чому не копія GPT-2? GPT-2 чудова для освіти, але Llama-style block ближчий до сучасної практики: RMSNorm, RoPE, GQA-friendly config, gated MLP. Чому не складні MoE/SSM/hybrid layers? Бо перша model має бути зрозумілою. Optimization debugging і так достатньо складний без routing collapse та expert parallelism.
36A. Розкладаємо ~100M model по кишенях: куди реально зникають parameters
Для starter-конфігурації з vocab приблизно 32 768 і hidden size 768 лише tied token embedding має близько 25,2 млн weights. Дванадцять Transformer blocks із attention та SwiGLU-подібним MLP додають приблизно ще 75 млн залежно від точних projection dimensions і GQA. Разом отримуємо порядок 100–101M parameters. Сам script все одно має друкувати точне sum(p.numel()).
Цей breakdown дає корисну інтуїцію: у маленьких multilingual models vocabulary може «з’їсти» чверть capacity. Збільшити vocab із 32k до 64k — це не безкоштовний tokenizer tweak: embedding matrix майже подвоюється. У 7B це відносно терпимо, а у 100M раптом змінює весь balance між lexical capacity і Transformer depth.
37. Ініціалізація weights: у першу секунду модель — чистий шум
Коли `LlamaForCausalLM(config)` створюється без `from_pretrained`, усі trainable matrices отримують random initialization за rules architecture/library. Перший logits distribution майже безглуздий: vocabulary probabilities близькі до випадкових, а validation loss приблизно відображає невпевненість на vocab size.
Не треба вручну «покращувати» initialization, доки не знаєте навіщо. Великі architectures часто мають спеціальне residual scaling, truncated normal або depth-dependent rules, але starter model краще залишити на перевіреній library initialization. Ваше перше завдання — переконатися, що loss finite і починає падати.
Є навіть корисний sanity check. Якщо logits на старті майже uniform по vocabulary, очікуваний cross-entropy приблизно дорівнює ln(V). Для vocab 32 768 це ln(32768) ≈ 10,40. Тому стартовий loss порядку 10–11 для random model не означає, що все зламано. Значно підозріліше — NaN, loss 100+, або loss, який після сотень steps взагалі не рухається.
38. Causal language-model loss: модель здає екзамен на кожному token
Якщо sequence має tokens x₁…xₙ, model на position t прогнозує xₜ₊₁. Cross-entropy бере negative log probability правильного next token. Loss усереднюється по всіх non-masked positions batch. В ідеалі model підвищує probability того, що реально відбулося, але не отримує окремого reward за «красиве пояснення» чи «правдивість» — тільки за predictive fit to data.
Саме тому quality corpus визначає поведінку base model. Якщо corpus містить SEO filler, model чесно вчиться бути хорошим SEO filler generator. SFT пізніше може змінити style, але pretraining формує величезну частину representations та priors. У causal LM inputs фактично є labels, зсунуті на один token; Transformers робить shift всередині model loss.
38A. Перший loss можна передбачити ще до запуску: приблизно ln(V)
Якщо random model на старті розподіляє probability майже рівномірно по vocabulary, probability правильного token близька до 1/V. Cross-entropy тоді близька до -ln(1/V)=ln(V). Для vocab 32 768 це приблизно 10,40. Це прекрасний smoke-test: стартовий loss порядку 10–11 виглядає логічно; 50, NaN або 0,02 — привід перевіряти pipeline.
Число не повинно збігатися до третього знака: initialization, padding/masking, tied head, data distribution і library details зрушують його. Але саме такі прості передбачення відрізняють engineering від шаманства. Перед кожним великим run сформулюйте кілька величин, які ви можете оцінити наперед: initial loss, parameter count, tokens/update, rough model-state memory, expected checkpoint size.
39. EOS між documents: маленький token, що каже «ця стаття закінчилася»
Коли ви concatenating short documents у довгі fixed-length sequences, вставляйте EOS між ними. Інакше model бачить штучний перехід: останнє речення статті про космос без маркера продовжується першим реченням Python tutorial. Вона може навчитися дивних cross-document associations.
Простий starter packer використовує EOS і дозволяє attention переходити через document boundary. Для маленького project це прийнятний compromise. Більш акуратні recipes, зокрема SmolLM3, використовують intra-document masking: tokens одного packed document не attend до попереднього unrelated document, хоча фізично вони лежать у тому самому GPU batch.
40. Packing: не платіть GPU за тисячі PAD tokens
Якщо training examples мають різну довжину й ви просто pad кожен до 2 048, короткі documents перетворюють більшість compute на множення нулів. Packing concatenates tokenized documents із EOS у повні blocks fixed length. GPU отримує майже 100% корисних tokens.
Важлива деталь implementation: не скидайте remainder після кожної map-batch. Якщо 100 коротких documents дали по 300 tokens, а function chunking працює batch-by-batch і викидає хвіст кожного batch, ви тихо втрачаєте великий шмат corpus. У starter kit buffer живе через увесь input file; production pipeline має робити те саме streaming-safe способом.
Частина V. Як реально оптимізувати training
41. Effective batch у LLM правильніше рахувати в tokens, а не examples
Для fixed sequence length global tokens per optimizer step приблизно дорівнює `micro_batch_per_gpu × sequence_length × gradient_accumulation × data_parallel_replicas`. Якщо у вас 2 sequences/GPU, 2 048 tokens, accumulation 32 і 4 data-parallel GPUs, це близько 524 288 tokens на update.
Це зручніша одиниця, ніж «batch 256», бо example може бути 512 або 8k tokens. Великий token batch зменшує gradient noise і покращує throughput, але надто великий batch може вимагати іншого learning rate та більше total tokens для same optimization progress. Починайте з recipe, який fits, і змінюйте batch лише з measurements.
tokens_per_step = micro_batch_per_gpu * seq_len * grad_accum * data_parallel_world_size42. AdamW: чому optimizer сам може займати більше memory, ніж weights
AdamW зберігає для кожного parameter не лише gradient, а й first moment та second moment estimates. Залежно від precision implementation можуть існувати FP32 master weights. У mixed-precision training rough memory до activations часто оцінюють порядку 12–16 bytes per parameter для weights + gradients + optimizer state. Це heuristic, не універсальна константа.
Звідси неприємний рахунок: 1B parameters — уже приблизно 12–16 GB лише model-state memory у такій rough оцінці, ще до activations, temporary buffers і CUDA context. 7B на одному 80GB GPU тому не «просто поміститься, бо weights у bf16 займають 14GB» — training state зовсім інший від inference.
42A. Memory budget: чому 24 GB VRAM не означають «12 мільярдів BF16 weights» під час training
Для одного поширеного mixed-precision AdamW режиму Hugging Face наводить грубу анатомію близько 18 bytes на parameter плюс activations: mixed-precision weights, FP32 optimizer moments, gradients та master state залежать від конкретної implementation. Це heuristic, а не закон для всіх сучасних optimizers/frameworks, але він чудово протвережує.
За цією оцінкою 100M parameters — близько 1,8 GB model state до activations; 300M — 5,4 GB; 700M — 12,6 GB; 1B — вже 18 GB. А ще потрібні activations, attention workspaces, CUDA context, dataloader buffers і тимчасові tensors. Саме тому «weights 1B у BF16 — лише 2 GB» абсолютно не відповідає training reality. FSDP/ZeRO, optimizer quantization або offload змінюють математику, але плату переносять у communication, CPU RAM, bandwidth чи stability.
43. Adam β₁, β₂ і weight decay: маленькі числа з великим бюджетом за спиною
Для LLM recipes часто зустрічаються AdamW β₁=0.9, β₂=0.95 і weight decay близько 0.1. SmolLM3 використовував саме 0.9/0.95 та decay 0.1. β₂ менше класичних 0.999 швидше адаптує second-moment estimate до changing gradients у massive token stream.
Але hyperparameters не треба копіювати як заклинання. Small 100M model, інший batch і інший scheduler можуть мати інший sweet spot. Найгірше — одночасно змінити β₂, LR, batch, context, data mix і architecture, а потім не знати, що допомогло. Зберігайте baseline і робіть controlled ablations.
44. Learning rate: найшвидший спосіб навчити model або підірвати її
LR визначає size update. Занадто малий — model витрачає compute, ледве рухаючись; занадто великий — loss oscillates, spikes або NaN. Для ~100M scratch model стартова величина порядку 3e-4–5e-4 може бути reasonable, але це не гарантія. Для fine-tuning LR зазвичай значно менший.
Дивіться не лише train loss. Підвищили LR — train loss падає швидше, але validation може стати гіршим, gradients — нестабільними, а samples — деградувати. Хороший experiment log містить LR curve, gradient norm, tokens seen, train/validation loss і checkpoint samples.
45. Warmup і scheduler: не бийте random network максимальним LR із першого step
У перші updates optimizer moments ще не стабілізовані, activations/gradients можуть мати незвичні scales. Warmup плавно піднімає LR від малого значення до target. У starter recipe ми використовуємо warmup_ratio 1% і cosine decay; це простий, зрозумілий baseline.
Large modern runs використовують і WSD — Warmup-Stable-Decay. SmolLM3 мав 2 000 warmup steps, довгу stable phase і linear decay в останніх 10% training. Перевага WSD — можна довше тримати high LR, а decay stage запустити ближче до планового end. Scheduler — частина recipe; checkpoint посеред stable phase не тотожний фінальному decayed model.
46. Gradient clipping: ремінь безпеки, а не спосіб керувати автомобілем
Global gradient norm іноді робить spike через outlier batch, numerical issue або раптову зміну data distribution. Clipping, наприклад max norm 1.0, обмежує update magnitude і може врятувати run від одного вибухового step. SmolLM3 також використовував gradient clipping 1.
Якщо gradients постійно clipping, це вже симптом: LR занадто великий, loss scaling нестабільний, data має pathological samples або model configuration погана. Не лікуйте системну аварію ще жорсткішим clip. Логуйте pre-clip norm і дивіться distribution.
47. BF16, FP16 і FP32: навіщо тренувати не в «повній точності»
FP32 дає великий numerical range/precision, але weights/activations займають більше memory і tensor cores працюють повільніше. FP16 удвічі компактніший, але має вузький exponent range, тому часто потребує dynamic loss scaling. BF16 зберігає exponent range близький до FP32 при меншій mantissa і для modern accelerators зазвичай зручніший для LLM training.
Вибір залежить від hardware. NVIDIA Ampere/Hopper добре підтримують BF16; інші GPUs можуть мати різні paths. На ROCm теж дивіться support конкретного accelerator. Starter script не вгадує: ви явно передаєте `--bf16` або `--fp16`. Якщо precision викликає NaN, перше завдання — зменшити complexity і перевірити FP32/smaller batch smoke test.
47A. RTX 3090 і BF16: Ampere справді вміє це апаратно, але перевіряйте software path
Офіційний GA102 whitepaper для RTX 3090 вказує 24 GB GDDR6X, 328 Tensor Cores третього покоління та BF16 Tensor throughput. Тобто BF16 для цієї карти не «емуляція на CPU». Але практичний результат залежить від PyTorch, CUDA, kernel backend і конкретної операції. Перед run перевірте torch.cuda.is_bf16_supported() і зробіть короткий BF16 smoke test саме вашим model stack.
TF32 — інша історія: він прискорює певні FP32 matrix multiplies на Ampere, зберігаючи FP32 storage/interface semantics, але це не те саме, що BF16 training. Для LLM зазвичай простіше мислити так: BF16/FP16 — основний mixed-precision path для tensors; TF32 — корисний режим Tensor Cores для FP32 matmul там, де framework його використовує. Не змішуйте назви лише тому, що всі вони «менше 32 bit усередині множення».
48. Один GPU: gradient accumulation і checkpointing купують memory за час
Якщо full global batch не fits, gradient accumulation робить кілька micro-batches, накопичує gradients і лише потім виконує optimizer step. Effective batch зростає без зберігання всіх examples одночасно. Ціна — більше forward/backward passes між updates, тобто wall-clock не магічно зменшується.
Gradient checkpointing економить activation memory: замість зберігати всі intermediate activations forward pass, частину recompute під час backward. Hugging Face docs прямо попереджають про speed penalty; rough magnitude може бути порядку десятків відсотків залежно від model. Це хороший trade-off, коли alternative — OOM. Найкраща optimization — не та, що має найвищий theoretical speed, а та, що дозволяє стабільно завершити run.
49. FlashAttention: швидше не тому, що математика інша, а тому що пам’ять перестає бути затором
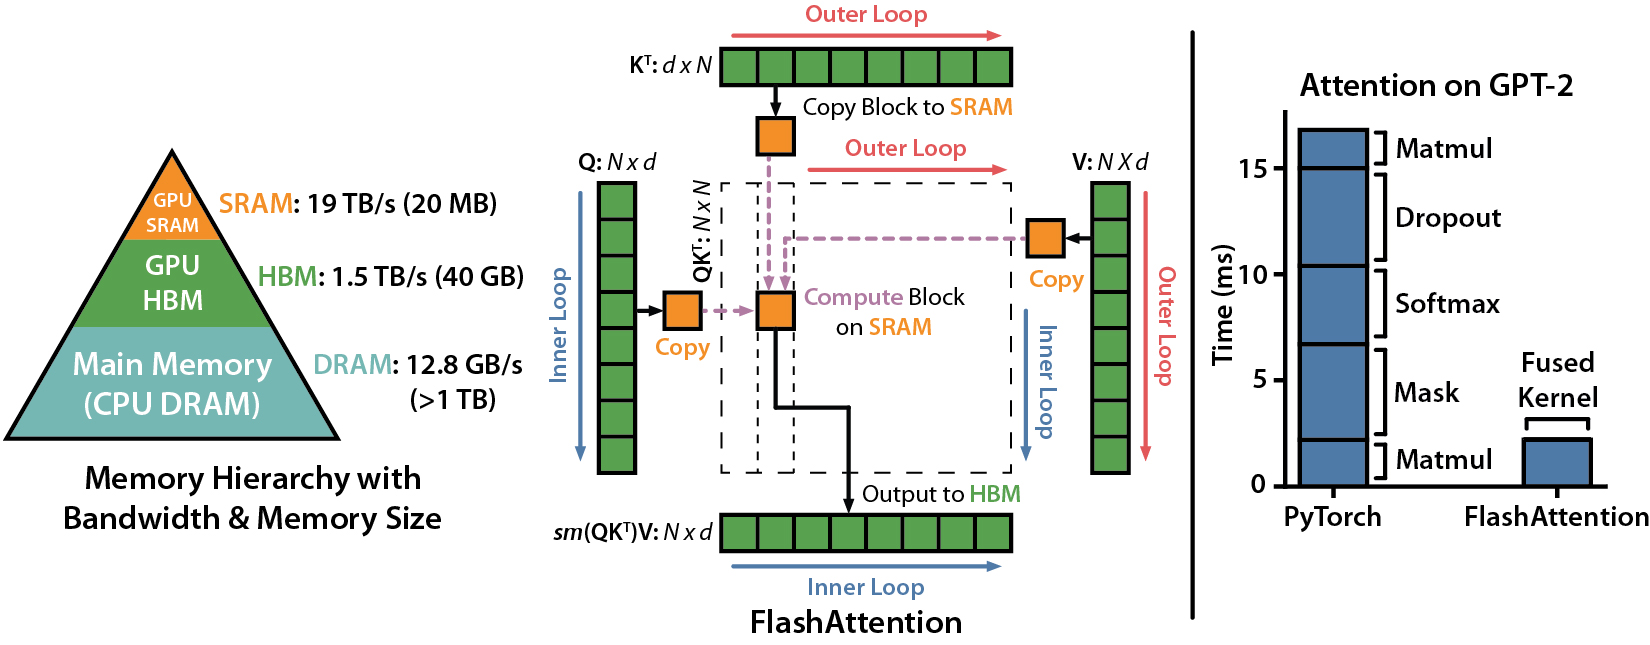
Naive attention записує/читає великі intermediate matrices з HBM, і memory traffic стає вузьким місцем. FlashAttention перебудовує exact attention calculation blocks так, щоб краще використовувати SRAM/cache і мінімізувати expensive HBM round trips. Результат — менше peak memory і значно кращий throughput на supported GPUs.
Це важлива nuance: FlashAttention не є approximation і не робить dense attention linear-time. Pairwise QK interactions усе ще quadratic за sequence length. Він просто виконує ту саму математику IO-aware способом. На довгих contexts різниця може бути драматичною, але сумісність залежить від GPU/CUDA/ROCm/kernel versions.
49A. SDPA, FlashAttention і torch.compile: спочатку використайте те, що вже оптимізував framework
Сучасний PyTorch має native scaled-dot-product attention, який може автоматично вибирати ефективні backend-и залежно від dtype, shape і hardware. Hugging Face Transformers у актуальних версіях використовує SDPA для підтримуваних моделей, а torch.compile може зменшити Python/kernel-launch overhead через graph compilation. Це означає, що перша optimization-стратегія не повинна бути «форкнути attention kernel».
Зробіть baseline, увімкніть supported SDPA/Flash backend, виміряйте tokens/sec, потім окремо протестуйте compile. Обов’язково перевірте correctness і memory peak: нова kernel path може бути швидшою на 4k, але програвати на вашому batch або викликати graph breaks. У LLM training performance — емпірична властивість конкретного stack, не список прапорців із README.
50. 100-step smoke test: найдешевші сто steps у всьому проєкті
Перший запуск робіть на маленькому slice data, з частими logs і checkpoints. Ви перевіряєте не quality model, а plumbing: JSON читається, tokenizer IDs у range, sequence length збігається з config, loss finite, backward працює, optimizer step відбувається, checkpoint записується, disk не забивається.
Після 100 steps обов’язково завантажте checkpoint окремим process і згенеруйте текст. Він ще буде поганий, але generation pipeline має працювати. Потім зробіть resume і переконайтеся, що step/optimizer/scheduler state продовжилися, а не почали з нуля. Один такий вечір економить дні cluster time.
51. 1 000-step pilot: тепер міряємо реальну економіку
На 1k-step pilot збирайте wall-clock, tokens/sec, GPU utilization, memory allocated/reserved, data-loader wait, checkpoint time, validation time та failure rate. Не extrapolate full run із перших 10 steps: kernels можуть compile, caches прогріватися, dataloader — ще не досягти steady state.
Коли throughput стабільний, порахуйте ETA і storage growth. Якщо 2B-token run займає 40 днів на вашому setup, краще дізнатися це до того, як ви купили data. Можливо, правильне рішення — 60M model, short context або rent faster GPU. Engineering — це не героїчно чекати, а змінювати design під constraints.
51A. MFU/HFU: як зрозуміти, чи GPU працює, чи просто красиво гріє кімнату
Tokens/sec дає найчесніший ETA, але для порівняння implementations корисна Model FLOPs Utilization — MFU. Ідея проста: оцінюємо, скільки model FLOPs на секунду реально виконує run, і ділимо на theoretical peak вибраного precision/hardware. Якщо utilization низький, причина може бути у маленьких matmul, data starvation, communication, frequent logging/checkpointing, поганому sequence packing або kernel overhead.
Не женіться за 100%: theoretical peak отримують у спеціальних умовах, а справжня модель має softmax, norms, communication, irregular shapes. MFU потрібна не для самолюбства, а для диференціальної діагностики. Було 28%, стало 39% при тому самому loss recipe — ви реально купили дешевші tokens. Стало 55%, але validation гірша через зміну batch/LR — ви прискорили не ту модель.
52. Checkpoints: зберігайте не лише weights
Для справжнього resume потрібні model weights, optimizer states, scheduler position, random-number-generator states і global step. Якщо зберегли тільки `model.safetensors`, ви можете продовжити training як новий run, але momentum/variance estimates AdamW і LR schedule будуть іншими. Це вже не точне продовження.
Checkpoint cadence — компроміс. Занадто рідко — аварія коштує багато hours; занадто часто — filesystem і pause overhead з’їдають throughput. Для pilot можна save кожні 500 steps, для large run — за wall-clock risk. Завжди тестуйте restore ще до великого запуску; backup, який ніхто не відновлював, — це лише optimism.
52A. Checkpoint має містити «машину часу», а не лише safetensors
Для відтворюваного resume зберігайте model weights, optimizer state, scheduler state, global step/tokens seen, RNG states Python/NumPy/PyTorch/CUDA, data-loader position або deterministic seed, tokenizer/config hashes і версію code. Якщо ви resume лише weights, це вже новий experiment: optimizer moments скинулися, LR schedule може початися не там, data order зміниться.
На multi-GPU PyTorch Distributed Checkpoint дозволяє паралельно save/load shards і може re-shard state при іншій topology. Для фінального public release окремо експортуйте portable Hugging Face/safetensors checkpoint. Training checkpoint оптимізований для швидкого resume, release checkpoint — для того, щоб чужа людина могла його відкрити через рік.
Частина VI. Один GPU, багато GPU і розподілене навчання
53. DDP: найпростіший multi-GPU режим — кожна GPU має повну model copy
DistributedDataParallel роздає різні micro-batches різним GPUs, але кожна GPU зберігає повну model і optimizer state. Після backward gradients синхронізуються all-reduce. Якщо model fits на одну GPU, це простий і часто найефективніший спосіб масштабувати throughput.
У starter script Hugging Face Trainer запускається через `torchrun`; data parallelism підхоплюється автоматично. Але global batch зростає з world size, якщо не зменшити micro-batch/accumulation. Не порівнюйте два runs із 1 і 8 GPUs, якщо вони фактично бачать різну кількість tokens per optimizer update.
# 4 GPUs on one node
torchrun --standalone --nproc_per_node=4 train_llm_100m.py --bf16
54. FSDP2: коли model state більше не поміщається на кожній GPU
PyTorch FSDP2 shards parameters, gradients і optimizer states між data-parallel ranks. Перед виконанням конкретного module потрібні parameter shards all-gather, після backward gradients reduce-scatter. У steady state кожна GPU зберігає лише частину великого model state, а не повну copy.
Ціна — communication і складніший checkpointing. FSDP не створює безкоштовну memory: activations нікуди не зникають, а all-gathers мають встигати за compute. Але для 1B+ models на кількох GPUs це часто перший серйозний крок після DDP. Поточна PyTorch лінія рекомендує FSDP2, тоді як FSDP1 вважається legacy/deprecated path.
55. DeepSpeed ZeRO: три stages, три рівні розбирання model state
ZeRO Stage 1 partition optimizer states; Stage 2 додає partition gradients; Stage 3 shards ще й parameters. У Stage 3 кожна GPU тримає лише свою частину states і отримує потрібні parameters на льоту. За логікою memory savings це близький родич fully sharded approaches, але DeepSpeed має власний runtime та ecosystem.
ZeRO-3/ZeRO-Infinity також може offload частину state на CPU/NVMe. Це дозволяє запустити model, яка інакше не fits, але PCIe/NVMe bandwidth легко перетворює «помістилося» на «тренується вічність». Offload — аварійний/економічний lever, а не substitute for profiling.
56. Megatron-style parallelism: коли одного sharding dimension уже мало
Data Parallelism ділить batch. Tensor Parallelism ділить великі matrix operations одного layer між GPUs. Pipeline Parallelism роздає різні groups layers по stages. Context Parallelism ділить sequence dimension, особливо корисно на 8k+ contexts. Expert Parallelism розподіляє MoE experts. У великих clusters ці dimensions комбінуються.
NVIDIA Megatron Core формулює просту mental model: total GPUs ≈ TP × PP × CP × EP × DP. Починайте з найпростішого. Якщо model fits — DP. Якщо один layer не fits — TP. Якщо model надто глибока/велика — PP. Якщо long context душить activations — CP. Додавати всі види parallelism у 100M project — чудовий спосіб перетворити навчання ML на тиждень debugging NCCL.
57. Data loader має годувати GPU швидше, ніж GPU їсть
Якщо utilization скаче 100% → 20% → 100%, проблема може бути не model, а input pipeline. Tokenization on-the-fly, gzip decompression, random small file reads, network storage або Python JSON parsing легко залишають GPU без batch. Pre-tokenized packed shards часто дають стабільніший throughput.
Для cluster training data shards мають бути достатньо великими для sequential reads, але не настільки, щоб checkpoint/resume чи shuffle стали незручними. Використовуйте prefetch, worker processes, pinned memory де доречно, local cache/NVMe, і вимірюйте dataloader time окремо від step time. Дорогий accelerator, що чекає disk, — найдурніший invoice у ML.
58. Що логувати: loss — лише перша лампочка на панелі
Мінімум: train loss, validation loss, LR, gradient norm, tokens seen, tokens/sec, samples/sec, GPU memory, step time, data time, checkpoint time. Для cluster додайте per-rank failures, communication time, hardware errors, network counters. Важливе правило: всі metrics мають бути прив’язані до tokens seen, а не лише step number, якщо batch/config змінюється.
Ще одна метрика — generated samples із fixed prompts. Loss може плавно покращуватися, а qualitative behaviour показати repetition loop, language drift чи broken code. Зберігайте samples поруч із checkpoint ID і config hash, щоб через місяць не шукати, «яка саме модель тоді красиво писала українською».
58A. Логуйте не лише gradients: parameters і activations часто попереджають про аварію раніше
Loss може виглядати нормально аж до step, на якому модель вибухне. Корисний monitoring дивиться на gradient norms, parameter norms, activation RMS/max, update-to-weight ratio, attention logits, fraction non-finite values, throughput і memory peak. OLMo-core навіть має окремий GAP monitoring підхід — gradients, activations, parameters — саме тому, що stability є багатовимірною.
Не треба писати terabytes histograms щосекунди. Виберіть кілька representative layers і лог interval. Якщо activation norm повільно росте протягом тисяч steps, ви побачите trend до NaN задовго до падіння. Це дає шанс зберегти checkpoint, знизити LR або знайти проблемний data shard.
59. Як читати loss curve: нормальна історія, overfitting і дивні стрибки
На scratch run loss спочатку падає дуже швидко: model вивчає token frequencies, spaces, punctuation, common syntax. Потім slope сповільнюється. Якщо train і validation падають разом — добре. Train падає, validation зупинився/росте — overfitting або data distribution mismatch. Обидва раптом стрибнули — шукайте LR/data/precision issue.
Якщо loss періодично робить spike саме на boundaries data shards, можливо один source bucket має інший quality/length distribution. Якщо spike збігається із checkpoint save — може бути I/O contention. Якщо лише один rank має NaN — hardware/communication. Не дивіться на curve як на horoscope; корелюйте її з system events і batch provenance.
60. NaN, OOM і «loss не падає»: аварійна діагностика
OOM: зменшуйте micro-batch, context, використовуйте checkpointing/FlashAttention, потім sharding. NaN: зменште LR, перевірте precision, gradients, corrupt inputs, token IDs, loss scaling; запустіть tiny FP32 baseline. Loss не падає взагалі: перевірте, чи labels не masked, optimizer бачить trainable parameters, data не constant, tokenizer/model vocab sizes збігаються.
Найкорисніша техніка — shrink the problem. 1 GPU, 2 layers, 128 context, 1k documents, FP32. Спробуйте overfit 100 batches. Якщо model не може memorise tiny dataset, ваш pipeline зламаний. Якщо tiny run працює, додавайте complexity по одному: mixed precision, full layers, long context, distributed.
60A. Найкращий debug-тест: змусіть модель переобучитися на одному tiny batch
Коли loss «не падає», перш ніж звинувачувати optimizer чи architecture, візьміть один маленький batch і тренуйте модель тільки на ньому. Здорова implementation повинна майже запам’ятати цей batch і знизити training loss дуже сильно. Якщо не може — проблема, ймовірно, у labels shift, masking, frozen parameters, optimizer step, gradient flow або tokenizer/data format.
Цей тест навмисно робить те, чого ми уникаємо в нормальному training — overfit. Саме тому він такий потужний. Ви прибираєте data diversity і generalization з рівняння та питаєте лише: «чи здатна ця computational graph взагалі вчитися?» Після проходження tiny-batch test повертаєте нормальний corpus і лише тоді шукаєте hyperparameter/data issues.
61. Staged training: не обов’язково весь час годувати модель однаково
У старих mental models pretraining — одна суміш data й один run від step 0 до finish. Сучасні open recipes частіше stage training. Спочатку broad web дає general language/world priors. Потім midtraining підсилює high-quality knowledge, code, math або domain. Окремий long-context stage навчає використовувати більший context після того, як core capability вже сформована.
OLMo 3 7B — прекрасний приклад: stage 1 5.93T tokens на 512 H100, stage 2 100B high-quality/midtraining tokens на 128 H100, stage 3 50B long-context tokens на 256 H100. Це не рецепт для копіювання numbers, а доказ, що «які tokens коли» може бути важливіше за один статичний mix.
62. Long-context training краще робити окремо, ніж платити за нього з першого token
Якщо кінцева model повинна читати 32k/64k context, tempting одразу pretrain на 64k. Але quadratic attention робить це дуже дорого, а більшість documents коротші. Ви витрачаєте compute на empty/weak long-range structure, коли model ще навіть не вивчила basic language.
Практичні recipes часто train core model на 2k/4k, а потім extend RoPE/context і midtrain на curated long documents із larger sequence. Потрібно перевірити position extrapolation, attention stability та packing/masks. Long context — capability, яку треба оцінювати спеціальними retrieval/needle/long-doc tasks, а не лише тим самим perplexity.
Частина VII. Evaluation і перетворення base model на помічника
63. Perplexity: корисний термометр, але не рейтинг інтелекту
Perplexity = exp(cross-entropy). Якщо loss 3.0, PPL ≈ 20: грубо кажучи, model поводиться так, ніби на кожній позиції має близько двадцяти equally plausible choices. Нижча PPL на тому самому held-out distribution зазвичай означає кращу predictive model.
Але PPL не можна чесно порівнювати між models із різними tokenizers: одна model може розбивати слово на 1 token, інша на 4, і loss per token має іншу одиницю. Також низька web perplexity не гарантує reasoning, instruction following чи factuality. Використовуйте PPL для checkpoints однієї training family, а не як універсальний leaderboard.
Якщо треба порівнювати systems із різними tokenizers, корисно дивитися на bits per byte або bits per character. Ідея проста: normalise negative log-likelihood не на кількість tokenizer tokens, а на обсяг вихідного тексту. Це не робить метрику ідеальною, зате прибирає частину «виграшу», який model отримує лише через іншу granularity tokenization.
63A. Bits-per-byte: коли perplexity бреше через різні tokenizers
Perplexity напряму залежить від tokenization. Модель із більшими tokens може мати іншу per-token cross-entropy просто через те, як вона ділить text. Тому порівнювати perplexity моделей із різними tokenizers небезпечно. Для більш tokenizer-neutral погляду можна нормалізувати negative log-likelihood на bytes або characters і отримати bits-per-byte/bits-per-character.
Це особливо важливо для української/російської multilingual роботи: tokenizer, який ріже кирилицю дрібніше, може виглядати гірше per-token не лише через слабшу language modeling. Зберігайте одночасно loss/perplexity вашого tokenizer-а й хоча б одну нормалізовану метрику на fixed raw-text eval set.
64. lm-eval: standardized benchmarks потрібні, але ваші власні — ще важливіші
EleutherAI lm-evaluation-harness дає reproducible interface до великої кількості academic benchmarks. Для local Hugging Face model можна запустити `lm-eval run --model hf --model_args pretrained=... --tasks ...` і зберігати samples/results. Це хороший regression layer між checkpoints.
Але English-heavy benchmark suite погано вимірює UK/RU technical model. Побудуйте власні held-out tasks: українська grammar/knowledge, російська technical QA, mixed-language code explanations, domain documents, hallucination traps, long context. Benchmark має відображати продукт, а не лише те, що зручно порівнювати з papers.
lm-eval run \
  --model hf \
  --model_args pretrained=./runs/rp-llm-100m \
  --tasks hellaswag \
  --output_path ./eval \
  --log_samples
64A. Multilingual evaluation: середнє число може приховати, що одна мова помирає
Якщо модель має UK/RU/EN mix, не зливайте все в один validation loss. Ведіть окремі curves за мовами й domains. Загальний loss може покращуватися, поки український погіршується через новий sampling mix, бо English bucket у десять разів більший і статистично перемагає.
Окрім loss потрібні generation evals: однакові за складністю prompts різними мовами, code-switching, transliteration, technical terminology, factual QA та instruction following. Перевіряйте також language leakage: чи не відповідає модель російською на український prompt або англійською після кількох technical terms. Це не дрібний UX-баг — це сигнал, що data/tokenizer/post-training balance зрушений.
64B. Generation settings — частина evaluation protocol
Один і той самий checkpoint може виглядати «розумним» при temperature 0.7 і божевільним при 1.5. Тому benchmark generation має фіксувати temperature, top-p/top-k, max tokens, repetition penalties, chat template і random seed там, де це доречно. Для deterministic tasks використовуйте greedy/controlled decoding; для creativity оцінюйте distribution кількох samples.
Не плутайте поліпшення sampling із поліпшенням model weights. Якщо нова модель виграла після того, як ви одночасно змінили prompt template і temperature, ви не знаєте, що саме стало краще. Versioned eval harness потрібен так само, як versioned training code.
65. Base model після pretraining ще не є «чат-ботом»
Base LLM вчилася продовжувати текст. На prompt «Поясни attention просто» вона може не відповідати, а продовжити його як заголовок статті, форумну цитату або список. Це не failure pretraining; objective ніколи не казав «слухайся користувача».
Instruction following з’являється під час post-training. SFT показує багато pairs prompt → ideal completion або conversations. Model вчиться format, tone, helpfulness, refusal patterns, tool syntax. Якщо base knowledge слабке, SFT не створить його з повітря; але правильний post-training перетворює «text predictor» на usable assistant.
66. SFT, LoRA і DPO: три останні сходинки до помічника
SFT на prompt-completion dataset навчає loss переважно на completion tokens: user prompt дає context, а model карається за неправильну answer. TRL у сучасному SFTTrainer прямо підтримує prompt-completion і packing. Full SFT змінює всі weights; LoRA може залишити base frozen і навчити лише low-rank updates — значно дешевше, особливо для великої pretrained model.
Після SFT можна додати preference data: один prompt, `chosen` хороший answer, `rejected` гірший. DPO оптимізує policy так, щоб chosen ставав відносно більш імовірним без окремого reward-model RL loop. Це не обов’язковий крок для першої 100M-model, але він завершує conceptual pipeline: pretraining вчить світ/мову, SFT — інструкції, preferences — вибір між кількома допустимими відповідями.
66A. Post-training у 2026 році: synthetic data, rejection sampling і online RL
SFT → DPO — хороший навчальний маршрут, але великі сучасні systems на цьому не зупиняються. Вони генерують synthetic tasks, запускають model у coding/test environments, збирають verifiable rewards, відкидають невдалі trajectories і знову тренують policy. Це змінює роль data factory: після pretraining вона вже виробляє не лише текст, а досвід взаємодії.
Rejection sampling — простий приклад: model генерує кілька відповідей, evaluator або unit tests залишають найкращі, після чого selected completions стають новими SFT examples. Online RL і agentic post-training йдуть далі: model діє у середовищі, отримує feedback і вчиться на outcomes. Kimi K2 — хороший відкритий приклад такого напряму: його authors описують large-scale agentic data synthesis і joint reinforcement-learning stage після pretraining.
Для першої домашньої 100M model це advanced appendix, а не обов'язковий checklist. Але важливо розуміти напрямок: frontier post-training дедалі більше схожий не на «дати моделі правильну відповідь», а на «дати їй задачу, середовище і спосіб перевірити результат».
66B. RLVR: коли відповідь можна перевірити програмою, reward стає набагато чеснішим
Reinforcement Learning with Verifiable Rewards особливо природний для math, code і structured tasks. Замість opaque reward model ви маєте verifier: чи правильне число, чи проходять unit tests, чи SQL query повертає очікуваний result, чи доказ задовольняє formal checker. OLMo 3 публікує post-training flow, де після SFT і DPO є RLVR stage.
Для домашньої 100M model це advanced territory, але принцип варто зрозуміти рано: найцінніший synthetic/reasoning data pipeline — той, де quality можна перевірити зовнішнім сигналом. Генерувати мільйон «роздумів» teacher-моделлю легко; довести, що вони ведуть до правильної відповіді, набагато важливіше.
66C. Distillation: інколи найкращий спосіб навчити маленьку модель — мати хорошого вчителя
Knowledge distillation переносить behavior/knowledge від сильнішої teacher model до меншої student. Найпростіший варіант — synthetic SFT: teacher генерує якісні відповіді, student навчається їх відтворювати. Більш «чиста» distillation може оптимізувати student за teacher logits/distribution, але це дорожче й вимагає доступу до logits.
Важливо не називати distillation «навчанням з нуля» у тому самому сенсі: student weights можуть стартувати random, але значна частина його поведінки походить від teacher. Для продукту це часто чудовий trade-off. Для науки/освіти окремо позначайте, що модель вивчила з raw corpus, а що — через teacher-generated supervision.
Частина VIII. Практика: запускаємо власний pretraining
67. Практика: створюємо project і environment
Тепер з теорії в роботу. У starter ZIP є scripts, які навмисно не ховають pipeline за магічним framework. PyTorch встановлюйте окремо під свій CUDA/ROCm stack; поверх нього — Transformers, Datasets, Tokenizers, Accelerate, TRL, PEFT. Версії у requirements зафіксовані станом на 22 серпня 2026 року, щоб API не «поплив» від випадкового update.
Для reproducibility збережіть `python --version`, `pip freeze`, driver/CUDA/ROCm versions, GPU model і git commit starter scripts. Якщо run піде добре, саме цей boring metadata дозволить відтворити його через три місяці. Не оновлюйте libraries посеред 10-day training без критичної причини.
python -m venv .venv
source .venv/bin/activate   # Windows: .venv\Scripts\activate
# Install PyTorch for your accelerator first.
pip install -r requirements.txt
68. Формат corpus: один JSON object — один document
Найпростіший portable input: JSONL, кожен рядок `{"text":"..."}`. Document boundary має meaning: article, source file, forum thread segment, code file. Не дробіть усе на 2k chunks до split/dedup — втратите provenance і створите leakage між train/validation.
Перед pipeline зробіть manifest із source ID, language, license bucket, quality score і hash, навіть якщо training JSONL містить лише text. Starter split script deterministic через SHA-256: той самий document завжди потрапляє в той самий split. Це зручно, коли corpus росте версіями.
{"text":"Перший повний документ..."}
{"text":"Другий документ..."}
{"text":"def hello():\n    return 'world'"}
69. Крок 1: split до tokenizer і training
Покладіть cleaned/deduplicated corpus у `data/all.jsonl`, потім запустіть deterministic split. За замовчуванням starter віддає 0.5% documents у validation. Для малого corpus можна зробити 1–5%, щоб validation мав достатньо examples. Test/golden eval краще тримати окремим файлом і не використовувати у tokenizer training.
Після split з training portion створюємо text file для tokenizer. Tokenizer може бачити тільки train: навіть vocabulary statistics теоретично є формою «навчання» на data, тому чистий experimental protocol не підглядає validation.
python split_jsonl.py --input data/all.jsonl \
  --train data/raw_train.jsonl --valid data/raw_valid.jsonl
python build_tokenizer_corpus.py --input data/raw_train.jsonl \
  --output data/tokenizer_corpus.txt
70. Крок 2: навчаємо ByteLevel BPE tokenizer
Starter викликає Hugging Face Tokenizers BPE trainer із 32 768 vocabulary size, minimum frequency 2 і чотирма special tokens. На невеликому corpus tokenizer training займає хвилини, не дні. Для великого corpus sampling кількох десятків/сотень GB часто достатньо — vocabulary statistics не потребують бачити кожен trillion token.
Після training script друкує sample tokenization/roundtrip. Додайте власний tokenizer QA notebook: українські compound words, російські endings, English acronyms, URLs, code identifiers, JSON, numbers. Якщо ви бачите багато UNK або decode не відновлює text, не переходьте до pretraining.
python train_tokenizer.py \
  --input data/tokenizer_corpus.txt \
  --output tokenizer \
  --vocab-size 32768
71. Крок 3: tokenization і packing у 2 048-token blocks
`prepare_dataset.py` читає кожен raw document, tokenizes без automatic special tokens, додає EOS і накопичує IDs у buffer. Щойно buffer має ≥2048 tokens, script записує fixed sequence. Remainder переходить до наступного document, тому короткі тексти не викидаються.
Важливий наслідок: packed files уже прив’язані до tokenizer version і sequence length. Якщо змінюєте tokenizer — rebuild dataset. Якщо змінюєте context із 2k на 4k — найкраще repack, а не випадково pair сусідні 2k samples всередині trainer. Для production data pipeline запишіть manifest із tokenizer hash та packer version.
python prepare_dataset.py \
  --tokenizer tokenizer \
  --train data/raw_train.jsonl \
  --valid data/raw_valid.jsonl \
  --seq-len 2048
72. Крок 4: перший pretraining run — не одразу 10 000 steps
Спочатку запустіть `--max-steps 100`, `--save-steps 50`, `--eval-steps 50`. Переконайтеся, що model друкує parameter count, tokens per optimizer step, loss падає, validation запускається, TensorBoard logs з’являються, checkpoints читаються. Потім 1 000 steps для throughput.
Лише після цього ставте 10k/100k/full token budget. Якщо GPU підтримує BF16 — передайте `--bf16`; інакше FP16 за умови стабільності. Micro-batch 2 і grad accumulation 32 — baseline, не обов’язкова істина. На 16GB може знадобитися micro-batch 1 або context 1024.
python train_llm_100m.py --bf16 --max-steps 100 \
  --logging-steps 5 --eval-steps 50 --save-steps 50
# then pilot
python train_llm_100m.py --bf16 --max-steps 1000
72A. OOM ladder: що змінювати по черзі, а не всі прапорці одразу
Коли CUDA каже Out Of Memory, рухайтеся від найменш руйнівних змін до найбільш радикальних. Спершу приберіть зайві tensors/processes і перевірте memory leak. Потім зменште micro-batch. Далі ввімкніть gradient checkpointing. Якщо все ще не fit — зменште sequence length. Після цього розглядайте efficient attention, optimizer memory tricks, FSDP/ZeRO/offload або меншу модель.
Чому не починати з CPU offload? Бо ви можете «вмістити» модель і перетворити GPU на дорогий пристрій, який постійно чекає PCIe. Чому не одразу batch=1? Бо надмірна gradient accumulation вбиває throughput. Змінюйте одну сходинку, записуйте peak VRAM і tokens/sec, залишайте найшвидшу конфігурацію, яка стабільно fit із невеликим запасом.
73. Крок 5: дивимося, коли шум починає перетворюватися на мову
Після першого checkpoint generation може бути набором частих symbols. Далі з’являються spaces/punctuation, короткі word-like fragments, синтаксичні patterns, а потім локальна coherence. Це одна з найцікавіших частин project: ви буквально бачите, як statistical structure corpus поступово записується в weights.
Не оцінюйте base model temperature=1.5 і одним prompt. Зберігайте fixed generation grid: кілька prompts × кілька seeds × temperature 0.2/0.7/1.0. Порівнюйте checkpoints. Repetition на low temperature може показати undertraining або sampling issue; хаос на high temperature ще не означає, що model погана.
python sample.py --model runs/rp-llm-100m/checkpoint-1000 \
  --prompt "Штучний інтелект — це" --temperature 0.8
74. Крок 6: validation loss і власні golden prompts
`eval_loss.py` обчислює cross-entropy/perplexity на packed validation. Запускайте його на checkpoints або використовуйте Trainer evaluation під час training. Додатково тримайте golden prompts, де ви руками дивитеся language separation, factual patterns, formatting і domain vocabulary.
Якщо validation loss найкращий на checkpoint 30k, а train loss продовжує падати до 50k — не автоматично беріть останній. Для base pretraining на великих unique corpora strong overfitting менш типове, ніж у fine-tuning, але маленький homemade corpus легко повторюється багато epochs.
python eval_loss.py --model runs/rp-llm-100m \
  --valid data/valid_packed.jsonl
75. Крок 7: SFT — навчаємо model відповідати, а не просто продовжувати
Підготуйте JSONL із `prompt` і `completion`. Тут quality важливіша за volume ще сильніше: краще 10k різноманітних, точних instruction pairs, ніж мільйон шаблонних synthetic «What is X? — X is…». Змішуйте explanation, transformation, extraction, coding, refusal/safety, multi-turn лише якщо ваш application це потребує.
Starter `sft.py` використовує TRL SFTTrainer, packing і completion-only loss. Для 100M-model full SFT дешевий. Для 7B pretrained base LoRA часто практичніша. Якщо model ще не знає domain facts, спочатку continued pretraining на domain corpus, а вже потім SFT — instruction examples не повинні бути вашою єдиною базою знань.
{"prompt":"Поясни self-attention простими словами.","completion":"Уяви, що кожне слово..."}
python sft.py --model runs/rp-llm-100m --train data/sft_train.jsonl --bf16
76. Крок 8: DPO — коли «правильних» відповідей кілька, але одна краща
Preference dataset містить prompt, chosen і rejected. Chosen не обов’язково «істина», а rejected — «брехня»: різниця може бути у точності, ясності, safety, форматі чи відсутності зайвої балаканини. Важливо, щоб preference criterion був послідовний, інакше model вчиться шуму evaluator-а.
DPO порівнює relative likelihood chosen/rejected відносно reference policy й оптимізує preference без окремої reward model + online RL. Для маленького домашнього model це факультативно. Але якщо ваша мета — assistant, SFT-only часто залишає rough edges, які preference optimization може прибрати.
{"prompt":"Що таке gradient clipping?","chosen":"Це обмеження норми градієнта...","rejected":"Це коли ми просто зменшуємо learning rate."}
python dpo.py --model runs/rp-llm-100m-sft --train data/dpo_train.jsonl --bf16
Частина IX. Як тренують великі моделі у 2026 році
77. SmolLM3: чому «маленька» 3B model може з’їсти 11.2 трильйона tokens
Hugging Face відкрив training recipe SmolLM3: 3B parameters, 11.2T training tokens, 384 H100 GPUs, 24 days. Є staged data mixtures, WSD schedule, 2 000 warmup steps, final 10% decay, DataTrove processing, nanotron training і LightEval. Це фантастичний reality check проти думки «3B — невелика, навчу за вихідні».
Але з нього треба взяти не hardware envy, а principles: багато ablations роблять на коротших 50–100B-token runs; data mixture змінюють по stages; context/architecture optimizations тестують до full run; вся recipe документована. Великий model run — фінальний manufacturing batch після десятків дешевших experiments.
77A. FP8, MXFP8 і NVFP4: frontier precision, яку не треба копіювати на RTX 3090
На великих кластерах precision стала окремим інженерним важелем. NVIDIA Transformer Engine підтримує FP8 training на Hopper, Ada і Blackwell, а Blackwell додає MXFP8 та NVFP4 recipes. Ідея та сама, що у mixed precision загалом: зменшити bytes per value і підняти throughput matrix operations, але не втратити training stability через dynamic range та scaling.
Для RTX 3090 це не ваш перший крок. GA102 — Ampere. Transformer Engine документує optimizations для FP16/BF16 на Ampere, але його FP8 path орієнтований на новіші architectures. Тому домашній рецепт залишається простим: BF16 або FP16 залежно від stack, gradient checkpointing, SDPA/FlashAttention-compatible kernels і вимірювання реального throughput. Не переносіть H100 recipe на 3090 лише тому, що число «8» виглядає дешевшим за «16».
77B. Data annealing і mid-training: фінальні tokens можуть бути дорожчими за перші
Сучасний pattern дедалі рідше виглядає як «один corpus mix від першого до останнього token». SmolLM3 змінює пропорції web/code/math у трьох pretraining stages і наприкінці сильніше піднімає high-quality code/math/reasoning data. OLMo 3 після масового pretraining робить 100B-token midtraining на більш цільовому mix, а потім окремий long-context stage.
Ідея інтуїтивна: на початку model потребує широкого світу й базової мови; ближче до кінця кожен дорогий token можна витратити на більш складні, чисті або стратегічні skills. Для маленької моделі це можна відтворити скромно: 80–90% budget на broad clean mix, фінальні 10–20% — на high-quality technical/code/math mix із lower LR/decay. Але зробіть A/B pilot: curriculum — hyperparameter, а не релігія.
78. OLMo 3: найкращий урок — відкритий model має показувати не лише weights
Allen Institute for AI публікує OLMo як research ecosystem із code, configs, checkpoints і training stages. OLMo 3 7B base описаний як 32-layer, hidden size 4096, 5.93T-token pretraining, потім 100B midtraining і 50B long-context stage. Pretraining stage використовував 512 H100; 32B версія — до 1 024 H100 на деяких stages.
Цінність для людини, яка тренує власну model, — reproducibility culture. Записуйте data manifests, exact configs, checkpoint lineage, evaluation і environment. Model без recipe — файл weights; model із recipe — експеримент, який інші можуть зрозуміти, критикувати й повторити.
78A. Muon і MuonClip: optimizer теж став полем для великих експериментів
AdamW досі лишається найнадійнішою стартовою точкою, але optimizer research знову став гарячим. Muon працює з matrix-shaped gradients і використовує orthogonalization; Kimi K2 пішов далі з MuonClip, додавши qk-clip для боротьби з attention-logit explosions. У technical report Kimi K2 authors повідомляють pretraining на 15.5T tokens без loss spikes у своєму recipe.
Найважливіший урок тут не «негайно замініть AdamW». Навпаки: новий optimizer — ще одна змінна, яка може зламати run. Спочатку зробіть strong AdamW baseline, зафіксуйте data, architecture, schedule і eval. Лише потім тестуйте Muon-like methods на коротких ablations. Frontier labs можуть дозволити собі optimizer research; домашній LLMник спочатку має дозволити собі відтворюваність.
78B. Model soup: іноді середнє двох checkpoints краще за ще один тиждень training
OLMo 3 і SmolLM3 показують ще один цікавий інструмент — model averaging/merging. Якщо кілька checkpoints або branches навчили різні корисні властивості, просте weighted averaging weights іноді відновлює capability, втрачений під час спеціалізованого post-training, без нового повного run. Це не гарантовано: два дуже різні basin/architectures просто усереднювати не можна.
Для домашнього experiment можна зробити безпечний тест: взяти кілька сусідніх late checkpoints одного run, усереднити weights і порівняти eval. Це схоже на snapshot ensembling без inference-ensemble cost. Але ніколи не видаляйте originals: merge — новий candidate checkpoint, не «покращення за визначенням».
79. Скільки у вас насправді data: рахуйте tokens, unique tokens і effective epochs
Розмір corpus у GB майже нічого не каже: code, Cyrillic, HTML і prose мають різну token density. Після final tokenizer порахуйте total unique training tokens у кожному bucket. Потім training budget / unique tokens дає effective epochs. Якщо у вас 500M unique tokens і ви плануєте 2B training tokens, model у середньому побачить corpus чотири рази.
Повторне проходження data не є автоматично поганим — маленькі models часто виграють від кількох epochs. Але ризик memorization росте, особливо для duplicated/high-weight sources. Логуйте per-source effective epochs, щоб «підсилити українську» не перетворилося на «одні й ті самі 20 сайтів прочитали 80 разів».
80. Коли зупиняти training: budget, validation і downstream eval мають голосувати разом
Є три stop signals. Перший — запланований token/compute budget. Другий — validation curve: чи ще є meaningful improvement на held-out data. Третій — downstream/golden eval: чи покращуються capabilities, які вам потрібні. Якщо validation loss падає на 0.01, а code tests/UK QA стоять на місці, додатковий compute може бути краще витратити на data mix або post-training.
Великий run краще мати planned decay/ending, а не просто натиснути Stop у випадковий step. LR scheduler формує фінальну quality. Якщо ви вирішили продовжити model значно довше, іноді правильніше перейти у новий stage із новим scheduler/data mix, ніж тягнути старий cosine до майже нульового LR.
81. Експорт: weights без tokenizer і config — напівмодель
Після training зберігайте model через `save_pretrained`, tokenizer поруч, config.json, generation defaults за потреби, data/model card і checksum. Формат safetensors зручний тим, що не виконує arbitrary pickle code при loading і добре підтримується ecosystem.
Перевірте clean-room load у новому environment: скопіюйте directory на іншу машину й запустіть `AutoModelForCausalLM.from_pretrained` + `AutoTokenizer.from_pretrained`. Якщо model працює лише у вашому training notebook із глобальними variables, ви ще не завершили artifact.
82. Quantization і serving: training закінчився, economics тільки почалася
Base weights у BF16 займають приблизно 2 bytes/parameter: 7B ≈ 14 GB лише weights. 8-bit/4-bit quantization може суттєво зменшити inference memory та bandwidth, але quality loss залежить від quantizer, activation outliers, calibration і task. Не quantize єдину копію model; зберігайте master checkpoint у training precision.
Для serving важливі KV cache, batch size, context length і tokens/sec/user. GQA допомагає KV cache, continuous batching підвищує utilization, speculative decoding може зменшити latency. Це вже окрема engineering дисципліна. Не оцінюйте model лише за «fits in VRAM» — measure first-token latency, decode tokens/sec, concurrency і cost per million generated tokens.
83. Safety evaluation починається до SFT, а не після скандалу
Перевіряйте base і instruct models на memorization, private-data regurgitation, toxic continuations, dangerous domain misuse, prompt injection/tool misuse, language-specific abuse. Для UK/RU потрібні локальні test sets: переклад English red-team prompts недостатній, бо образливі форми, політичні/історичні назви, slang і ambiguous instructions відрізняються.
Safety — не одна цифра. Може бути trade-off між refusal rate і helpfulness, між code security та general code capability. Логуйте category-level results і приклади. Якщо model використовується лише offline autocomplete, threat model один; якщо agent має credentials і виконує actions — зовсім інший.
84. Model card: напишіть правду про те, що ви створили
Хороша model card містить architecture, parameter count, tokenizer, context, languages, training tokens, data categories/provenance, known exclusions, training compute/hardware, optimizer/scheduler, checkpoints, evaluation, intended uses, limitations і license. Якщо model trained на data, яку ви не можете перелічити через business reasons, хоча б дайте category-level transparency.
Особливо напишіть, чого model НЕ вміє. Маленька 100M base model не повинна рекламуватися як «AI assistant». Якщо вона тренувалася на 1B technical tokens і добре autocomplete code snippets — так і скажіть. Довіра до open model починається не з benchmark screenshot, а з того, наскільки чесно автор описав training.
Частина X. Домашня лабораторія і фінальний маршрут
84A. Reproducibility card: model card без training ledger — половина історії
Окрім звичайного model card, зробіть machine-readable ledger: git commit training code, Docker/conda lockfile, GPU/driver/CUDA versions, tokenizer hash, dataset manifest hash, architecture config, optimizer/scheduler, precision, global batch у tokens, total tokens, seed, checkpoints, eval harness version і known incidents. Якщо run пережив NaN/restart/data shard replacement — запишіть це.
Open science тут збігається з хорошим бізнесом. Коли через пів року ви захочете зробити v2, цей ledger перетворить «здається, тоді було LR 3e-4» на відтворюваний baseline. А якщо модель публічна, користувачі отримують можливість зрозуміти її lineage замість маркетингового «trained on trillions of high-quality tokens».
85. Якщо у вас одна 24GB GPU: конкретний план без фантазій
Візьміть ~60–120M Llama-style model, 16k–32k tokenizer, context 1024 спочатку. Зберіть 0.5–1B добре очищених tokens. Запустіть micro-batch 1–4, gradient accumulation для ~64k–256k effective tokens/update, BF16 якщо supported, gradient checkpointing. На 100/1k steps виміряйте throughput і вже потім вирішіть full token budget.
Якщо 2k context fits і throughput прийнятний — піднімайте. Якщо ні — не соромтеся 1024: для навчального model це краще, ніж постійний OOM. Після pretraining зробіть 5k–50k instruction examples і full SFT. Ви отримаєте не «конкурента ChatGPT», а власну end-to-end LLM, де кожен token, weight і checkpoint пройшли через ваш pipeline.
Для RTX 3090 24 GB я б починав не з максимальної model, яка ледве влізла, а з максимальної model, яку ви можете стабільно дебажити. Практична ladder: 50–70M для перевірки pipeline; ~100M як перший справжній run; 250–400M як другий амбітний project після того, як ви вже знаєте свій tokens/sec, memory curve і checkpoint recovery. 700M–1B на одній 3090 технічно можна змусити жити через aggressive checkpointing/offload/коротший context, але wall-clock швидко стає головною проблемою.
python - <<'PY'
import torch
print(torch.cuda.get_device_name(0))
print('VRAM GB:', torch.cuda.get_device_properties(0).total_memory / 1024**3)
print('BF16 supported:', torch.cuda.is_bf16_supported())
PY
3090 має 24 GB GDDR6X і Ampere compute capability 8.6. На самому початку перевірте torch.cuda.is_bf16_supported() у вашому реальному PyTorch/CUDA stack, а не покладайтеся на старий форумний пост. Якщо BF16 path стабільний — він зручний через ширший exponent range; якщо library/kernel stack поводиться краще у FP16, використовуйте FP16 з відповідним loss scaling. Тут немає медалі за «модніший dtype» — є лише finite loss і throughput.
VRAM budget рахуйте шарами. Для 100,7M model самі BF16 weights — лише близько 0,2 GB; gradients — ще приблизно 0,2 GB; FP32 Adam moments — близько 0,8 GB. Але реальний peak набагато вищий через activations, temporary buffers, kernels, CUDA allocator fragmentation і те, як framework зберігає optimizer/master states. Саме тому sequence length і micro-batch часто «з'їдають» 3090 швидше, ніж самі weights.
Почніть з context=1024, micro_batch=1 і gradient checkpointing. Підніміть micro-batch до першого OOM, відступіть на один крок, потім тестуйте context 2048. Не оптимізуйте utilization до того, як model пережила 100-step smoke test і resume з checkpoint.
ETA рахується тільки після pilot. Якщо pilot показав, наприклад, 18 000 tokens/s, а ви хочете 1B training tokens, ідеальний compute-only time — 1e9 / 18000 ≈ 15,4 год. Додайте validation, checkpointing, startup, dataloader stalls і safety margin. Для electricity оцінка така сама проста: середня system power у kW × години × ваша ціна kWh. Спочатку виміряйте wattmeter або telemetry, а не вигадуйте цифру з TDP.
| Профіль | Parameters | Стартовий context | Мета |
|---|---|---|---|
| Debug | 50–70M | 512–1024 | Перевірити весь pipeline за години |
| First real | 90–130M | 1024–2048 | Побачити справжню language learning dynamics |
| Ambitious 3090 | 250–400M | 1024 | Навчитися жити з memory/throughput trade-offs |
| Research pain | 700M–1B | 512–1024 | Можливо технічно, але wall-clock уже карає |
85A. RTX 3090 під мікроскопом: чому стара gaming-карта досі цікава LLM-никам
Founders Edition RTX 3090 має 24 GB GDDR6X, 384-bit interface, близько 936 GB/s peak memory bandwidth і офіційний TGP 350 W. Для домашнього pretraining найцінніша характеристика — саме 24 GB VRAM: вона дає набагато більше свободи для activations/optimizer state, ніж типові 8–16 GB consumer cards. Ampere Tensor Cores також підтримують BF16/FP16/TF32 paths.
Але 3090 — не H100 у дешевому корпусі. Немає HBM, bandwidth/compute/communication зовсім іншого класу; consumer cooling і довгі 24/7 runs потребують уваги до температур VRAM, PSU і стабільності. Водночас для 50–300M scratch моделей це чудовий «мікроскоп»: достатньо швидкий, щоб експериментувати, і достатньо обмежений, щоб змусити вас зрозуміти memory economics.
85B. Чотири класи моделей для 24 GB: від комфортної лабораторії до боротьби за кожен мегабайт
За rough 18 bytes/parameter mixed-precision AdamW heuristic 100M model-state — близько 1,8 GB до activations, 300M — 5,4 GB, 700M — 12,6 GB, 1B — 18 GB. Тому 100M дає великий запас і дозволяє вчитися; 300M уже змушує уважно налаштовувати context/micro-batch; 700M може вимагати checkpointing і дуже малого batch; 1B на 24 GB із повним AdamW стає неприродно тісним без memory-optimizations.
Це не таблиця гарантій. Реальний footprint залежить від implementation, precision, tied embeddings, optimizer, layers, sequence length і kernels. Саме тому starter run повинен друкувати torch.cuda.max_memory_allocated() після forward/backward і benchmark-ити кілька configs. «Моя 700M fit» без context/batch/optimizer нічого не означає.
85C. Електрика: найдешевша формула, яку всі забувають
GPU-only lower-bound при 350 W TGP за 24 години — 8,4 kWh. Реальне споживання з розетки буде іншим: CPU, RAM, SSD, PSU efficiency, fans і power limit додають/змінюють цифру. Тому найкращий інструмент — розетковий wattmeter. Формула банальна: cost = average_wall_kW × hours × tariff_per_kWh.
Це перетворює «потреную пару тижнів» на бізнес-рішення. Якщо pilot показав 18k tokens/sec, ви знаєте ETA. Якщо wattmeter показав 470 W середнього wall draw, ви знаєте energy. Тепер можна порівняти локальний run із орендою H100/4090/іншого accelerator не за емоціями, а за вартістю мільярда оброблених tokens.
85D. Реалістичний 100M-проєкт на одній 3090: не починайте з «full run»
Я б будував його чотирма хвилями. Хвиля 1 — 10–50M tiny config на невеликому corpus, щоб перевірити tokenizer, packing, checkpoints і generation за години. Хвиля 2 — цільова ~100M architecture, але лише 100 steps. Хвиля 3 — 1k–5k steps для throughput, LR sanity і samples. Лише хвиля 4 витрачає запланований token budget.
Кожна хвиля має kill criteria. Tiny model не може overfit one batch — stop. 100-step loss не рухається — stop. Pilot дає NaN/нестабільний throughput — stop. Validation погіршується, коли train loss падає — перевіряємо data/LR/overfit. Така дисципліна здається повільною лише до першого разу, коли вона рятує 72 години безглуздого GPU time.
85E. 300M і 700M: навіщо йти вище, якщо 100M уже «говорить»
100M чудова для освоєння pipeline, але capacity швидко стає bottleneck: world knowledge слабка, reasoning крихке, multilingual interference помітне. 300M — хороший другий експеримент: architecture уже може утримувати ширші patterns, а training ще не перетворився на distributed-systems project. 700M дає ще більше capacity, але на одній 3090 wall-clock і memory trade-offs починають домінувати.
Тому піднімати model size варто лише після того, як 100M run довів, що data й evaluation pipeline працюють. Якщо 100M погана через spam corpus або tokenizer, 700M просто навчиться вашому spam дорожче. Найкраща причина збільшити model — не «поміщається», а конкретний capability gap, який scaling pilot справді покращує.
86. Якщо у вас 4–8 GPUs: де з’являється справжня свобода
На 4–8 modern GPUs можна підняти model до кількох сотень мільйонів або ~1B class, збільшити global batch і context, не вбиваючи wall-clock. Якщо model fits per GPU — спочатку DDP. Якщо model state тісно — FSDP2/ZeRO. Не переходьте на TP/PP, доки profiler не показав, що simple data parallel/sharding недостатньо.
У цьому scale bottleneck часто несподівано стає data. 8 GPUs можуть споживати hundreds of thousands tokens/sec; Python preprocessing, network disk і один compressed shard починають гальмувати. Pre-tokenize, shard, prefetch. І не забувайте, що в 8-GPU run global batch у 8 разів більший, якщо configs не змінити.
87. Фінальний алгоритм: що робити завтра вранці
1) Визначте model goal і 100 golden eval prompts. 2) Зберіть legal/provenance-aware corpus. 3) Clean → language ID → quality filter → exact/fuzzy dedup → benchmark decontam. 4) Split documents. 5) Навчіть tokenizer і зробіть QA. 6) Pack із EOS. 7) Створіть ~100M decoder. 8) 100-step smoke. 9) 1k-step throughput pilot. 10) Порахуйте ETA й тільки тоді full run.
11) Логуйте loss/LR/grad norm/tokens/sec і samples. 12) Test resume. 13) Оцінюйте validation + custom benchmarks. 14) Виберіть best base checkpoint. 15) SFT на clean instructions. 16) За потреби DPO/LoRA/safety tuning. 17) Export clean artifact + model card. 18) Виміряйте inference. Якщо ви пройшли всі 18 — ви не «погралися з нейромережею». Ви реально навчили свою LLM.
88. Найважливіший висновок: LLM народжується не в одному файлі train.py
Коли дивишся на фінальний code, здається смішним: модель можна створити кількома десятками lines, Trainer — ще кількома. Справжня складність розмазана по всій системі: data contracts, tokenizer, scaling, optimizer stability, hardware utilization, evaluation, checkpoint lineage, post-training. Саме тому великі labs — це не «люди, які знають секретний Transformer», а організації, що вміють стабільно виконувати тисячі правильних дрібниць.
І це хороша новина. Основні ідеї не магічні й не закриті. Transformer paper відкритий, modern recipes SmolLM3/OLMo документовані, frameworks доступні. Ви можете сьогодні навчити маленьку справжню LLM, побачити, як loss перетворює шум на мову, а завтра масштабувати кожну частину. Різниця між «я використовую AI» і «я розумію, як він вирощується» починається саме з першого власного run.
Частина XI. Як зрозуміти, що ви справді навчили модель, а не просто спалили електрику
89. Capability ladder: вимірюйте появу навичок як послідовність
Перші checkpoints не повинні одразу розв’язувати задачі. Спочатку зникає чистий шум: модель засвоює whitespace, punctuation, часті endings. Потім з’являються локальний syntax і короткі фрази. Далі — paragraph structure, domain vocabulary, прості facts, code patterns. Лише потім має сенс чекати стабільної instruction поведінки після SFT.
Збережіть однакові sample prompts на всіх checkpoints і складіть «фільм розвитку». Це один із найцікавіших результатів scratch-training: ви буквально бачите, як probability model поступово набуває структури. І це ще й diagnostic artifact — якщо на 30% run модель була кращою в українській, ніж на 80%, data schedule щось зламав.
90. Ablation table: змінюйте одну річ і вимагайте від неї доказів
Хочете 48k vocab замість 32k? Навчіть короткі matched pilots. Хочете GQA? Порівняйте throughput, memory і eval на однакових tokens. Хочете інший data mix? Зафіксуйте architecture/optimizer. Великі labs роблять сотні ablations не тому, що люблять таблиці, а тому що intuition у high-dimensional training часто помиляється.
Для домашнього проєкту достатньо spreadsheet із experiment ID, зміненою змінною, seed, tokens, wall time, max VRAM, train/valid loss, кількома eval scores і коротким verdict. Через 20 runs це стане вашою приватною «наукою про власну GPU» — набагато ціннішою за чужі універсальні magic hyperparameters.
91. Release gate: що має бути готовим, перш ніж назвати checkpoint «моделлю v1»
Мінімум: tokenizer/config/weights завантажуються з чистого environment; generation smoke test проходить; validation і multilingual/domain eval записані; known limitations описані; data/license provenance задокументована; unsafe memorization/secrets spot-check виконаний; model card містить intended use; hashes artifacts збережені. Для chat model окремо перевірте chat template й stop tokens.
Якщо хоча б один із цих пунктів відсутній, у вас може бути чудовий research checkpoint — просто не називайте його production-ready. Чесні labels «experimental base 100M» або «educational checkpoint» підвищують довіру значно більше, ніж спроба зробити вигляд, що домашній run конкурує з frontier labs.
92. Наступний крок після першої LLM: не більша модель, а кращий експеримент
Після першого успішного run найбільша спокуса — змінити 100M на 1B. Часто цікавіше зробити v2 того самого масштабу, але з кращим data mix, tokenizer, dedup, long-context stage або SFT. Якщо v2 на тих самих parameters помітно краща — ви навчилися будувати LLM. Якщо прогрес приходить лише від 10× більшої model, ви навчилися купувати compute.
Саме тут scratch-training перетворюється з одноразового трюку на дослідження. Ви вже маєте data factory, training factory, eval harness і baseline. Далі кожна гіпотеза — «чи допоможе більше українського science?», «чи вартий 48k tokenizer своїх embeddings?», «чи дає final code annealing приріст?» — стає вимірюваним експериментом. Це і є момент, коли у вас з’являється не просто модель, а власна лабораторія.
Не просто зрозуміти терміни, а пройти повний шлях від сирого корпусу до власної decoder-only LLM і потім зробити з неї instruct-модель.
- Зібрати, почистити, дедуплікувати й розділити корпус без витоку validation/test.
- Навчити власний ByteLevel BPE tokenizer для української/російської/коду.
- Ініціалізувати Llama-подібний decoder з нуля й запустити causal pretraining.
- Порахувати token budget, effective batch, memory trade-offs і приблизний compute.
- Перейти від одного GPU до FSDP/ZeRO/Megatron, а потім до SFT і DPO.
Масштаб: від домашнього експерименту до open frontier-style training
Реальна модель з random weights, яку можна навчати на одному сильному GPU.
3B model, 384 H100, 24 days.
Stage 1 on 512 H100s.
Після жорсткого quality filtering web data.
Не плутайте чотири різні види «навчання LLM»
| Режим | Що змінюємо | Коли це треба |
|---|---|---|
| Pretraining from scratch | Усі weights з random init | Нова базова модель/мова/архітектура, великі дані й compute |
| Continued pretraining | Усі або більшість weights готової base model | Домен, нова мова, новий knowledge distribution |
| SFT | Поведінку на instruction/answer examples | Перетворити base model на помічника |
| LoRA/PEFT | Малі low-rank adapters, base frozen | Дешева адаптація існуючої моделі, не pretraining з нуля |
Повний шлях до власної LLM
1. Специфікація
Мета, мови, domains, model size, context, eval і compute budget.
2. Дані
Provenance → cleaning → quality → dedup → decontamination → splits.
3. Tokenizer
Навчити vocabulary на training corpus і перевірити segmentation.
4. Pretraining
Random weights → next-token loss → checkpoints → validation.
5. Post-training
SFT → preference optimization → safety/evals → deployment.
Перед великим запуском у вас мають бути
- Заморожені train/valid/test manifests і data provenance.
- Tokenizer version + vocab + special-token contract.
- Model config, seed, optimizer, scheduler, batch formula.
- 100-step smoke test і 1k-step throughput pilot.
- Checkpoint/resume, validation loss і sample generation перевірені.
- Disk, network, data-loader і logging не відстають від GPUs.
Питання, які виникають перед першим run
Чи реально навчити LLM вдома?
Що важливіше: більше parameters чи більше data?
Чи обов’язково тренувати tokenizer?
LoRA — це навчання своєї LLM?
RTX 3090 як домашня LLM-лабораторія
GDDR6X — головна причина, чому карта досі зручна для домашнього scratch-training.
Офіційна специфікація GA102; реальний training throughput залежить від усього stack.
Номінальна потужність RTX 3090 FE; wall power усієї системи буде іншим.
Нижня оцінка при безперервних 350 W: 0,35 кВт × 24 год.
Що приблизно означає 24 GB VRAM
| Модель | Model-state за rough 18 B/param | Практичний сенс |
|---|---|---|
| 100M | ~1,8 GB + activations | Комфортний навчальний baseline; є запас для context/batch. |
| 300M | ~5,4 GB + activations | Реалістичний другий проєкт; уже важливі batch, context і kernels. |
| 700M | ~12,6 GB + activations | Можливо тісно: checkpointing, micro-batch 1 і вимірювання обов’язкові. |
| 1B | ~18 GB + activations | Повний AdamW часто стає неприродно тісним без memory tricks/offload/sharding. |
OOM: сходи, а не паніка
Перевірте витік
Закрийте зайві процеси, очистіть references, виміряйте peak VRAM на одному step.
Зменште micro-batch
Найменша зміна semantics; global batch можна повернути accumulation.
Gradient checkpointing
Міняємо VRAM на додатковий compute під час backward.
Скоротіть context
Особливо ефективно, якщо activations/attention є головним споживачем.
Efficient attention
SDPA/FlashAttention може зменшити memory traffic і peak.
Optimizer/sharding/offload
Лише після простих кроків: вони додають complexity і bandwidth costs.
Перед багатоденним run
- Tiny-batch overfit test проходить.
- 100-step smoke test проходить без NaN/OOM.
- 1k-step pilot дав стабільні tokens/sec і реальний ETA.
- Dataset/tokenizer/config мають hashes і manifest.
- Resume із checkpoint реально протестований.
- Окремі UK/RU/EN validation curves не деградують.
- Wall power/температури/диск мають запас для тривалого run.
- Definition of Done і kill criteria записані до старту.
Файли до статті
rankpoint_train_your_own_llm_starter_kit_2026-08-22
Джерела та перевірка
- Vaswani et al. / arXivAttention Is All You Need
- DeepMind / arXivTraining Compute-Optimal Large Language Models
- Hugging FaceTraining a causal language model from scratch
- Hugging FaceTokenizers Quicktour
- Hugging FaceFineWeb
- Hugging FaceFineWeb-Edu
- Lee et al. / arXivDeduplicating Training Data Makes Language Models Better
- Hugging FaceSmolLM3: smol, multilingual, long-context reasoner
- Allen Institute for AIOLMo 3 Model Training
- PyTorchGetting Started with Fully Sharded Data Parallel (FSDP2)
- DeepSpeedZeRO
- NVIDIAMegatron Core Parallelism Guide
- Dao-AILabFlashAttention
- Hugging FaceMethods and tools for efficient training on a single GPU
- Hugging FaceLlama model documentation / LlamaConfig
- Hugging Face TRLSFT Trainer
- Hugging Face TRLDPO Trainer
- Hugging Face PEFTLoRA conceptual guide
- EleutherAILanguage Model Evaluation Harness
- Lewis et al. / arXivRetrieval-Augmented Generation for Knowledge-Intensive NLP Tasks
- NVIDIATransformer Engine documentation
- Kimi Team / arXivKimi K2: Open Agentic Intelligence
- NVIDIANVIDIA Ampere GA102 GPU Architecture Whitepaper
- PyTorchGetting Started with Distributed Checkpoint (DCP)
Читайте більше
Коментарі0 коментарів
Коментарі