
В материале
164 разд.Часть I. Нужно ли вам вообще обучать LLM
1. Что мы вообще называем «обучить свою LLM»
Начнём с главного различия. Если вы загрузили готовую Qwen, Llama или Mistral и обучили LoRA на своих ответах — вы сделали полезный fine-tuning, но не создали базовую языковую модель с нуля. В этом гиде основной маршрут другой: tokenizer обучается на вашем corpus, weights инициализируются случайно, а модель впервые в жизни видит текст именно в вашем training run.
Это принципиально другой опыт. На старте модель буквально не «знает» ни русского, ни украинского, ни Python, ни даже того, что после открывающей скобки часто бывает закрывающая. Всё возникает через next-token prediction. Поэтому маленькая 100M-модель, которую вы сами провели от random noise до связного текста, часто учит устройству LLM больше, чем месяц экспериментов с промптами к чужой 70B-модели.
2. LLM — не база данных, а машина сжатия закономерностей
Полезная интуиция для pretraining: мы заставляем neural network сжимать статистическую структуру огромного text stream в parameters. Она не хранит корпус как SQL-таблицу. На каждой позиции модель получает предыдущие tokens и должна распределить probability mass по всему vocabulary: какой token следующий? Если правильный token получил низкую probability — loss большой; если высокую — маленький.
Повторите это миллиарды раз, и ради снижения loss model вынуждена создавать внутри полезные representations: орфографию, синтаксис, стили, факты, шаблоны кода, отношения между понятиями, часть world knowledge. Это не значит, что она «понимает» мир как человек. Но next-token objective удивительно жёстко вознаграждает всё, что помогает предсказывать продолжение.
3. Четыре маршрута: from scratch, continued pretraining, SFT и LoRA
From-scratch pretraining нужен, когда вы хотите собственную base model, тестируете architecture, строите модель для особого языка/последовательностей или хотите понять весь pipeline. Continued pretraining берёт готовую base model и продолжает next-token training на новом domain или language mix. Для продукта это обычно в разы практичнее, чем случайная инициализация.
SFT меняет прежде всего поведение: prompt → желаемая completion. LoRA — способ дешевле делать fine-tuning, замораживая base weights и обучая low-rank adapters. В реальном бизнесе часто выигрывает цепочка «готовая base → continued pretraining при необходимости → SFT/LoRA → preference tuning». Но чтобы понять механику, мы пройдём самый трудный путь — с нуля.
3A. Возможно, вам вообще не нужно обучать weights
Перед покупкой GPU стоит задать неприятный вопрос: какую именно проблему вы решаете? Если модель должна отвечать по вашим документам, каталогу, технической базе или знаниям, которые меняются каждую неделю, чаще всего правильный первый шаг — не pretraining, а RAG. Retrieval-Augmented Generation хранит знания во внешнем индексе, находит релевантные fragments во время запроса и добавляет их в context. Knowledge можно обновлять без переписывания миллиардов weights.
Если нужен другой стиль ответа, формат JSON, особая манера диалога или устойчивое instruction following — смотрите на SFT/LoRA. Если готовая base model уже знает язык, но плохо владеет вашей терминологией, кодом или domain — continued pretraining обычно дешевле training from scratch. И только когда нужны собственный tokenizer, base distribution, новая architecture, research-контроль или сам опыт построения LLM из random weights — from scratch становится логичным выбором.
| Ваша задача | Что пробовать первым | Почему |
|---|---|---|
| Свежие приватные документы и факты | RAG | Знания обновляются без retraining weights |
| Новый стиль/формат/поведение | SFT или LoRA | Учится поведение, а не base model с нуля |
| Глубокая адаптация к domain/language | Continued pretraining | Продолжается next-token learning на нужном distribution |
| Собственная base model или research | From scratch | Полный контроль tokenizer, data mixture, architecture и weights |
Эта таблица не отговаривает вас от собственной LLM. Она не даёт потратить месяц на самый дорогой инструмент там, где задачу можно решить за два дня более простым способом.
4. Сначала напишите test, а уже потом модель
До corpus и GPU сформулируйте, что значит «хорошая модель». Если цель — русско-украинский технический помощник, нужны отдельные held-out наборы русского, украинского, смешанного technical prose, code, factual QA и instruction-following. Если цель — code completion, важнее могут быть syntax validity, unit tests и pass@k. Без этого легко потратить две недели и получить красиво падающий loss, не понимая, стала ли модель полезнее.
Практический приём: до training создайте 50–200 «золотых» prompts, которые никогда не входят в corpus. На каждом checkpoint генерируйте samples. Это не заменяет benchmark, но быстро показывает regressions: модель начала повторяться, путать кириллицу, ломать Markdown или потеряла domain vocabulary.
5. Какого размера модель строить первой
Первый from-scratch project не должен быть 7B. Разумный учебный диапазон — примерно 50–150M parameters. Такая model уже достаточно велика, чтобы проявить настоящую language-model behaviour: syntax, короткие facts, style imitation, простые continuations. И при этом её можно запускать на одном 16–24 GB-class accelerator с маленьким micro-batch, mixed precision и gradient checkpointing.
Следующий класс — 300M–1B. Здесь data quality чувствуется гораздо сильнее, а один GPU быстро становится bottleneck. 3B+ — уже cluster territory, если нужна не игрушка, а сотни миллиардов или триллионы tokens. SmolLM3 отлично отрезвляет: «всего 3B» model обучали на 11.2T tokens с 384 H100 в течение 24 дней.
6. Parameters — это capacity, tokens — опыт
Представьте parameters как вместимость мозга модели, а tokens — как количество примеров жизни. Слишком большая model на маленьком corpus запоминает и недообучается. Слишком маленькая model на бесконечном corpus упирается в capacity. Scaling laws пытаются формализовать этот баланс.
Chinchilla показала, что при фиксированном training compute разумно одновременно масштабировать model size и число training tokens. Отсюда появился популярный грубый ориентир около 20 tokens на parameter для compute-optimal regime. Но это не закон природы: современные inference-oriented recipes часто обучают меньшие models на гораздо большем числе tokens, потому что дешёвая inference потом важнее минимального training compute.
7. Первая формула бюджета: C ≈ 6ND
Для dense decoder-only Transformer часто используют грубую оценку training FLOPs: C ≈ 6 × N × D, где N — число parameters, D — training tokens. Это не бухгалтерия до последнего multiply: attention, embeddings, recomputation и implementation details сдвигают цифру. Но для порядка величины формула очень полезна.
Например, 100M parameters × 1B tokens дают примерно 6×10^17 FLOPs. Это уже не «несколько минут Python». Но главный practical trick — не вычислять время из theoretical TFLOPS. Запустите 1 000 steps на своём hardware, измерьте real tokens/sec и только после этого extrapolate ETA. Реальный utilization может отличаться от marketing peak в несколько раз.
C ≈ 6 × N_parameters × N_training_tokens
ETA_days = total_tokens / measured_tokens_per_second / 86400
7A. FLOPs — теория, tokens/sec — ваша реальность
Формула C ≈ 6ND полезна для sanity check, но она не знает ничего о ваших kernels, драйвере, sequence length, data loader, gradient checkpointing или соседнем процессе, который внезапно забрал 3 GB VRAM. Поэтому главная единица домашней лаборатории — не TFLOPS с коробки GPU, а реальные tokens/sec после прогрева. Измеряйте их не на первых десяти steps: кеши, JIT/compile и filesystem могут сделать начало нерепрезентативным.
Хороший pilot: 50–100 warmup steps, затем несколько сотен стабильных steps и median tokens/sec. После этого ETA считается без магии: remaining_tokens / measured_tokens_per_second. Если после FlashAttention, checkpointing или нового batch size throughput вырос на 18% — это реальная экономия. Если красивее стали только theoretical FLOPS, а tokens/sec не изменились, ваш run не ускорился.
7B. Определите Definition of Done до покупки следующей GPU
Training LLM легко превратить в бесконечный проект: loss ещё падает, можно добавить data, ещё 100k steps, ещё benchmark. Поэтому до старта запишите критерии завершения: validation loss относительно baseline; отдельные UK/RU held-out curves; 100 golden prompts без деградации; отсутствие циклической генерации; code syntax/unit tests; проверка memorization на canary prompts.
Для первой 100M-модели честная цель может звучать скромно: «стабильно продолжает технический текст на двух языках и не разваливается через 500 tokens». Это уже инженерный успех. Definition of Done позволяет остановиться по результату, а не когда закончились деньги или терпение.
8. Три реалистичных проекта: домашний, лабораторный и кластерный
Домашний/учебный: ~100M parameters, context 1024–2048, 0.5–2B качественных tokens. На такой модели реально пройти corpus → tokenizer → checkpoints → sampling → SFT. Она не победит современные готовые assistants, но даст полный engineering experience.
Лабораторный: 300M–1B, примерно 10–100B curated tokens, одна или несколько машин с 1–8 GPUs в зависимости от context и stack. Кластерный: 3B+, сотни billions/trillions tokens, FSDP/ZeRO/Megatron, fast storage, observability и дисциплина уровня distributed systems. Границы условны: sequence length, architecture и accelerator сильно меняют memory/time.
Часть II. Data factory: откуда берутся хорошие tokens
9. У LLM две фабрики: data factory и training factory
Новички часто сразу открывают PyTorch. Большие команды сначала строят data factory: ingestion, normalization, language detection, quality scoring, exact/fuzzy dedup, PII filtering, source weighting, benchmark decontamination, tokenization, packing, manifests. Только потом training factory превращает это в gradient updates.
Это не бюрократия. Если GPU cluster дорогой, он не должен ждать Python parser, медленный network filesystem или gzip decompression. И ещё важнее: никакой optimizer не исправит corpus, где 30% SEO-spam, дубли форумных цитат и случайно включённые answers из validation benchmark.
10. Данные должны иметь provenance, а не просто папку «texts»
Для каждого source храните хотя бы origin URL/dataset, acquisition date, license/terms, language, domain, processing version и причину включения. Если через полгода выяснится, что один dump нужно удалить, без provenance вы не сможете ни найти его contribution, ни воспроизвести новый corpus.
Public web не означает «можно всё». Условия использования, copyright, privacy, opt-out requirements и jurisdiction различаются. FineWeb публикуется с data documentation и напоминает о source terms. Для коммерческой модели нужен отдельный legal review; технический гид его не заменяет.
11. Откуда брать corpus
Источники зависят от цели: licensed books/articles, Wikipedia и open encyclopedic corpora, Common Crawl derivatives, open code, public technical documentation, scientific papers с подходящими правами, forums/Q&A, собственные support logs после privacy review, synthetic data. Важна не максимальная смесь всего, а управляемый mix.
Для русско-украинской technical model я бы отдельно считал доли: русский качественный prose, украинский качественный prose, English technical/science, code, math/structured data. Если просто слить «всё, что нашли», English массой легко вытеснит меньшие языки, и model начнёт отвечать по-английски даже на кириллические prompts.
12. FineWeb-Edu: один из лучших примеров того, что качество бьёт количество
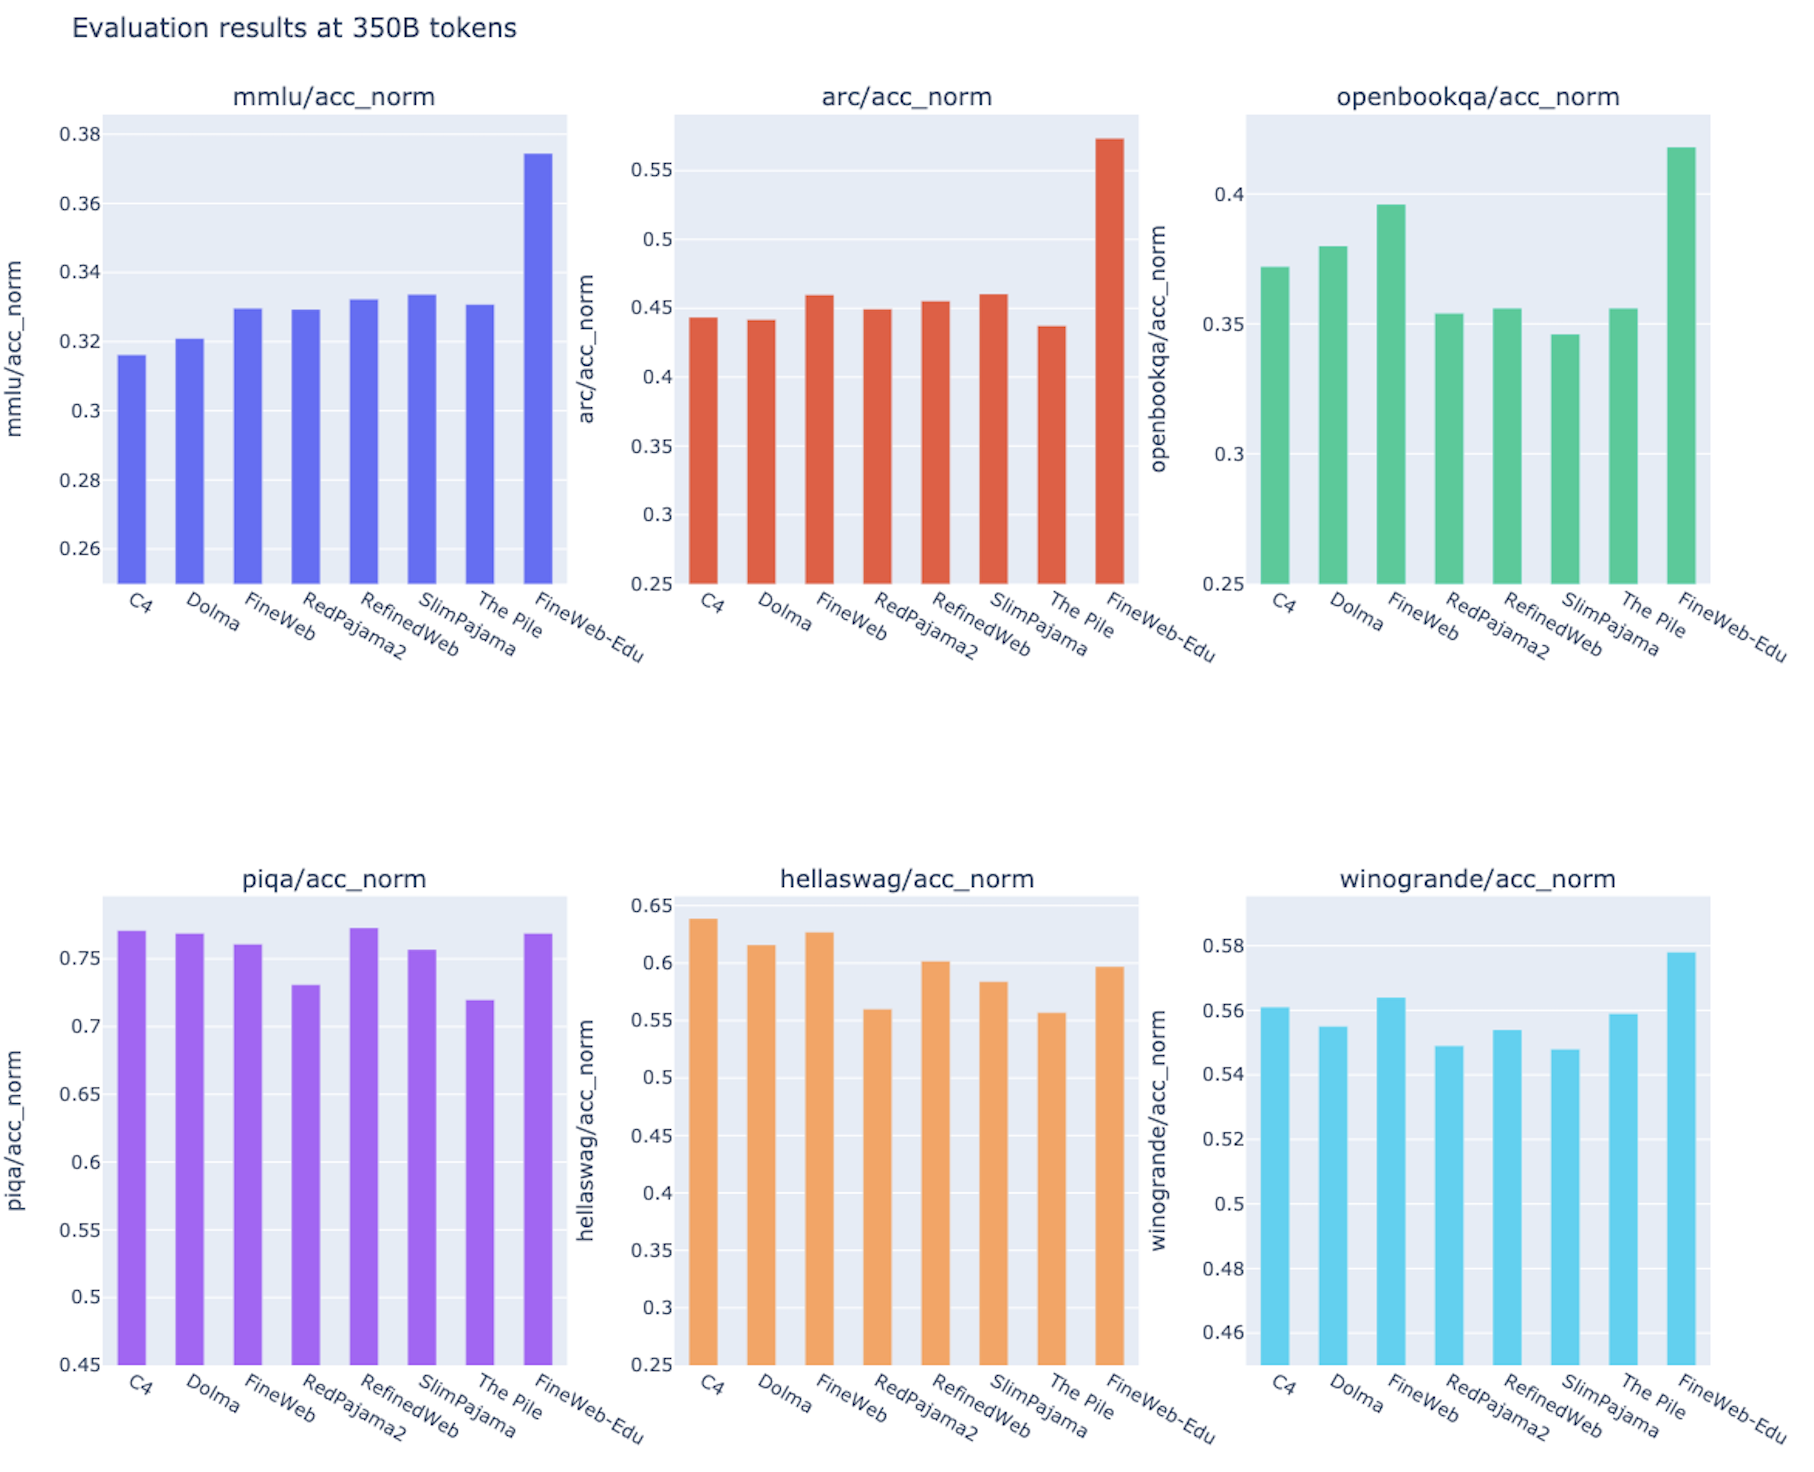
FineWeb-Edu начинался с огромного web corpus, но Hugging Face обучил classifier оценивать educational quality и оставил страницы выше threshold. При threshold 3 отсеяли около 92% данных — осталось примерно 1.3T tokens. При этом ablation models на filtered data показывали лучшие результаты на knowledge/reasoning benchmarks, чем на существенно большем сыром web mix.
Особенно показательна цена самого filtering: классификация примерно 15T tokens, по данным dataset card, потребовала около 6 000 H100 GPU-hours. Современное LLM engineering тратит серьёзный compute ещё до pretraining. «Data quality» давно не означает просто regex на HTML tags.
12A. Quality classifier — не оракул, а ещё одна модель со своими bias
FineWeb-Edu показывает силу quality filtering, но classifier оптимизирует именно то определение качества, которое вы задали labels. Если положительные примеры — академические англоязычные объяснения, он может систематически занижать живые русские/украинские технические обсуждения, короткую документацию, форумы или нестандартную математику.
Поэтому quality score лучше использовать как feature для sampling, а не абсолютный приговор. Стройте распределения score по языкам/domains, вручную смотрите samples из разных deciles, оценивайте false positives/negatives. Часто полезнее повысить sampling weight high-quality bucket, чем удалить всё «среднее» и потерять разнообразие.
12B. Source diversity: десять миллиардов tokens одного стиля — не десять миллиардов разного опыта
Два corpus одинакового размера могут дать очень разные модели. 10B tokens однотипной документации хорошо закрепят стиль, но сузят distribution. Смесь книг, science, code, Q&A, документации и качественного web даёт более широкую структуру задач. В manifest полезно считать не только bytes/tokens, но и independent documents, domains, hosts и collections.
Особенно опасны агрегаторы: тысячи URL иногда содержат один syndicated text. Exact/fuzzy dedup помогает, но source-level statistics показывают концентрацию раньше. Для маленькой модели diversity нередко ценнее ещё одного миллиарда почти одинаковых tokens.
13. Сначала убираем мусор: parsing и normalization
Web page — это не готовый training document. Там navigation, cookie banners, repeated headers, JavaScript fragments, comments, boilerplate, hidden text и encoding garbage. Data pipeline должен извлечь основной content и привести его к стабильному UTF-8 representation. Но «нормализовать» не значит стереть структуру: Markdown headings, code fences, lists и paragraph boundaries часто полезны модели.
Для mixed Cyrillic corpus отдельно проверяйте Unicode normalization, zero-width symbols, homoglyphs, broken mojibake и неестественные repetitions. Не заменяйте автоматически все «ё/е» или украинские апострофы ради воображаемой чистоты: так легко уничтожить настоящую языковую информацию. Лучше иметь измеримые rules и samples «до/после», а не магический скрипт из 200 regex.
14. Language identification: «кириллица» — это ещё не язык
Если вы тренируете multilingual model, определяйте language на document или даже paragraph level. Русский, украинский, белорусский, сербский имеют общие symbols, а technical text легко смешивает English terms и code. Примитивное правило «есть і — значит украинский» даст много шума.
Храните language confidence и не бойтесь класса unknown/mixed. Лучше иметь 3% документов для отдельной проверки, чем уверенно портить language balance. После tokenization посчитайте фактическую долю tokens по языкам: 30% documents по-украински не обязательно означают 30% tokens.
15. Exact dedup: самые дешёвые tokens — те, которые вы не тренируете дважды
Сначала удаляйте exact duplicates по hash нормализованного document или крупного chunk. Web corpora переполнены mirrors, copied press releases, duplicated terms pages и цитатами форумов. Если одна страница встречается 20 раз, model видит её как 20 голосов и тратит compute на repetition.
Exact dedup дёшев: canonicalize whitespace/encoding, вычислить stable hash, оставить одну representative copy и сохранить provenance всех duplicates. Не выбрасывайте source metadata: если одна копия имеет более чистую license/provenance, именно её лучше сделать canonical.
16. Fuzzy dedup: настоящий web почти никогда не дублируется байт в байт
Две новостные страницы могут содержать одну статью, но разные timestamps, меню или дополнительный paragraph. Exact hash их не поймает. Поэтому большие pipelines используют MinHash/LSH, n-gram fingerprints и другие approximate similarity techniques для near-duplicates.
Paper Deduplicating Training Data Makes Language Models Better даёт отличный «вау»-факт: авторы нашли 61-word sentence, повторявшийся более 60 000 раз. После dedup модели примерно в десять раз реже выдавали memorized text verbatim и требовали меньше train steps для той же или лучшей accuracy. Это одновременно quality, compute и privacy win.
17. Benchmark decontamination: не позволяйте модели списать экзамен
Если answers из benchmark попали в training corpus, evaluation перестаёт измерять generalization. Особенно опасны популярные MMLU-like questions, coding tasks, math problems и open benchmark repos, которые многократно копируют в tutorials и blogs.
Decontamination делают до training: строят fingerprints evaluation items и ищут exact/near matches в corpus, часто на n-gram level. Лучше немного переочистить training data, чем праздновать benchmark gain, который оказался leakage. Dedup paper показывал, что train-test overlap может затрагивать заметную долю standard validation datasets.
18. PII, secrets и токсичный мусор: «всё из интернета» — плохая стратегия
До pretraining ищите emails, phone numbers, addresses, API keys, access tokens, private identifiers и другой sensitive material. Regex — лишь первый слой: часть PII требует NER/classifiers, а secrets — entropy/pattern scanners. Для собственных customer logs нужны особенно строгие permission и anonymization rules.
Content filtering тоже должен быть целевым. Нельзя удалить «всё плохое», не потеряв полезный knowledge о security, medicine или history. Лучше иметь taxonomy: illegal/secret/PII, low-quality spam, explicit content, hate/toxicity, personal attacks, malware code и т.д. — и отдельную policy на каждый класс.
18A. Карантин данных: подозрительный документ не обязательно сразу удалять
Практичный pipeline выигрывает от третьего состояния между «train» и «delete» — quarantine. Туда уходят документы с secrets-like patterns, неуверенной language ID, странной license metadata, excessive repetition, benchmark fragments или высоким toxicity score. Затем выборку можно проверить вручную или более сильным classifier.
Так вы не уничтожаете легитимный security/code content, где API key — учебный пример, а не настоящий secret, и сохраняете audit trail: почему source не попал в training. В production возможность сказать «документ отклонён правилом X в pipeline v17» лучше безвозвратного rm -rf bad_data.
18B. Synthetic data: полезный ускоритель, но плохой единственный корм
Synthetic text помогает закрыть редкие domains, получить reasoning traces, переписать слабые объяснения или создать instruction pairs. Но если поколение моделей питается в основном outputs других моделей, distribution может сужаться: ошибки teacher размножаются, редкие человеческие стили исчезают, «AI voice» сам себя усиливает.
Маркируйте synthetic provenance отдельно: teacher/model/version/prompt, дедупликация от seed data, external verification. Самые ценные synthetic samples — math с verifier, code с unit tests, multilingual rewrites с quality checks. Принимайте sample не потому, что teacher написал уверенно, а потому что есть независимый сигнал качества.
19. Data mixture: corpus — это рецепт, а не ведро
После cleaning у вас есть buckets: web, books, code, math, science, Ukrainian, Russian, English, Q&A. Теперь нужны sampling weights. Если sampling пропорционален raw size, крупнейший bucket всегда победит. Если сделать equal weights, маленький dataset может повторяться сотни epochs и модель его запомнит.
Часто используют temperature sampling или вручную заданные weights с caps на oversampling. Для малых языков можно поднять probability, но следить за effective epochs: сколько раз каждый unique token будет увиден. Data mix — один из самых сильных hyperparameters; современные recipes вроде SmolLM3 меняют proportions по stages, усиливая code/math/high-quality data ближе к концу.
20. Train/validation/test split делайте на уровне documents — до packing
Разделяйте corpus до tokenization/packing, лучше deterministic hash by document. Если сначала разрезать documents на chunks, а потом случайно раскидать chunks по train и validation, соседние части одной статьи окажутся по обе стороны. Validation loss станет красивее, но будет лгать.
Для большого pretraining corpus validation может быть относительно маленьким — главное, чтобы он был representative и стабильным для сравнения checkpoints. Test set держите нетронутым до финальной оценки. Отдельно храните domain-specific eval, который не является просто «ещё 0.5% web text».
Часть III. Tokenizer: алфавит, который модель создаёт до обучения
20A. Dataset manifest — это git commit ваших данных
Для многодневного run фраза «примерно тот же corpus» неприемлема. Сохраните список shards, SHA-256/ETag, число documents/tokens, tokenizer hash, processing version, sampling weights и seed. Для streaming data зафиксируйте способ детерминированного воспроизведения порядка.
Через месяц вы сможете повторить experiment, изменив одну переменную. Если validation выросла, это действительно optimizer, а не тихо обновившийся web dump. Именно поэтому полноценные open recipes ценны не только weights, но и configs, data mixes, checkpoints и logs.
20B. Canary strings: простой датчик memorization
Можно создать несколько уникальных безопасных canary strings, которые намеренно встречаются в training corpus известное число раз. После checkpoints проверяйте, воспроизводит ли модель их по короткому prefix. Это не заменяет privacy audit, но отлично показывает механизм запоминания.
Сделайте один canary с frequency 1, другой 10, третий 100 — и увидите, как repetition повышает memorization pressure. Затем повторите опыт после dedup. Это превращает абстрактную фразу «дубликаты вредны» в эксперимент, который видно собственными глазами.
21. Tokenizer — компрессор между текстом и нейросетью
Transformer не читает letters. Он читает integer token IDs. Tokenizer определяет, станет ли слово «электромагнитный» одним token, тремя morpheme-like pieces или двадцатью bytes. Это напрямую влияет на effective context, training cost и способность model видеть patterns.
Плохой tokenizer для вашего языка — скрытый налог. Если русский/украинский текст разбивается вдвое мельче English, то 2 048-token context содержит меньше смысла, а каждый billion слов стоит больше training FLOPs. Поэтому from-scratch model заслуживает from-scratch tokenizer.
22. BPE, WordPiece, Unigram: что выбрать
BPE начинает с мелких symbols и постепенно merge самые частые соседние pairs. WordPiece похож, но выбирает merges по другой scoring logic. Unigram стартует с большого набора pieces и удаляет менее полезные, оптимизируя probabilistic model. Все три работают; разница часто меньше, чем разница между хорошим и плохим corpus tokenizer-а.
Для практического RU/UK/English/code starter мы используем ByteLevel BPE. Byte-level base гарантирует, что почти любой UTF-8 input можно представить без UNK на каждый новый символ, а merges сжимают частые patterns. Это удобно для mixed alphabets, punctuation, source code и редких symbols.
23. Vocabulary size: 8k, 32k, 64k — это не косметика
Маленький vocabulary даёт длиннее sequences, зато embedding/output matrices меньше, а rare words комбинируются из reusable pieces. Большой vocabulary сжимает текст в меньшее число tokens, но каждый token имеет отдельный vector, а rare pieces обучаются редко. Для маленькой model огромный vocab может съесть непропорционально много parameters.
32k — хороший practical starting point для multilingual/code model, но не святое число. Сделайте tokenizer ablation: 16k/32k/48k на sample corpus, посчитайте tokens per character/word по языкам и code, проверьте suffixes, identifiers, numbers и punctuation. Выбирайте по statistics, а не потому что «у Llama примерно так».
23A. Tokenizer fairness: одинаковые 2 048 tokens могут содержать разное количество смысла
Для multilingual model считайте characters/token, words/token и bytes/token отдельно для RU, UK, English, code и math. Если один язык требует заметно больше tokens для того же объёма текста, он получает меньший semantic context и более дорогой training budget. Это уже fairness и compute, а не эстетика tokenizer-а.
Смотрите не только mean/median, но и tails: URLs, длинные слова, formulas, snake_case identifiers. Хороший 32k tokenizer — тот, который стабильно ведёт себя на ваших domains, а не выигрывает один красивый пример.
24. Special tokens — маленький контракт, который потом трудно забыть
Минимальный набор: PAD, UNK, BOS, EOS. Для pure causal pretraining BOS иногда не нужен в каждом sample, а PAD почти не используется в packed dataset, но downstream libraries ожидают чёткие IDs. Зафиксируйте их одинаково в tokenizer config и model config.
Не добавляйте сразу сотни «будущих» special tokens. Каждый занимает vocabulary slot и требует semantics. Chat markers можно добавить перед SFT, но изменение tokenizer после pretraining требует resize embeddings, а новые rows стартуют random/untrained. Лучше продумать format заранее.
25. Проверка tokenizer: не доверяйте одному красивому примеру
После training tokenizer прогоняйте тысячи samples и стройте statistics: average tokens/character, tokens/word, percentile sequence expansion, fraction byte-level fallback pieces, distribution по languages/domains. Отдельно смотрите URLs, numbers, formulas, Markdown, code, emoji, Cyrillic-English switches и long identifiers.
Ручной smoke test тоже бесценен: encode → decode должен возвращать тот же meaningful text; common technical words не должны рассыпаться на десятки pieces; русские и украинские окончания должны выглядеть разумно. Если tokenizer плох, больший Transformer его не «вылечит» — вы просто дороже обучите модель плохому alphabet.
Часть IV. Transformer под микроскопом
26. Decoder-only Transformer: почему он стал стандартом генеративных LLM
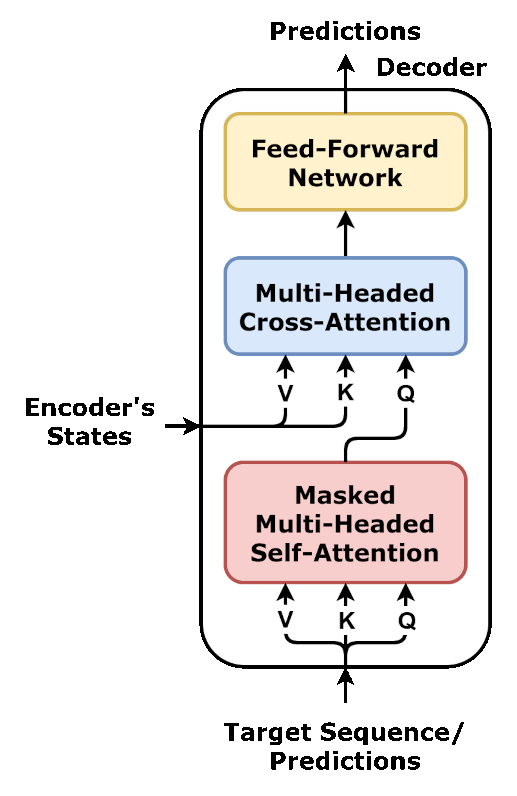
Оригинальный Transformer 2017 года имел encoder и decoder для sequence-to-sequence задач. GPT-подобные LLM отбросили encoder и оставили stack causal decoder blocks. На входе tokens превращаются в vectors, затем каждый layer смешивает информацию через self-attention и MLP, а финальный linear head выдаёт logits следующего token.
Causal означает, что позиция t не видит future tokens t+1, t+2… На training predictions для всех positions считаются параллельно благодаря triangular attention mask. На generation future ещё не существует, поэтому модель autoregressively добавляет token за token.
27. Embedding: первый перевод из token ID в геометрию
Integer 17342 сам по себе ничего не означает. Embedding table превращает каждый token ID в dense vector размерности d_model, например 768 или 4096. В начале vectors random. Training постепенно размещает related tokens в полезной high-dimensional geometry, хотя «сходство» там сложнее простой semantic карты.
Embedding matrix имеет V × d parameters. Для vocab 32k и d=768 это около 24.6M weights — огромная доля 100M-model. Поэтому vocabulary size особенно болезнен в маленьких architectures. Tied embeddings позволяют использовать одну matrix для input embeddings и output logits projection.
28. Self-attention: каждый token задаёт вопрос всем предыдущим
Для каждого hidden vector layer создаёт Query, Key и Value через learned projections. Интуитивно Query спрашивает «что мне сейчас нужно?», Key описывает «что я могу предложить?», а Value — «какую информацию передать, если меня выберут». Scores — scaled dot products Q·K; softmax превращает их в weights; weighted sum Values формирует новый representation.
В causal model matrix scores маскируется выше diagonal, чтобы future positions имели probability −∞ до softmax. Именно это позволяет token в конце предложения напрямую обратиться к имени, числу или variable, появившимся сотни positions раньше.
Q = X W_Q
K = X W_K
V = X W_V
Attention(Q,K,V) = softmax(Q K^T / sqrt(d_k) + causal_mask) V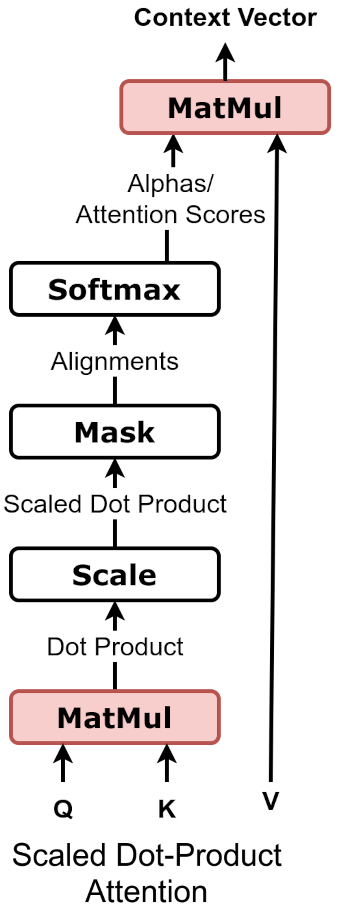
28A. Softmax и numerical stability: обычный exp способен превратить attention в NaN
Exponentials быстро переполняются. Поэтому стабильный softmax перед exponentiation вычитает максимум из всех logits строки. Probability не меняется, зато самый большой exponent становится exp(0)=1 вместо гигантского числа.
Это хороший урок для всего LLM engineering: математически правильная формула ещё не гарантирует устойчивую реализацию в finite precision. BF16/FP16, fused kernels, normalization и accumulation dtype решают, закончится ли ночь checkpoint-ом или NaN.
29. Multi-head attention: одна голова не должна делать всё
Вместо одного большого attention mapping hidden dimension делят на heads. Разные heads могут специализироваться на разных relations: local syntax, indentation, quotation boundaries, long-range references, positional patterns. Не стоит буквально приписывать каждой head одну человеческую роль, но parallel subspaces повышают expressiveness.
После attention outputs всех heads concatenated и projected обратно в d_model. Число heads должно делить hidden size; head dimension часто держат в привычном диапазоне, например 64/128, но современные architectures сильно различаются. Важнее sensible dimensions и реальный throughput, чем копирование чужого числа heads.
30. GQA и MQA: почему Key/Value heads можно иметь меньше
В classic multi-head attention каждая query head имеет собственные K и V projections. Multi-Query Attention делит один K/V head между всеми query heads; Grouped-Query Attention — компромисс, где группа Q heads делит K/V. Главная выгода особенно заметна на inference: KV cache становится меньше и снижается memory bandwidth.
Current Llama-style configs имеют `num_key_value_heads`, поэтому в starter model мы ставим 12 query heads и 4 KV heads. Это не магический optimum. Для маленького experiment можно использовать full MHA; GQA интересна, если нужна architecture ближе к современным deployment-oriented LLM.
30A. QK normalization: иногда attention сначала надо укротить
На больших масштабах magnitudes Query/Key могут расти, attention logits — взрываться, softmax — насыщаться. Современные architectures используют normalization/clipping-подобные механизмы. Kimi K2 описывает MuonClip/qk-clip как средство против attention-logit explosions.
Для первой 100M-model это не повод усложнять block. Оставьте baseline простым, но логируйте activations, gradients и при необходимости attention-logit statistics. Тогда при масштабировании вы увидите симптом до финального NaN.
31. MLP/SwiGLU: большая часть parameters живёт не в attention
После attention каждый position независимо проходит feed-forward network. В Llama-style block часто используется gated MLP на базе SiLU/SwiGLU: одна projection создаёт gate, другая value-like branch, они elementwise перемножаются и проектируются обратно. Intermediate dimension обычно в несколько раз больше hidden size.
Именно MLP часто содержит большую часть layer parameters. Attention решает, откуда взять контекст; MLP нелинейно преобразует representation в каждой position. Уменьшая `intermediate_size`, вы сильно уменьшаете model capacity и compute, даже при том же числе heads.
32. Residual connections и RMSNorm: как не потерять сигнал в десятках layers
Каждый Transformer block добавляет результат attention/MLP обратно в residual stream. Это создаёт highway для информации и gradients: layer может обучить небольшую correction вместо полного переписывания representation. Без residuals глубокие networks гораздо труднее оптимизировать.
Normalization стабилизирует scale activations. Многие современные decoder LLM используют RMSNorm вместо LayerNorm и pre-norm arrangement: norm перед sublayer, затем residual add. `rms_norm_eps` — маленькая numerical constant. Неудачная normalization/initialization легко превращает большой training run в NaN generator.
33. Позиция: без неё «кот укусил собаку» и «собака укусила кота» почти одинаковы
Self-attention сам по себе видит набор vectors и не имеет естественного понятия order. Старый Transformer добавлял absolute positional encodings. Современные decoder LLM часто используют RoPE — Rotary Position Embeddings, которые вращают Q/K components в зависимости от position и кодируют relative displacement в attention scores.
RoPE parameters и context extension важны для длинных contexts. Не начинайте первую 100M-model со 128k context: training cost и memory attention резко вырастут, а corpus может не иметь достаточного long-document signal. Лучше 1k–2k для smoke project, потом отдельный long-context stage.
34. Context length — квадратный счёт, который приходит незаметно
Для dense attention matrix имеет L×L pairwise scores на каждую head. Если sequence length увеличить с 2k до 4k, число attention pairs растёт примерно в 4 раза. Другие части model масштабируются ближе к linear with L, поэтому длинный context особенно давит на memory и compute.
FlashAttention делает exact attention намного практичнее, уменьшая expensive reads/writes и не materializing полную attention matrix обычным способом. Но mathematical dense attention не становится O(L). Квадратичный compute остаётся; kernels просто гораздо лучше используют hardware.
34A. Почему context 8k может стоить заметно больше, чем просто два context 4k
В classic dense attention число pairwise interactions растёт примерно как L². Подвоили sequence length — потенциальная attention matrix выросла в четыре раза. FlashAttention сильно снижает memory traffic и peak memory, но не отменяет сам объём работы.
Поэтому современные recipes часто делают основное pretraining на более коротком context, а long-context adaptation — отдельным stage. SmolLM3 и OLMo 3 идут именно этим путём. Нет смысла платить цену 64k attention за триллионы документов длиной три страницы.
35. Как примерно посчитать parameters до создания model
В rough dense decoder count входят embedding V×d; для каждого layer attention projections (порядка нескольких d², меньше с GQA), MLP projections (порядка 3×d×d_ff для SwiGLU), плюс normalization/bias terms. Final output head либо отдельный V×d, либо tied с embeddings.
Надёжнее всего после создания config выполнить `sum(p.numel() for p in model.parameters())`. Но rough math нужен заранее, чтобы увидеть, куда уходит capacity. Если в 70M-core model 25M parameters внезапно сидят в embeddings из-за огромного vocab, возможно, это не тот trade-off, который вы хотели.
parameter_count = sum(p.numel() for p in model.parameters())
print(f"{parameter_count/1e6:.1f}M parameters")
Для нашей конкретной starter config арифметика уже достаточно точна. Vocab 32 768 × hidden 768 даёт примерно 25,17M embedding parameters. Один layer с GQA attention (12 query heads, 4 KV heads) и SwiGLU MLP даёт около 6,29M parameters; 12 layers — примерно 75,52M. После final norm получается около 100,7M parameters, если output head tied с embeddings. То есть четверть capacity маленькой LLM может жить в vocabulary table.
36. Наша starter architecture: намеренно маленькая, но современная
В комплекте к статье есть Llama-style config: hidden_size 768, 12 layers, 12 query heads, 4 KV heads, intermediate_size 2048, context 2048, RMSNorm, SiLU, tied embeddings. При vocab около 32k это примерно класс ~100M parameters — точное число script печатает перед training.
Почему не копия GPT-2? GPT-2 прекрасна для обучения, но Llama-style block ближе к современной практике: RMSNorm, RoPE, GQA-friendly config, gated MLP. Почему не сложные MoE/SSM/hybrid layers? Первая model должна быть понятной. Optimization debugging и так достаточно сложен без routing collapse и expert parallelism.
36A. Разбираем ~100M model по карманам: куда уходят параметры
При vocab около 32 768 и hidden size 768 tied token embedding содержит примерно 25,2 млн weights. Двенадцать Transformer blocks с attention и SwiGLU-like MLP добавляют примерно ещё 75 млн в зависимости от projection dimensions/GQA. Итог — порядок 100–101M parameters; точное число всегда печатает sum(p.numel()).
В маленькой multilingual model vocabulary способен съесть четверть capacity. Переход 32k → 64k — не косметика: embedding почти удваивается. В 7B это терпимо, в 100M меняет баланс между lexical capacity и глубиной Transformer.
37. Инициализация weights: в первую секунду модель — чистый шум
Когда `LlamaForCausalLM(config)` создаётся без `from_pretrained`, все trainable matrices получают random initialization по rules architecture/library. Первый logits distribution почти бессмысленен: vocabulary probabilities близки к случайным, а validation loss отражает неуверенность на vocab size.
Не нужно вручную «улучшать» initialization без причины. Большие architectures часто используют специальное residual scaling или depth-dependent rules, но starter model лучше оставить на проверенной library initialization. Первая задача — убедиться, что loss finite и начинает падать.
Есть полезный sanity check. Если logits в начале почти uniform по vocabulary, ожидаемый cross-entropy примерно равен ln(V). Для vocab 32 768 это ln(32768) ≈ 10,40. Поэтому стартовый loss около 10–11 для random model сам по себе не проблема. Подозрительнее NaN, loss 100+ или loss, который вообще не движется после сотен steps.
38. Causal language-model loss: модель сдаёт экзамен на каждом token
Если sequence содержит tokens x₁…xₙ, model на position t предсказывает xₜ₊₁. Cross-entropy берёт negative log probability правильного next token. Loss усредняется по всем non-masked positions batch. Модель не получает отдельного reward за «красивое объяснение» или «правдивость» — только за predictive fit to data.
Поэтому quality corpus определяет поведение base model. Если corpus содержит SEO filler, model честно учится быть хорошим SEO filler generator. SFT позже меняет style, но pretraining формирует большую часть representations и priors. В causal LM inputs фактически служат labels, сдвинутыми на один token; Transformers делает shift внутри model loss.
38A. Первый loss можно предсказать: примерно ln(V)
Если random model распределяет probability почти равномерно по vocabulary, правильный token имеет вероятность около 1/V. Cross-entropy тогда около ln(V). Для vocab 32 768 это примерно 10,40. Стартовый loss около 10–11 выглядит логично; 50, NaN или 0,02 — повод проверять pipeline.
Это не точный target: initialization, masking и data distribution сдвигают число. Но такие sanity checks должны быть у каждого run: initial loss, parameter count, tokens/update, rough memory и checkpoint size.
39. EOS между documents: маленький token со смыслом «документ закончился»
Когда вы concatenating короткие documents в длинные fixed-length sequences, вставляйте EOS между ними. Иначе model видит искусственный переход: последняя фраза статьи о космосе без маркера продолжается первой строкой Python tutorial. Это создаёт странные cross-document associations.
Простой starter packer использует EOS и разрешает attention переходить через document boundary. Для маленького project это приемлемый compromise. Более аккуратные recipes, включая SmolLM3, используют intra-document masking: tokens одного packed document не attend к предыдущему unrelated document, хотя физически лежат в одном GPU batch.
40. Packing: не платите GPU за тысячи PAD tokens
Если training examples имеют разную длину и вы просто pad каждый до 2 048, короткие documents превращают большую часть compute в умножение нулей. Packing concatenates tokenized documents с EOS в полные blocks fixed length. GPU получает почти 100% полезных tokens.
Важная implementation detail: не сбрасывайте remainder после каждой map-batch. Если 100 коротких documents дали по 300 tokens, а chunking function работает batch-by-batch и выбрасывает хвост, вы тихо теряете большой кусок corpus. В starter kit buffer живёт через весь input file; production pipeline должен делать то же streaming-safe способом.
Часть V. Как реально оптимизировать training
41. Effective batch у LLM правильнее считать в tokens, а не examples
Для fixed sequence length global tokens per optimizer step примерно равны `micro_batch_per_gpu × sequence_length × gradient_accumulation × data_parallel_replicas`. Если у вас 2 sequences/GPU, 2 048 tokens, accumulation 32 и 4 data-parallel GPUs, это около 524 288 tokens на update.
Это удобнее, чем «batch 256», потому что example может быть 512 или 8k tokens. Большой token batch уменьшает gradient noise и улучшает throughput, но слишком большой batch может требовать другого learning rate и больше total tokens для того же optimization progress. Начинайте с recipe, который fits, и меняйте batch по measurements.
tokens_per_step = micro_batch_per_gpu * seq_len * grad_accum * data_parallel_world_size42. AdamW: почему optimizer может занимать больше memory, чем weights
AdamW хранит для каждого parameter не только gradient, но и first/second moment estimates. В зависимости от precision implementation могут существовать FP32 master weights. В mixed-precision training rough memory до activations часто оценивают порядком 12–16 bytes per parameter для weights + gradients + optimizer state. Это heuristic, не универсальная константа.
Отсюда неприятный расчёт: 1B parameters — уже примерно 12–16 GB только model-state memory в такой rough оценке, ещё до activations, temporary buffers и CUDA context. Поэтому 7B на одном 80GB GPU не «просто помещается, потому что bf16 weights занимают 14GB» — training state совсем другой, чем inference.
42A. Memory budget: почему 24 GB VRAM — не «12 миллиардов BF16 weights» при training
Для распространённого mixed-precision AdamW режима Hugging Face приводит rough anatomy около 18 bytes на parameter плюс activations. Конкретная implementation может отличаться, поэтому это heuristic. Но порядок отлично отрезвляет: 100M ≈1,8 GB model-state, 300M ≈5,4 GB, 700M ≈12,6 GB, 1B ≈18 GB — ещё до activations и временных tensors.
Отсюда главное: «1B BF16 weights — всего 2 GB» описывает storage/inference copy, а не training. FSDP/ZeRO, quantized optimizer и offload меняют математику, но переносят цену в communication, CPU RAM, bandwidth или дополнительные риски stability.
43. Adam β₁, β₂ и weight decay: маленькие числа с большим бюджетом за спиной
В LLM recipes часто встречаются AdamW β₁=0.9, β₂=0.95 и weight decay около 0.1. SmolLM3 использовал именно 0.9/0.95 и decay 0.1. β₂ меньше классических 0.999 быстрее адаптирует second-moment estimate к changing gradients в massive token stream.
Но hyperparameters не нужно копировать как заклинание. Small 100M model, другой batch и scheduler могут иметь иной sweet spot. Худшее — одновременно поменять β₂, LR, batch, context, data mix и architecture, а потом не понимать, что помогло. Храните baseline и делайте controlled ablations.
44. Learning rate: самый быстрый способ обучить model или взорвать её
LR определяет размер update. Слишком маленький — model тратит compute, почти не двигаясь; слишком большой — loss oscillates, spikes или NaN. Для ~100M scratch model стартовый порядок 3e-4–5e-4 может быть reasonable, но это не гарантия. Для fine-tuning LR обычно намного меньше.
Смотрите не только train loss. Повысили LR — train loss падает быстрее, но validation может стать хуже, gradients — нестабильнее, samples — деградировать. Хороший experiment log содержит LR curve, gradient norm, tokens seen, train/validation loss и checkpoint samples.
45. Warmup и scheduler: не бейте random network максимальным LR с первого step
В первые updates optimizer moments ещё нестабильны, activations/gradients могут иметь необычные scales. Warmup плавно поднимает LR от малого значения до target. В starter recipe мы используем warmup_ratio 1% и cosine decay — простой baseline.
Большие современные runs используют и WSD — Warmup-Stable-Decay. SmolLM3 имел 2 000 warmup steps, длинную stable phase и linear decay в последних 10% training. Scheduler — часть recipe; checkpoint посреди stable phase не эквивалентен финальной decayed model.
46. Gradient clipping: ремень безопасности, а не способ управлять автомобилем
Global gradient norm иногда делает spike из-за outlier batch, numerical issue или резкой смены data distribution. Clipping, например max norm 1.0, ограничивает update magnitude и может спасти run от одного взрывного step. SmolLM3 тоже использовал gradient clipping 1.
Если gradients постоянно clipping, это уже симптом: LR слишком большой, loss scaling нестабилен, data содержит pathological samples или model configuration плоха. Не лечите системную аварию ещё более жёстким clip. Логируйте pre-clip norm и смотрите distribution.
47. BF16, FP16 и FP32: зачем тренировать не в «полной точности»
FP32 даёт большой numerical range/precision, но weights/activations занимают больше memory и tensor cores работают медленнее. FP16 вдвое компактнее, но имеет узкий exponent range, поэтому часто требует dynamic loss scaling. BF16 сохраняет exponent range близкий к FP32 при меньшей mantissa и для modern accelerators обычно удобнее для LLM training.
Выбор зависит от hardware. NVIDIA Ampere/Hopper хорошо поддерживают BF16; другие GPUs имеют разные paths. На ROCm тоже проверяйте support конкретного accelerator. Starter script не угадывает: вы явно передаёте `--bf16` или `--fp16`. При NaN упростите run и проверьте FP32/smaller batch smoke test.
47A. RTX 3090 и BF16: Ampere умеет это аппаратно, но software path всё равно надо проверить
Официальный GA102 whitepaper указывает для RTX 3090 24 GB GDDR6X, 328 Tensor Cores третьего поколения и BF16 Tensor throughput. Но practical result зависит от PyTorch/CUDA/kernel backend. Перед длинным run проверьте torch.cuda.is_bf16_supported() и сделайте BF16 smoke test именно своей model.
TF32 — отдельный режим для ускорения некоторых FP32 matmul на Ampere, не синоним BF16. Для LLM удобнее мыслить так: BF16/FP16 — mixed-precision tensors, TF32 — Tensor Core path для FP32 matmul, если framework его использует.
48. Один GPU: gradient accumulation и checkpointing покупают memory за время
Если full global batch не fits, gradient accumulation делает несколько micro-batches, накапливает gradients и только потом выполняет optimizer step. Effective batch растёт без хранения всех examples одновременно. Цена — больше forward/backward passes между updates, то есть wall-clock магически не уменьшается.
Gradient checkpointing экономит activation memory: вместо хранения всех intermediate activations forward pass часть recompute во время backward. Hugging Face docs предупреждают о speed penalty; порядок может быть десятками процентов в зависимости от model. Это хороший trade-off, когда альтернатива — OOM. Лучшая optimization — та, которая позволяет стабильно закончить run.
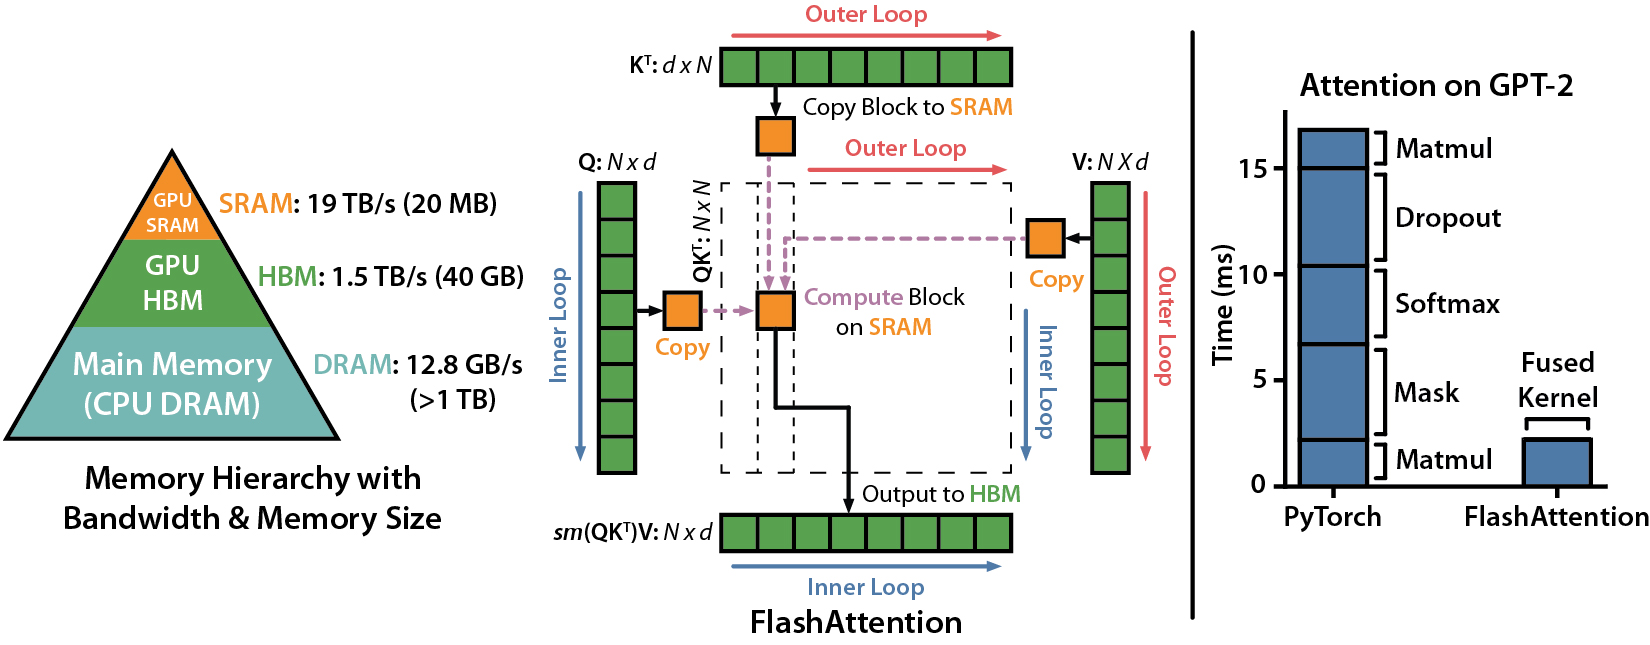
49. FlashAttention: быстрее не потому, что математика другая, а потому что память перестаёт быть пробкой
Naive attention записывает и читает большие intermediate matrices из HBM, и memory traffic становится bottleneck. FlashAttention перестраивает exact attention calculation блоками так, чтобы лучше использовать SRAM/cache и минимизировать expensive HBM round trips. Результат — меньше peak memory и выше throughput на поддерживаемых GPUs.
Важная nuance: FlashAttention не approximation и не делает dense attention linear-time. Pairwise QK interactions всё ещё quadratic по sequence length. Он выполняет ту же математику IO-aware способом. На длинных contexts разница может быть огромной, но совместимость зависит от GPU/CUDA/ROCm/kernel versions.
49A. SDPA, FlashAttention и torch.compile: сначала используйте уже оптимизированный framework
Современный PyTorch имеет native scaled-dot-product attention с выбором эффективного backend-а по dtype/shape/hardware. Transformers использует SDPA для поддерживаемых моделей, а torch.compile может уменьшать Python/kernel-launch overhead. Первая optimization-стратегия не должна начинаться с собственного CUDA kernel.
Сделайте baseline, включите supported backend, измерьте tokens/sec, затем отдельно compile. Проверяйте correctness и peak memory: новая path может быть быстрее на одном context и хуже на другом. Performance — свойство конкретного stack, а не список модных флагов.
50. 100-step smoke test: самые дешёвые сто steps проекта
Первый запуск делайте на маленьком slice data, с частыми logs и checkpoints. Вы проверяете не quality model, а plumbing: JSON читается, tokenizer IDs в range, sequence length совпадает с config, loss finite, backward работает, optimizer step происходит, checkpoint записывается, disk не забивается.
После 100 steps обязательно загрузите checkpoint отдельным process и сгенерируйте текст. Он ещё будет плохим, но generation pipeline должен работать. Затем сделайте resume и убедитесь, что step/optimizer/scheduler state продолжились, а не стартовали с нуля. Один такой вечер экономит дни cluster time.
51. 1 000-step pilot: теперь измеряем реальную экономику
На 1k-step pilot собирайте wall-clock, tokens/sec, GPU utilization, memory allocated/reserved, data-loader wait, checkpoint time, validation time и failure rate. Не extrapolate full run по первым 10 steps: kernels могут compile, caches прогреваться, dataloader — ещё не выйти на steady state.
Когда throughput стабилен, посчитайте ETA и storage growth. Если 2B-token run занимает 40 дней на вашем setup, лучше узнать это до покупки data. Возможно, правильное решение — 60M model, shorter context или rent faster GPU. Engineering — это не героически ждать, а менять design под constraints.
51A. MFU/HFU: GPU обучает модель или просто дорого греет комнату?
Tokens/sec лучше всего отвечает на вопрос ETA, а Model FLOPs Utilization помогает понять implementation. Оцениваем model FLOPs/sec и сравниваем с theoretical peak выбранного precision. Низкий MFU бывает из-за маленьких matmul, data starvation, communication, частых checkpoints, плохого packing или kernel overhead.
100% ждать не надо. Ценность MFU — в сравнении: было 28%, стало 39% при том же recipe — tokens действительно подешевели. Стало 55%, но validation хуже из-за нового batch/LR — ускорили не тот experiment.
52. Checkpoints: сохраняйте не только weights
Для настоящего resume нужны model weights, optimizer states, scheduler position, random-number-generator states и global step. Если сохранили только `model.safetensors`, можно продолжить training как новый run, но momentum/variance estimates AdamW и LR schedule будут другими. Это уже не точное продолжение.
Checkpoint cadence — компромисс. Слишком редко — авария стоит много часов; слишком часто — filesystem и pause overhead съедают throughput. Для pilot можно save каждые 500 steps, для large run — по wall-clock risk. Всегда тестируйте restore до большого запуска; backup, который никто не восстанавливал, — просто optimism.
52A. Checkpoint должен быть машиной времени, а не только safetensors
Для настоящего resume храните weights, optimizer/scheduler state, global step/tokens seen, RNG states, data-loader position/seed, tokenizer/config hashes и code version. Resume только из weights — новый experiment: moments и data order уже другие.
В multi-GPU PyTorch Distributed Checkpoint умеет parallel save/load shards и re-shard при другой topology. Финальный public checkpoint, напротив, лучше экспортировать в portable HF/safetensors format. Training checkpoint оптимизирован под resume, release checkpoint — под чужого пользователя.
Часть VI. Один GPU, много GPU и распределённое обучение
53. DDP: самый простой multi-GPU режим — каждая GPU хранит полную model copy
DistributedDataParallel раздаёт разные micro-batches разным GPUs, но каждая GPU хранит полную model и optimizer state. После backward gradients синхронизируются all-reduce. Если model помещается на одну GPU, это простой и часто самый эффективный способ масштабировать throughput.
В starter script Hugging Face Trainer запускается через `torchrun`; data parallelism подхватывается автоматически. Но global batch растёт с world size, если не уменьшить micro-batch/accumulation. Не сравнивайте runs на 1 и 8 GPUs, если они видят разное число tokens per optimizer update.
# 4 GPUs on one node
torchrun --standalone --nproc_per_node=4 train_llm_100m.py --bf16
54. FSDP2: когда model state больше не помещается на каждой GPU
PyTorch FSDP2 shards parameters, gradients и optimizer states между data-parallel ranks. Перед выполнением конкретного module parameter shards all-gather, после backward gradients reduce-scatter. В steady state каждая GPU хранит только часть большого model state, а не полную copy.
Цена — communication и более сложный checkpointing. FSDP не создаёт бесплатную memory: activations остаются, а all-gathers должны успевать за compute. Но для 1B+ models на нескольких GPUs это часто первый серьёзный шаг после DDP. Текущая PyTorch линия рекомендует FSDP2, тогда как FSDP1 считается legacy/deprecated path.
55. DeepSpeed ZeRO: три stages, три уровня разбиения model state
ZeRO Stage 1 partition optimizer states; Stage 2 добавляет partition gradients; Stage 3 shards ещё и parameters. В Stage 3 каждая GPU хранит только часть states и получает нужные parameters на лету. По логике memory savings это близкий родственник fully sharded approaches, но DeepSpeed имеет свой runtime и ecosystem.
ZeRO-3/ZeRO-Infinity также может offload часть state на CPU/NVMe. Это позволяет запустить model, которая иначе не fits, но PCIe/NVMe bandwidth легко превращает «поместилось» в «обучается вечность». Offload — lever, а не substitute for profiling.
56. Megatron-style parallelism: когда одного sharding dimension уже мало
Data Parallelism делит batch. Tensor Parallelism делит большие matrix operations одного layer между GPUs. Pipeline Parallelism распределяет groups layers по stages. Context Parallelism делит sequence dimension, особенно полезно на 8k+ contexts. Expert Parallelism распределяет MoE experts. В больших clusters эти dimensions комбинируются.
NVIDIA Megatron Core даёт простую mental model: total GPUs ≈ TP × PP × CP × EP × DP. Начинайте с простого. Если model fits — DP. Если один layer не fits — TP. Если model слишком велика/глубока — PP. Если long context душит activations — CP. Добавлять всё в 100M project — отличный способ заменить ML на неделю debugging NCCL.
57. Data loader должен кормить GPU быстрее, чем GPU ест
Если utilization скачет 100% → 20% → 100%, проблема может быть не model, а input pipeline. Tokenization on-the-fly, gzip decompression, random small file reads, network storage или Python JSON parsing легко оставляют GPU без batch. Pre-tokenized packed shards обычно дают стабильнее throughput.
Для cluster training data shards должны быть достаточно крупными для sequential reads, но не настолько, чтобы checkpoint/resume или shuffle стали неудобными. Используйте prefetch, worker processes, pinned memory где уместно, local cache/NVMe, и измеряйте dataloader time отдельно. Дорогой accelerator, ожидающий disk, — самый глупый invoice в ML.
58. Что логировать: loss — только первая лампочка на панели
Минимум: train loss, validation loss, LR, gradient norm, tokens seen, tokens/sec, samples/sec, GPU memory, step time, data time, checkpoint time. Для cluster добавьте per-rank failures, communication time, hardware errors, network counters. Важно привязывать metrics к tokens seen, а не только step number, если batch/config меняется.
Ещё одна метрика — generated samples на fixed prompts. Loss может плавно улучшаться, а qualitative behaviour покажет repetition loop, language drift или broken code. Храните samples рядом с checkpoint ID и config hash, чтобы через месяц не искать, «какая именно модель тогда красиво писала по-русски».
58A. Логируйте gradients, activations и parameters — loss предупреждает слишком поздно
Полезны gradient norms, parameter norms, activation RMS/max, update-to-weight ratio, attention logits, non-finite fraction, throughput и memory peak. OLMo-core использует GAP monitoring именно потому, что stability многомерна.
Не нужно писать terabytes histograms. Выберите representative layers и разумный interval. Если activation norm медленно растёт тысячи steps, trend виден до NaN и даёт время сохранить checkpoint или найти проблемный data shard.
59. Как читать loss curve: нормальная история, overfitting и странные скачки
На scratch run loss сначала падает очень быстро: model учит token frequencies, spaces, punctuation, common syntax. Затем slope замедляется. Если train и validation падают вместе — хорошо. Train падает, validation остановился/растёт — overfitting или distribution mismatch. Оба внезапно прыгнули — ищите LR/data/precision issue.
Если loss периодически делает spike на boundaries data shards, возможно один source bucket имеет другую quality/length distribution. Если spike совпадает с checkpoint save — может быть I/O contention. Если только один rank имеет NaN — hardware/communication. Коррелируйте curve с system events и batch provenance.
60. NaN, OOM и «loss не падает»: аварийная диагностика
OOM: уменьшайте micro-batch, context, включайте checkpointing/FlashAttention, затем sharding. NaN: уменьшите LR, проверьте precision, gradients, corrupt inputs, token IDs, loss scaling; запустите tiny FP32 baseline. Loss вообще не падает: проверьте labels, trainable parameters, data, совпадение tokenizer/model vocab sizes.
Самая полезная техника — shrink the problem. 1 GPU, 2 layers, 128 context, 1k documents, FP32. Попробуйте overfit 100 batches. Если model не может memorise tiny dataset, pipeline сломан. Если tiny run работает, добавляйте complexity по одному: mixed precision, full layers, long context, distributed.
60A. Лучший debug-тест: заставьте модель переобучиться на одном tiny batch
Если loss не падает, возьмите один маленький batch и тренируйте только на нём. Исправная implementation должна почти запомнить его и сильно снизить loss. Если не может — проверяйте labels shift, masking, frozen parameters, optimizer step и gradient flow.
Мы специально вызываем overfit, который в обычном training вреден. Так мы убираем generalization и data diversity и задаём один вопрос: «эта computational graph вообще способна учиться?» Только после успеха возвращаем нормальный corpus.
61. Staged training: необязательно всё время кормить модель одинаково
В старой mental model pretraining — одна смесь data и один run от step 0 до finish. Современные open recipes чаще используют stages. Broad web сначала даёт general language/world priors. Затем midtraining усиливает high-quality knowledge, code, math или domain. Отдельный long-context stage учит работать с большим context после формирования core capability.
OLMo 3 7B — хороший пример: stage 1 5.93T tokens на 512 H100, stage 2 100B midtraining tokens на 128 H100, stage 3 50B long-context tokens на 256 H100. Это не числа для слепого копирования, а доказательство, что «какие tokens когда» может быть важнее одного static mix.
62. Long-context training лучше делать отдельно, чем платить за него с первого token
Если конечная model должна читать 32k/64k context, tempting сразу pretrain на 64k. Но quadratic attention делает это очень дорого, а большинство documents короче. Вы тратите compute на слабую long-range structure, когда model ещё не выучила basic language.
Практические recipes часто train core model на 2k/4k, затем extend RoPE/context и midtrain на curated long documents. Нужно проверять position extrapolation, attention stability и packing/masks. Long context — отдельная capability, её оценивают retrieval/needle/long-doc tasks, а не только perplexity.
Часть VII. Evaluation и превращение base model в помощника
63. Perplexity: полезный термометр, но не рейтинг интеллекта
Perplexity = exp(cross-entropy). Если loss 3.0, PPL ≈ 20: грубо говоря, model ведёт себя так, будто на каждой позиции имеет около двадцати equally plausible choices. Более низкая PPL на том же held-out distribution обычно означает лучшую predictive model.
Но PPL нельзя честно сравнивать между models с разными tokenizers: одна разбивает слово на 1 token, другая на 4, и loss per token измеряет разное. Низкая web perplexity также не гарантирует reasoning, instruction following или factuality. Используйте PPL внутри одной training family.
Для сравнения systems с разными tokenizers полезно смотреть на bits per byte или bits per character: normalise negative log-likelihood не по числу tokenizer tokens, а по объёму исходного текста. Это не идеальная метрика, но она убирает часть искусственного выигрыша из-за другой granularity tokenization.
63A. Bits-per-byte: когда perplexity вводит в заблуждение из-за tokenizer
Per-token perplexity зависит от tokenization. Сравнивать модели с разными tokenizers напрямую опасно. Более нейтральный взгляд — нормализовать negative log-likelihood на bytes/characters и считать bits-per-byte или bits-per-character.
Для RU/UK это особенно важно: tokenizer, который мельче режет кириллицу, может выглядеть хуже per-token не только из-за слабой language modeling. Храните perplexity и хотя бы одну raw-text-normalized metric.
64. lm-eval: standardized benchmarks нужны, но собственные ещё важнее
EleutherAI lm-evaluation-harness даёт reproducible interface к большому числу academic benchmarks. Для local Hugging Face model можно запустить `lm-eval run --model hf --model_args pretrained=... --tasks ...` и сохранять samples/results. Это хороший regression layer между checkpoints.
Но English-heavy benchmark suite плохо измеряет RU/UK technical model. Постройте свои held-out tasks: русская и украинская grammar/knowledge, technical QA, mixed-language code explanations, domain documents, hallucination traps, long context. Benchmark должен отражать продукт, а не только papers.
lm-eval run \
  --model hf \
  --model_args pretrained=./runs/rp-llm-100m \
  --tasks hellaswag \
  --output_path ./eval \
  --log_samples
64A. Multilingual evaluation: среднее число скрывает смерть одного языка
Ведите отдельные validation curves для RU, UK, EN и domains. Общий loss может улучшаться, пока украинский ухудшается, если English bucket статистически доминирует.
Добавьте generation evals: одинаковые prompts на разных языках, code-switching, terminology, factual QA. Следите за language leakage — ответ не на языке prompt часто сигнализирует о перекосе data/tokenizer/post-training.
64B. Generation settings — часть evaluation protocol
Один checkpoint выглядит по-разному при temperature 0.7 и 1.5. Фиксируйте temperature, top-p/top-k, max tokens, repetition settings, chat template и seeds. Для deterministic задач используйте controlled decoding.
Не выдавайте смену sampling за улучшение weights. Eval harness должен versioned ровно так же, как training code.
65. Base model после pretraining ещё не «чат-бот»
Base LLM училась продолжать текст. На prompt «Объясни attention просто» она может не ответить, а продолжить его как заголовок статьи, форумную цитату или список. Это не failure pretraining; objective никогда не говорил «слушайся пользователя».
Instruction following появляется во время post-training. SFT показывает много pairs prompt → ideal completion или conversations. Model учит format, tone, helpfulness, refusal patterns, tool syntax. Если base knowledge слабое, SFT не создаст его из воздуха; но хороший post-training превращает «text predictor» в usable assistant.
66. SFT, LoRA и DPO: три последние ступени до помощника
SFT на prompt-completion dataset обучает loss преимущественно на completion tokens: user prompt даёт context, а model штрафуется за неверный answer. Современный TRL SFTTrainer поддерживает prompt-completion и packing. Full SFT меняет все weights; LoRA оставляет base frozen и обучает low-rank updates — намного дешевле для крупной pretrained model.
После SFT можно добавить preference data: один prompt, `chosen` хороший answer, `rejected` хуже. DPO оптимизирует policy так, чтобы chosen становился относительно вероятнее без отдельного reward-model RL loop. Это не обязательный шаг для первой 100M-model, но он завершает conceptual pipeline: pretraining учит язык/мир, SFT — инструкции, preferences — выбор между допустимыми ответами.
66A. Post-training в 2026 году: synthetic data, rejection sampling и online RL
SFT → DPO — хороший учебный маршрут, но большие современные systems на этом не заканчиваются. Они генерируют synthetic tasks, запускают model в coding/test environments, получают verifiable rewards, отбрасывают слабые trajectories и снова обучают policy. Data factory после pretraining производит уже не только текст, но и опыт взаимодействия.
Rejection sampling — простой пример: model генерирует несколько ответов, evaluator или unit tests оставляют лучшие, после чего selected completions становятся новыми SFT examples. Online RL и agentic post-training идут дальше: model действует в среде, получает feedback и учится по outcomes. Kimi K2 — хороший открытый пример: authors описывают large-scale agentic data synthesis и joint reinforcement-learning stage.
Для первой домашней 100M model это advanced appendix, а не обязательный checklist. Но направление важно: frontier post-training всё больше похож не на «дать модели правильный ответ», а на «дать ей задачу, среду и способ проверить результат».
66B. RLVR: когда ответ проверяет программа, reward становится честнее
Reinforcement Learning with Verifiable Rewards подходит для math, code и structured tasks. Вместо opaque reward model есть verifier: правильное число, unit tests, SQL result, formal checker. OLMo 3 публикует flow SFT → DPO → RLVR.
Для 100M дома это advanced stage, но принцип важен: ценнее всего reasoning/synthetic data, которое можно проверить внешним сигналом, а не только уверенностью teacher model.
66C. Distillation: иногда маленькую модель лучше учить с сильным преподавателем
Knowledge distillation переносит behavior от teacher к student. Простой вариант — synthetic SFT, более прямой — оптимизация по teacher logits, если они доступны. Это мощно, но нужно честно отличать от полностью independent scratch-learning.
Для продукта distillation часто отличный trade-off: маленькая модель дешевле inference. В документации разделяйте знания из raw pretraining и поведение, полученное от teacher-generated supervision.
Часть VIII. Практика: запускаем собственный pretraining
67. Практика: создаём project и environment
Теперь от теории к работе. В starter ZIP есть scripts, которые намеренно не скрывают pipeline за магическим framework. PyTorch устанавливайте отдельно под свой CUDA/ROCm stack; поверх него — Transformers, Datasets, Tokenizers, Accelerate, TRL, PEFT. Версии в requirements зафиксированы на 22 августа 2026 года, чтобы API не «плыл» от случайного update.
Для reproducibility сохраните `python --version`, `pip freeze`, driver/CUDA/ROCm versions, GPU model и git commit scripts. Если run окажется хорошим, именно этот скучный metadata позволит воспроизвести его через три месяца. Не обновляйте libraries посреди 10-day training без критической причины.
python -m venv .venv
source .venv/bin/activate   # Windows: .venv\Scripts\activate
# Install PyTorch for your accelerator first.
pip install -r requirements.txt
68. Формат corpus: один JSON object — один document
Самый простой portable input: JSONL, каждая строка `{"text":"..."}`. Document boundary имеет смысл: article, source file, forum thread segment, code file. Не дробите всё на 2k chunks до split/dedup — потеряете provenance и создадите leakage между train/validation.
До pipeline сделайте manifest с source ID, language, license bucket, quality score и hash, даже если training JSONL содержит только text. Starter split script deterministic через SHA-256: один document всегда попадает в один split. Это удобно при версиях corpus.
{"text":"Перший повний документ..."}
{"text":"Другий документ..."}
{"text":"def hello():\n    return 'world'"}
69. Шаг 1: split до tokenizer и training
Положите cleaned/deduplicated corpus в `data/all.jsonl`, затем запустите deterministic split. По умолчанию starter отдаёт 0.5% documents в validation. Для маленького corpus можно взять 1–5%, чтобы validation имел достаточно examples. Test/golden eval лучше держать отдельно и не использовать при tokenizer training.
После split из training portion создаём text file для tokenizer. Tokenizer тоже обучается на statistics data, поэтому чистый experimental protocol не должен подсматривать validation.
python split_jsonl.py --input data/all.jsonl \
  --train data/raw_train.jsonl --valid data/raw_valid.jsonl
python build_tokenizer_corpus.py --input data/raw_train.jsonl \
  --output data/tokenizer_corpus.txt
70. Шаг 2: обучаем ByteLevel BPE tokenizer
Starter вызывает Hugging Face Tokenizers BPE trainer с vocabulary 32 768, minimum frequency 2 и четырьмя special tokens. На небольшом corpus tokenizer training занимает минуты, не дни. Для огромного corpus sample десятков/сотен GB часто достаточен — vocabulary statistics не требуют видеть каждый trillion token.
После training script печатает sample tokenization/roundtrip. Добавьте свой tokenizer QA notebook: русские/украинские endings, English acronyms, URLs, code identifiers, JSON, numbers. Если много UNK или decode не восстанавливает text, не переходите к pretraining.
python train_tokenizer.py \
  --input data/tokenizer_corpus.txt \
  --output tokenizer \
  --vocab-size 32768
71. Шаг 3: tokenization и packing в 2 048-token blocks
`prepare_dataset.py` читает каждый raw document, tokenizes без automatic special tokens, добавляет EOS и накапливает IDs в buffer. Как только buffer содержит ≥2048 tokens, script записывает fixed sequence. Remainder переходит к следующему document, поэтому короткие тексты не выбрасываются.
Packed files уже привязаны к tokenizer version и sequence length. Если меняете tokenizer — rebuild dataset. Если меняете context с 2k на 4k — лучше repack. Для production data pipeline храните manifest с tokenizer hash и packer version.
python prepare_dataset.py \
  --tokenizer tokenizer \
  --train data/raw_train.jsonl \
  --valid data/raw_valid.jsonl \
  --seq-len 2048
72. Шаг 4: первый pretraining run — не сразу 10 000 steps
Сначала запустите `--max-steps 100`, `--save-steps 50`, `--eval-steps 50`. Убедитесь, что model печатает parameter count, tokens per optimizer step, loss падает, validation запускается, TensorBoard logs появляются, checkpoints читаются. Затем 1 000 steps для throughput.
Только после этого ставьте 10k/100k/full token budget. Если GPU поддерживает BF16 — используйте `--bf16`; иначе FP16 при стабильности. Micro-batch 2 и grad accumulation 32 — baseline, не истина. На 16GB может понадобиться micro-batch 1 или context 1024.
python train_llm_100m.py --bf16 --max-steps 100 \
  --logging-steps 5 --eval-steps 50 --save-steps 50
# then pilot
python train_llm_100m.py --bf16 --max-steps 1000
72A. OOM ladder: меняйте по одному, а не включайте двадцать flags сразу
Сначала исключите memory leak/лишние процессы. Затем уменьшите micro-batch. Потом gradient checkpointing. Если мало — sequence length. Далее efficient attention, optimizer tricks, FSDP/ZeRO/offload или меньшая model.
CPU offload не должен быть первым решением: можно «вместить» model и заставить GPU ждать PCIe. После каждой ступени записывайте peak VRAM и tokens/sec. Нужна самая быстрая конфигурация, которая стабильно помещается с запасом.
73. Шаг 5: смотрим, как шум начинает превращаться в язык
После первого checkpoint generation может быть набором частых symbols. Затем появляются spaces/punctuation, короткие word-like fragments, syntax patterns и локальная coherence. Это одна из самых интересных частей проекта: видно, как statistical structure corpus постепенно записывается в weights.
Не оценивайте base model по temperature=1.5 и одному prompt. Храните fixed generation grid: несколько prompts × seeds × temperature 0.2/0.7/1.0. Сравнивайте checkpoints. Repetition на low temperature может указывать на undertraining или sampling issue; хаос на high temperature ещё не означает плохую model.
python sample.py --model runs/rp-llm-100m/checkpoint-1000 \
  --prompt "Штучний інтелект — це" --temperature 0.8
74. Шаг 6: validation loss и собственные golden prompts
`eval_loss.py` считает cross-entropy/perplexity на packed validation. Запускайте его на checkpoints или используйте Trainer evaluation. Дополнительно держите golden prompts, где вручную смотрите language separation, factual patterns, formatting и domain vocabulary.
Если validation loss лучший на checkpoint 30k, а train loss продолжает падать до 50k — не автоматически берите последний. Для base pretraining на больших unique corpora сильный overfitting менее типичен, но маленький homemade corpus легко повторяется много epochs.
python eval_loss.py --model runs/rp-llm-100m \
  --valid data/valid_packed.jsonl
75. Шаг 7: SFT — учим model отвечать, а не просто продолжать
Подготовьте JSONL с `prompt` и `completion`. Здесь quality ещё важнее volume: лучше 10k разнообразных точных instruction pairs, чем миллион шаблонных synthetic «What is X? — X is…». Смешивайте explanation, transformation, extraction, coding, refusal/safety и multi-turn только если application это требует.
Starter `sft.py` использует TRL SFTTrainer, packing и completion-only loss. Для 100M-model full SFT дешёв. Для 7B pretrained base LoRA обычно практичнее. Если model ещё не знает domain facts, сначала continued pretraining на domain corpus, потом SFT — instruction examples не должны быть единственной базой знаний.
{"prompt":"Поясни self-attention простими словами.","completion":"Уяви, що кожне слово..."}
python sft.py --model runs/rp-llm-100m --train data/sft_train.jsonl --bf16
76. Шаг 8: DPO — когда «правильных» ответов несколько, но один лучше
Preference dataset содержит prompt, chosen и rejected. Chosen не обязательно «истина», а rejected — «ложь»: разница может быть в точности, ясности, safety, формате или отсутствии лишней болтовни. Важно, чтобы preference criterion был последовательным, иначе model учит шум evaluator-а.
DPO сравнивает relative likelihood chosen/rejected относительно reference policy и оптимизирует preference без отдельной reward model + online RL. Для маленькой домашней model это необязательно. Но для assistant SFT-only часто оставляет rough edges, которые preference optimization может убрать.
{"prompt":"Що таке gradient clipping?","chosen":"Це обмеження норми градієнта...","rejected":"Це коли ми просто зменшуємо learning rate."}
python dpo.py --model runs/rp-llm-100m-sft --train data/dpo_train.jsonl --bf16
Часть IX. Как обучают большие модели в 2026 году
77. SmolLM3: почему «маленькая» 3B model может съесть 11.2 триллиона tokens
Hugging Face открыл training recipe SmolLM3: 3B parameters, 11.2T training tokens, 384 H100 GPUs, 24 days. Есть staged data mixtures, WSD schedule, 2 000 warmup steps, final 10% decay, DataTrove processing, nanotron training и LightEval. Отличный reality check против мысли «3B — небольшая, обучу за выходные».
Но брать нужно не hardware envy, а principles: многие ablations делают на коротких 50–100B-token runs; data mixture меняют по stages; context/architecture optimizations тестируют до full run; recipe документирована. Большой model run — финальный manufacturing batch после десятков дешёвых experiments.
77A. FP8, MXFP8 и NVFP4: frontier precision, которую не нужно копировать на RTX 3090
На больших кластерах precision стала отдельным инженерным рычагом. NVIDIA Transformer Engine поддерживает FP8 training на Hopper, Ada и Blackwell, а Blackwell добавляет MXFP8 и NVFP4 recipes. Смысл тот же, что у mixed precision: уменьшить bytes per value и поднять throughput matrix operations, не потеряв training stability.
Для RTX 3090 это не первый шаг. GA102 — Ampere. Transformer Engine документирует optimizations для FP16/BF16 на Ampere, но FP8 path ориентирован на более новые architectures. Домашний рецепт проще: BF16 или FP16 в зависимости от stack, gradient checkpointing, SDPA/FlashAttention-compatible kernels и измерение реального throughput.
77B. Data annealing и mid-training: последние tokens могут быть ценнее первых
SmolLM3 меняет пропорции web/code/math по stages, OLMo 3 после massive pretraining делает 100B-token midtraining и отдельный long-context stage. Современный recipe всё реже означает один неизменный mix.
Для маленькой модели можно попробовать 80–90% broad clean mix, финальные 10–20% — более quality technical/code/math при decay LR. Но curriculum проверяйте matched pilot-ами: это hyperparameter, не догма.
78. OLMo 3: лучший урок — открытая model должна показывать не только weights
Allen Institute for AI публикует OLMo как research ecosystem с code, configs, checkpoints и training stages. OLMo 3 7B base описан как 32-layer, hidden size 4096, 5.93T-token pretraining, затем 100B midtraining и 50B long-context stage. Pretraining использовал 512 H100; 32B версия — до 1 024 H100 на отдельных stages.
Ценность для человека, который тренирует свою model, — reproducibility culture. Записывайте data manifests, exact configs, checkpoint lineage, evaluation и environment. Model без recipe — просто файл weights; model с recipe — эксперимент, который можно понять, критиковать и повторить.
78A. Muon и MuonClip: optimizer тоже стал полем больших экспериментов
AdamW остаётся надёжной стартовой точкой, но optimizer research снова активен. Muon работает с matrix-shaped gradients и использует orthogonalization; Kimi K2 развивает идею через MuonClip и qk-clip для борьбы с attention-logit explosions. В technical report Kimi K2 authors сообщают pretraining на 15.5T tokens без loss spikes в своём recipe.
Урок не в том, чтобы немедленно заменить AdamW. Новый optimizer — ещё одна переменная, способная сломать run. Сначала сделайте strong AdamW baseline, зафиксируйте data, architecture, schedule и eval. Только потом тестируйте Muon-like methods на коротких ablations.
78B. Model soup: иногда усреднение checkpoints полезнее ещё недели training
OLMo/SmolLM-style flows используют averaging/merging, чтобы объединять сильные свойства checkpoints. Несколько соседних late checkpoints одного run иногда можно усреднить и получить более стабильный candidate без inference ensemble.
Но merge не гарантированно улучшает. Сохраняйте originals и оценивайте новую модель тем же harness. Два совсем разных basin/architectures нельзя бездумно смешивать.
79. Сколько у вас на самом деле data: считайте tokens, unique tokens и effective epochs
Размер corpus в GB почти ничего не говорит: code, Cyrillic, HTML и prose имеют разную token density. После final tokenizer посчитайте total unique training tokens в каждом bucket. Затем training budget / unique tokens даёт effective epochs. Если у вас 500M unique tokens и вы планируете 2B training tokens, model в среднем увидит corpus четыре раза.
Повторный проход data не всегда плох — маленькие models часто выигрывают от нескольких epochs. Но memorization растёт, особенно для duplicated/high-weight sources. Логируйте per-source effective epochs, чтобы «усилить русский/украинский» не превратилось в «те же 20 сайтов прочитали 80 раз».
80. Когда останавливать training: budget, validation и downstream eval должны голосовать вместе
Есть три stop signals. Первый — запланированный token/compute budget. Второй — validation curve: продолжается ли meaningful improvement. Третий — downstream/golden eval: улучшаются ли нужные capabilities. Если validation loss падает на 0.01, а code tests/RU QA стоят, дополнительный compute лучше вложить в data mix или post-training.
Большой run лучше иметь planned decay/ending, а не просто нажать Stop на случайном step. LR scheduler формирует финальную quality. Если решили существенно продлить model, иногда правильнее перейти в новый stage с новым scheduler/data mix, чем тянуть старый cosine к почти нулевому LR.
81. Экспорт: weights без tokenizer и config — полумодель
После training сохраняйте model через `save_pretrained`, tokenizer рядом, config.json, generation defaults при необходимости, data/model card и checksum. Формат safetensors удобен тем, что не выполняет arbitrary pickle code при loading и хорошо поддерживается ecosystem.
Проверьте clean-room load в новом environment: скопируйте directory на другую машину и запустите `AutoModelForCausalLM.from_pretrained` + `AutoTokenizer.from_pretrained`. Если model работает только в вашем training notebook с глобальными variables, artifact ещё не готов.
82. Quantization и serving: training закончился, economics только началась
Base weights в BF16 занимают примерно 2 bytes/parameter: 7B ≈ 14 GB только weights. 8-bit/4-bit quantization может сильно уменьшить inference memory и bandwidth, но quality loss зависит от quantizer, activation outliers, calibration и task. Не quantize единственную копию model; храните master checkpoint в training precision.
Для serving важны KV cache, batch size, context length и tokens/sec/user. GQA уменьшает KV cache, continuous batching повышает utilization, speculative decoding может снижать latency. Это отдельная engineering дисциплина. Измеряйте first-token latency, decode tokens/sec, concurrency и cost per million generated tokens.
83. Safety evaluation начинается до SFT, а не после скандала
Проверяйте base и instruct models на memorization, private-data regurgitation, toxic continuations, dangerous domain misuse, prompt injection/tool misuse, language-specific abuse. Для RU/UK нужны локальные test sets: перевод English red-team prompts недостаточен, потому что оскорбления, slang и ambiguous instructions отличаются.
Safety — не одна цифра. Есть trade-off между refusal rate и helpfulness, между code security и general code capability. Логируйте category-level results и примеры. Если model используется только как offline autocomplete — один threat model; если agent имеет credentials и выполняет actions — совсем другой.
84. Model card: напишите правду о том, что вы создали
Хорошая model card содержит architecture, parameter count, tokenizer, context, languages, training tokens, data categories/provenance, known exclusions, training compute/hardware, optimizer/scheduler, checkpoints, evaluation, intended uses, limitations и license. Если business reasons не позволяют перечислить источники, дайте хотя бы category-level transparency.
Особенно напишите, чего model НЕ умеет. Маленькую 100M base model нельзя рекламировать как «AI assistant». Если она обучалась на 1B technical tokens и хорошо autocomplete code snippets — так и скажите. Доверие начинается не с benchmark screenshot, а с честного training description.
Часть X. Домашняя лаборатория и финальный маршрут
84A. Reproducibility card: model card без training ledger — половина истории
Запишите git commit, lockfile/container, GPU/driver/CUDA, tokenizer hash, dataset manifest hash, architecture, optimizer/scheduler, precision, global token batch, total tokens, seed, checkpoints, eval harness и incidents/restarts.
Через полгода v2 начнётся с настоящего baseline, а не воспоминаний «кажется, LR был 3e-4». Для публичной модели такой ledger показывает lineage лучше любой маркетинговой фразы.
85. Если у вас одна 24GB GPU: конкретный план без фантазий
Возьмите ~60–120M Llama-style model, tokenizer 16k–32k, context 1024 сначала. Соберите 0.5–1B хорошо очищенных tokens. Запустите micro-batch 1–4, gradient accumulation для ~64k–256k effective tokens/update, BF16 если supported, gradient checkpointing. На 100/1k steps измерьте throughput и только потом выбирайте full token budget.
Если 2k context помещается и throughput нормальный — поднимайте. Если нет — 1024 не стыдно: для учебной model это лучше вечного OOM. После pretraining сделайте 5k–50k instruction examples и full SFT. Вы получите не «конкурента ChatGPT», а собственную end-to-end LLM, где каждый token, weight и checkpoint прошёл через ваш pipeline.
Для RTX 3090 24 GB я бы начинал не с самой большой model, которая едва влезла, а с самой большой, которую можно стабильно дебажить. Практичная ladder: 50–70M для проверки pipeline; ~100M как первый настоящий run; 250–400M как второй амбициозный project после того, как вы знаете tokens/sec, memory curve и checkpoint recovery. 700M–1B можно заставить жить через aggressive checkpointing/offload/короткий context, но wall-clock быстро становится главным ограничением.
python - <<'PY'
import torch
print(torch.cuda.get_device_name(0))
print('VRAM GB:', torch.cuda.get_device_properties(0).total_memory / 1024**3)
print('BF16 supported:', torch.cuda.is_bf16_supported())
PY
RTX 3090 имеет 24 GB GDDR6X и Ampere compute capability 8.6. Сначала проверьте torch.cuda.is_bf16_supported() в вашем реальном PyTorch/CUDA stack. Если BF16 path стабилен — широкий exponent range удобен; если library/kernel stack лучше ведёт себя в FP16, используйте FP16 с loss scaling. Здесь нет награды за «модный dtype» — есть finite loss и throughput.
VRAM budget считайте слоями. Для 100,7M model BF16 weights — всего около 0,2 GB; gradients — ещё ~0,2 GB; FP32 Adam moments — около 0,8 GB. Но реальный peak выше из-за activations, temporary buffers, kernels, allocator fragmentation и optimizer/master-state implementation. Sequence length и micro-batch часто съедают 3090 быстрее самих weights.
Начните с context=1024, micro_batch=1 и gradient checkpointing. Поднимайте micro-batch до первого OOM, отступите на шаг, потом тестируйте context 2048. Не оптимизируйте utilization, пока model не прошла 100-step smoke test и resume.
ETA считайте только после pilot. Если pilot показывает 18 000 tokens/s, а budget — 1B tokens, идеальный compute-only time равен 1e9 / 18000 ≈ 15,4 часа. Добавьте validation, checkpoints, startup, dataloader stalls и safety margin. Electricity: средняя system power в kW × часы × ваш тариф kWh. Сначала измерьте потребление, а не подставляйте TDP.
| Профиль | Parameters | Стартовый context | Цель |
|---|---|---|---|
| Debug | 50–70M | 512–1024 | Проверить весь pipeline за часы |
| First real | 90–130M | 1024–2048 | Увидеть настоящую language learning dynamics |
| Ambitious 3090 | 250–400M | 1024 | Научиться memory/throughput trade-offs |
| Research pain | 700M–1B | 512–1024 | Технически возможно, но wall-clock уже наказывает |
85A. RTX 3090 под микроскопом: почему старая gaming-карта до сих пор интересна LLM-никам
RTX 3090 FE имеет 24 GB GDDR6X, 384-bit interface, около 936 GB/s peak memory bandwidth и TGP 350 W. Для scratch-training главная ценность — 24 GB VRAM. Ampere Tensor Cores поддерживают BF16/FP16/TF32 paths.
Но это не H100: другой bandwidth/compute/communication, consumer cooling и 24/7 нагрузка требуют контроля температур/PSU. Для 50–300M scratch models это отличная лаборатория — достаточно быстрая и достаточно ограниченная, чтобы понять memory economics.
85B. Четыре размера на 24 GB: от комфортной лаборатории до борьбы за мегабайты
По rough 18 bytes/parameter AdamW heuristic: 100M ≈1,8 GB model-state до activations; 300M ≈5,4 GB; 700M ≈12,6 GB; 1B ≈18 GB. Поэтому 100M комфортна, 300M требует внимания, 700M часто требует checkpointing/малого batch, 1B с полным AdamW на 24 GB уже тесна без tricks.
Это не гарантия. Реальный footprint зависит от implementation, context, batch, optimizer и kernels. Печатайте torch.cuda.max_memory_allocated() и benchmark-те configs.
85C. Электричество: формула проще любого scheduler
GPU-only lower bound при 350 W за сутки — 8,4 kWh. Реальная розетка включает CPU/RAM/SSD/PSU losses, поэтому используйте wattmeter. cost = average_wall_kW × hours × tariff_per_kWh.
Соедините это с measured tokens/sec и получите стоимость миллиарда tokens. Так локальный run можно честно сравнить с арендой другого accelerator.
85D. Реалистичный 100M-проект на одной 3090
Четыре волны: tiny 10–50M pipeline test; target 100M на 100 steps; 1k–5k pilot для throughput/LR; только потом full token budget. У каждой волны kill criteria.
Tiny не overfit one batch — stop. Loss не движется — stop. Pilot нестабилен — stop. Validation портится при падающем train loss — разбираем data/LR. Такой подход экономит дни.
85E. 300M и 700M: увеличивайте model только после доказанного bottleneck capacity
100M быстро упирается в capacity, 300M — логичный второй шаг, 700M на одной 3090 уже делает wall-clock/memory главным ограничением. Но рост имеет смысл только если data/eval pipeline уже здоров.
Если 100M плоха из-за spam corpus или tokenizer, 700M просто выучит spam дороже. Нужен конкретный capability gap, который matched scaling pilot действительно улучшает.
86. Если у вас 4–8 GPUs: где появляется настоящая свобода
На 4–8 modern GPUs можно поднять model до нескольких сотен миллионов или ~1B class, увеличить global batch и context без убийства wall-clock. Если model помещается per GPU — сначала DDP. Если model state тесно — FSDP2/ZeRO. Не переходите на TP/PP, пока profiler не покажет, что простого data parallel/sharding недостаточно.
На этом scale bottleneck часто внезапно становится data. 8 GPUs могут потреблять hundreds of thousands tokens/sec; Python preprocessing, network disk и один compressed shard начинают тормозить. Pre-tokenize, shard, prefetch. И помните: в 8-GPU run global batch сам по себе становится в 8 раз больше.
87. Финальный алгоритм: что делать завтра утром
1) Определите model goal и 100 golden eval prompts. 2) Соберите legal/provenance-aware corpus. 3) Clean → language ID → quality filter → exact/fuzzy dedup → benchmark decontam. 4) Split documents. 5) Обучите tokenizer и сделайте QA. 6) Pack с EOS. 7) Создайте ~100M decoder. 8) 100-step smoke. 9) 1k-step throughput pilot. 10) Посчитайте ETA и только потом full run.
11) Логируйте loss/LR/grad norm/tokens/sec и samples. 12) Test resume. 13) Оценивайте validation + custom benchmarks. 14) Выберите best base checkpoint. 15) SFT на clean instructions. 16) При необходимости DPO/LoRA/safety tuning. 17) Export clean artifact + model card. 18) Измерьте inference. Если прошли все 18 — вы не «поигрались с нейросетью». Вы реально обучили свою LLM.
88. Главный вывод: LLM рождается не в одном файле train.py
Когда смотришь на финальный code, всё кажется смешно простым: model создаётся несколькими десятками lines, Trainer — ещё несколькими. Настоящая сложность размазана по системе: data contracts, tokenizer, scaling, optimizer stability, hardware utilization, evaluation, checkpoint lineage, post-training. Большие labs — не «люди, знающие секретный Transformer», а организации, умеющие стабильно выполнять тысячи правильных мелочей.
И это хорошая новость. Основные идеи не магические и не закрытые. Transformer paper открыт, modern recipes SmolLM3/OLMo документированы, frameworks доступны. Сегодня можно обучить маленькую настоящую LLM, увидеть, как loss превращает шум в язык, а завтра масштабировать каждую часть. Разница между «я использую AI» и «я понимаю, как он выращивается» начинается с первого собственного run.
Часть XI. Как понять, что вы действительно обучили модель, а не просто сожгли электричество
89. Capability ladder: наблюдайте появление навыков как последовательность
Сначала исчезает чистый шум: whitespace, punctuation, endings. Потом local syntax и короткие фразы. Затем paragraph structure, terminology, простые facts/code patterns. Только после этого SFT превращает base model в assistant.
Сохраняйте одинаковые sample prompts на каждом checkpoint и сделайте «фильм развития». Это интересно и диагностично: если на 30% run украинский был лучше, чем на 80%, schedule/data mix что-то испортил.
90. Ablation table: меняйте одну вещь и требуйте доказательств
48k vocab против 32k? Matched pilots. GQA? Сравните throughput/memory/eval на равных tokens. Новый mix? Зафиксируйте architecture/optimizer. Intuition в high-dimensional training часто ошибается.
Даже домашний spreadsheet с experiment ID, изменением, seed, tokens, wall time, max VRAM, losses и verdict через 20 runs станет вашей частной «наукой про собственную GPU».
91. Release gate: что нужно до названия «model v1»
Tokenizer/config/weights грузятся из чистого environment; generation smoke test проходит; eval записан; limitations/data provenance описаны; memorization/secrets spot-check выполнен; artifacts имеют hashes; chat template/stop tokens проверены для assistant model.
Если что-то отсутствует, это может быть отличный research checkpoint — просто не production-ready. Честный label «experimental base 100M» повышает доверие.
92. После первой LLM делайте не обязательно большую, а лучше поставленный эксперимент
Часто полезнее сделать v2 того же размера с лучшим data mix/tokenizer/dedup, чем сразу 1B. Если при тех же parameters v2 заметно сильнее — вы научились строить LLM. Если прогресс приходит только от 10× compute, вы научились покупать compute.
Теперь у вас уже есть data factory, training factory, eval harness и baseline. Каждая новая гипотеза становится измеряемым экспериментом — и именно здесь начинается настоящая домашняя LLM-лаборатория.
Не просто понять термины, а пройти весь путь от сырого корпуса до собственной decoder-only LLM и затем сделать из неё instruct-модель.
- Собрать, очистить, дедуплицировать и разделить корпус без утечки validation/test.
- Обучить собственный ByteLevel BPE tokenizer для украинского/русского/кода.
- Инициализировать Llama-подобный decoder с нуля и запустить causal pretraining.
- Посчитать token budget, effective batch, memory trade-offs и примерный compute.
- Перейти от одного GPU к FSDP/ZeRO/Megatron, а затем к SFT и DPO.
Масштаб: от домашнего эксперимента до open frontier-style training
Реальная модель с random weights, которую можно обучать на одном мощном GPU.
3B model, 384 H100, 24 days.
Stage 1 on 512 H100s.
После жёсткого quality filtering web data.
Не путайте четыре разных вида «обучения LLM»
| Режим | Что меняем | Когда это нужно |
|---|---|---|
| Pretraining from scratch | Все weights с random init | Новая базовая модель/язык/архитектура, большие данные и compute |
| Continued pretraining | Все или большинство weights готовой base model | Домен, новый язык, новый knowledge distribution |
| SFT | Поведение на instruction/answer examples | Превратить base model в помощника |
| LoRA/PEFT | Малые low-rank adapters, base frozen | Дешёвая адаптация существующей модели, не pretraining с нуля |
Полный путь к собственной LLM
1. Спецификация
Цель, языки, domains, model size, context, eval и compute budget.
2. Данные
Provenance → cleaning → quality → dedup → decontamination → splits.
3. Tokenizer
Обучить vocabulary на training corpus и проверить segmentation.
4. Pretraining
Random weights → next-token loss → checkpoints → validation.
5. Post-training
SFT → preference optimization → safety/evals → deployment.
Перед большим запуском у вас должны быть
- Замороженные train/valid/test manifests и data provenance.
- Tokenizer version + vocab + special-token contract.
- Model config, seed, optimizer, scheduler, batch formula.
- 100-step smoke test и 1k-step throughput pilot.
- Checkpoint/resume, validation loss и sample generation проверены.
- Disk, network, data-loader и logging не отстают от GPUs.
Вопросы перед первым run
Реально ли обучить LLM дома?
Что важнее: больше parameters или больше data?
Обязательно ли тренировать tokenizer?
LoRA — это обучение своей LLM?
RTX 3090 как домашняя LLM-лаборатория
GDDR6X — главная причина, почему карта до сих пор удобна для домашнего scratch-training.
Официальная спецификация GA102; реальный throughput зависит от всего stack.
Номинальная мощность RTX 3090 FE; wall power всей системы будет другим.
Нижняя оценка при непрерывных 350 W: 0,35 кВт × 24 часа.
Что примерно означает 24 GB VRAM
| Модель | Model-state по rough 18 B/param | Практический смысл |
|---|---|---|
| 100M | ~1,8 GB + activations | Комфортный учебный baseline; есть запас для context/batch. |
| 300M | ~5,4 GB + activations | Реалистичный второй проект; batch/context/kernels уже важны. |
| 700M | ~12,6 GB + activations | Может быть тесно: checkpointing, micro-batch 1 и измерения обязательны. |
| 1B | ~18 GB + activations | Полный AdamW часто становится слишком тесным без memory tricks/offload/sharding. |
OOM: лестница, а не паника
Проверьте утечку
Закройте лишние процессы, уберите references, измерьте peak VRAM на одном step.
Уменьшите micro-batch
Минимально меняет semantics; global batch возвращается accumulation.
Gradient checkpointing
Меняем VRAM на дополнительный compute в backward.
Сократите context
Особенно эффективно, если activations/attention — главный потребитель.
Efficient attention
SDPA/FlashAttention снижает memory traffic и часто peak.
Optimizer/sharding/offload
Только после простых шагов: добавляют complexity и bandwidth costs.
Перед многодневным run
- Tiny-batch overfit test проходит.
- 100-step smoke test проходит без NaN/OOM.
- 1k-step pilot дал стабильные tokens/sec и реальный ETA.
- Dataset/tokenizer/config имеют hashes и manifest.
- Resume из checkpoint реально протестирован.
- Отдельные RU/UK/EN validation curves не деградируют.
- Wall power/температуры/диск имеют запас для длинного run.
- Definition of Done и kill criteria записаны до старта.
Файлы к статье
rankpoint_train_your_own_llm_starter_kit_2026-08-22
Источники и проверка
- Vaswani et al. / arXivAttention Is All You Need
- DeepMind / arXivTraining Compute-Optimal Large Language Models
- Hugging FaceTraining a causal language model from scratch
- Hugging FaceTokenizers Quicktour
- Hugging FaceFineWeb
- Hugging FaceFineWeb-Edu
- Lee et al. / arXivDeduplicating Training Data Makes Language Models Better
- Hugging FaceSmolLM3: smol, multilingual, long-context reasoner
- Allen Institute for AIOLMo 3 Model Training
- PyTorchGetting Started with Fully Sharded Data Parallel (FSDP2)
- DeepSpeedZeRO
- NVIDIAMegatron Core Parallelism Guide
- Dao-AILabFlashAttention
- Hugging FaceMethods and tools for efficient training on a single GPU
- Hugging FaceLlama model documentation / LlamaConfig
- Hugging Face TRLSFT Trainer
- Hugging Face TRLDPO Trainer
- Hugging Face PEFTLoRA conceptual guide
- EleutherAILanguage Model Evaluation Harness
- Lewis et al. / arXivRetrieval-Augmented Generation for Knowledge-Intensive NLP Tasks
- NVIDIATransformer Engine documentation
- Kimi Team / arXivKimi K2: Open Agentic Intelligence
- NVIDIANVIDIA Ampere GA102 GPU Architecture Whitepaper
- PyTorchGetting Started with Distributed Checkpoint (DCP)
Читайте также
Комментарии0 комментариев
Комментарии