В материале
8 разд.Когда команда запускает собственный LLM-сервис, первое впечатление часто обманчиво: модель отвечает, GPU загружен — значит, кажется, все быстро. Проблема начинается под реальной нагрузкой. Десятки и сотни одновременных запросов меняют поведение очередей, KV-cache, prefill и decode, а сам тестовый клиент иногда становится медленнее сервера, который пытается измерить. NVIDIA 18 сентября представила AIPerf — новый инструмент для бенчмаркинга AI inference, который должен заменить GenAI-Perf и убрать именно этот класс ошибок.
Почему обычного load test уже недостаточно
Для классического HTTP API часто хватает requests per second и общей задержки. Генеративная модель ведет себя иначе: пользователь замечает время до первого токена и то, насколько ровно приходят следующие. Сервер может показывать хорошую среднюю latency, но плохой p99 — и именно редкие длинные задержки будут портить чат в часы пик.
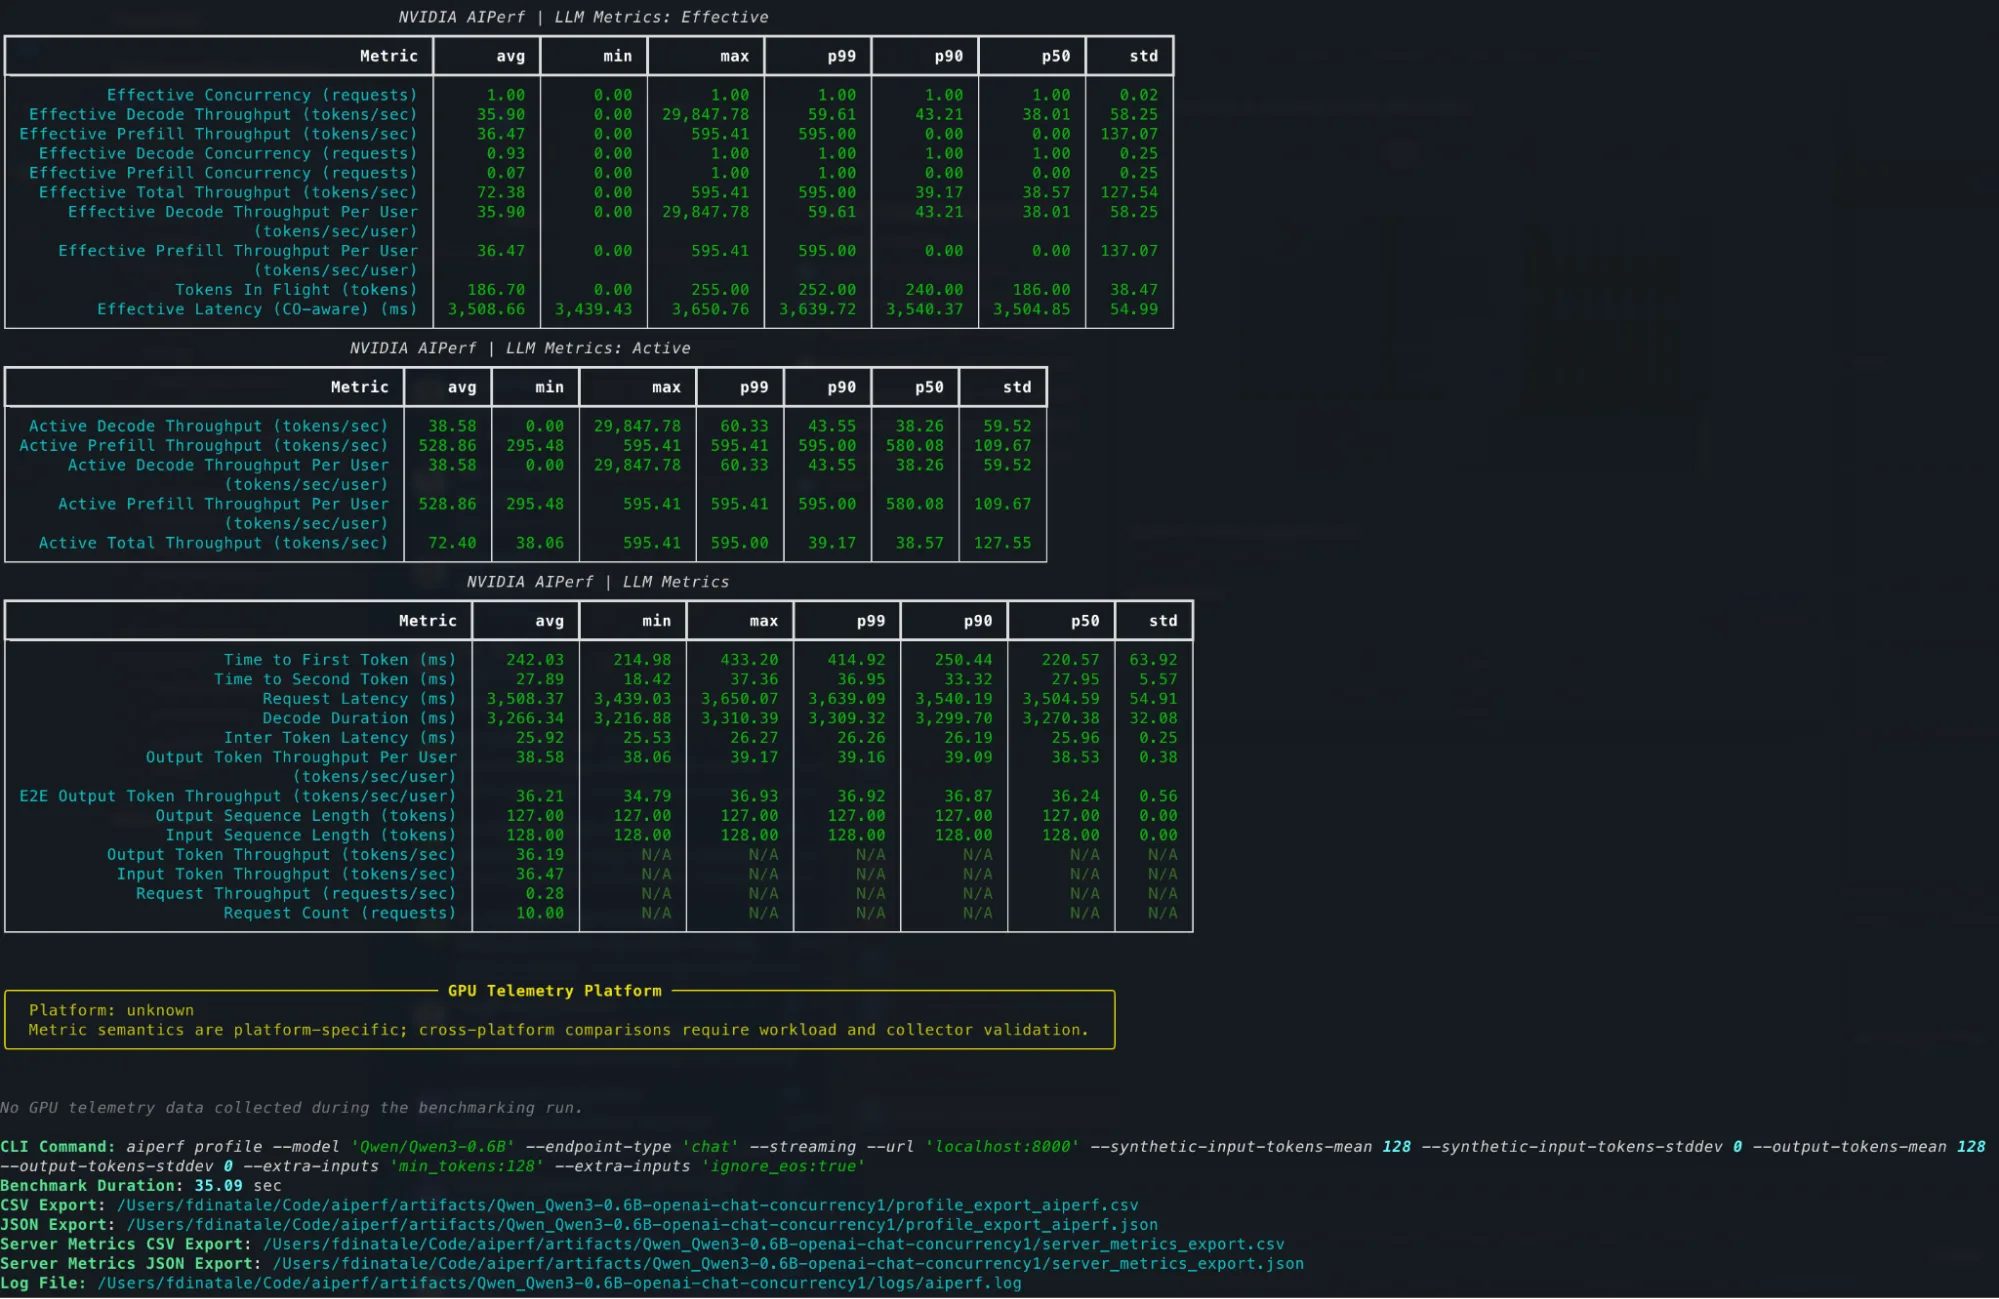
AIPerf выводит на первый план четыре метрики: Time to First Token (TTFT), Inter-Token Latency (ITL), полную request latency и output token throughput. Результаты даются не только средними значениями, но и percentile-распределениями вплоть до p99. При наличии DCGM или pynvml инструмент также собирает загрузку GPU, память и энергопотребление, позволяя связать скачок latency с конкретным состоянием ускорителя.
Главная идея: тестировщик не должен быть узким местом
NVIDIA называет AIPerf полностью переписанным преемником GenAI-Perf. Вместо одного Python-процесса используется multiprocess-архитектура: worker-процессы создают нагрузку, отдельные record processors обрабатывают результаты, а координация идет через ZMQ. Если benchmark-клиент сам упирается в GIL или CPU, измерение уже описывает ограничение генератора трафика, а не LLM-сервера.
На multi-GPU и multi-node системах это особенно заметно. Маленький сервер один клиент еще может насытить, но производительный кластер быстро делает ошибку методики огромной. AIPerf рассчитан на Kubernetes-сценарии, replay производственных трасс, прогрев KV-cache и sweeps по уровням concurrency.
Нагрузку можно приблизить к живому трафику
Статический тест с одинаковой длиной prompt и ответа удобен как baseline, но пользователи не приходят строго по таймеру. AIPerf поддерживает constant, Poisson и gamma arrival patterns, управляемую burstiness и плавное наращивание request rate. Длины входа и выхода тоже можно задавать распределениями. В примере NVIDIA поток Poisson со средними десятью запросами в секунду создает естественные паузы и всплески — и TTFT становится заметно более вариативным.
Заявлена поддержка более 15 типов endpoint, включая chat, responses, NIM rankings и image generation, а также ShareGPT и replay форматов Mooncake, Baseten и WEKA AgentX. Один инструмент можно использовать и для быстрого synthetic smoke test, и для сценария, близкого к production-трафику.
Что это меняет для экономики AI
Правильный benchmark — не спортивная цифра «токенов в секунду». Он помогает понять, сколько одновременных пользователей выдерживает GPU, когда p95 выходит за допустимый предел, нужно ли добавлять еще одну карту и что дает смена batch policy, модели или inference engine. Ошибка в тесте может означать лишнее железо либо сервис, который красиво выглядит в лаборатории и разваливается на пике.
Для украинских команд, которые запускают локальные LLM, RAG, voice-ботов или AI-функции в SaaS, AIPerf интересен как воспроизводимый слой измерений. Сам по себе он не ускоряет модель. Он позволяет одинаково сравнивать изменения в vLLM, SGLang, Dynamo, quantization и конфигурации GPU.
Где нужно сохранять осторожность
Даже хороший benchmark не превращает synthetic workload в реальных людей. Смесь prompt-ов, длина контекста, cache hit rate, tool calls и сетевые задержки могут сильно изменить картину. Поэтому AIPerf полезнее воспринимать как лабораторию контролируемых экспериментов: сначала чистый baseline, затем профиль, похожий на production, и после запуска — сверка с реальной телеметрией.
TTFT и ITL: две цифры, которые пользователь действительно ощущает
Практическая ценность AIPerf в том, что он не сводит все к одному «среднему времени ответа». TTFT показывает паузу до появления первого токена: именно она определяет, кажется ли чат мгновенным или зависшим. ITL измеряет интервалы между следующими токенами и помогает увидеть рывки во время генерации. Для production-сервиса эти показатели важно смотреть не только в среднем, но и по перцентилям: p95 и p99 часто лучше описывают опыт пользователей в часы пик.
AIPerf умеет воспроизводить разные профили трафика — постоянный поток, Poisson, gamma, всплески и постепенное увеличение нагрузки. Для capacity planning это существенно: одна и та же модель на одном GPU может вести себя совершенно по-разному при стабильных 50 запросах в секунду и при коротком пике, когда очередь внезапно увеличивается в несколько раз.
Почему trace replay полезнее «идеального» синтетического теста
В реальном продукте запросы отличаются длиной контекста и ответа, а пользователи приходят не через одинаковые интервалы. Поэтому AIPerf поддерживает публичные наборы вроде ShareGPT и воспроизведение реальных traces. Команда может измерять не абстрактный максимум сервера, а нагрузку, похожую на собственный workload. Дополнительная GPU-телеметрия через DCGM или pynvml позволяет сопоставлять ухудшение latency с загрузкой ускорителя, памятью и другими аппаратными показателями.
AIPerf — новый инструмент NVIDIA для воспроизводимого измерения inference под реалистичной нагрузкой.
- Multiprocess-архитектура снижает риск bottleneck на стороне benchmark-клиента.
- Более 15 типов endpoint и production trace replay.
- TTFT, ITL, latency, throughput и percentile-распределения в одном запуске.
Что измеряет AIPerf
Chat, responses, image generation и другие сценарии.
Latency и token metrics показываются по percentile.
Constant, Poisson и gamma нагрузка.
Источники и проверка
- NVIDIA Technical BlogBenchmarking LLM Inference at Scale with AIPerf
- NVIDIA / GitHubAIPerf repository
Комментарии0 комментариев
Комментарии