У матеріалі
8 розд.Коли команда запускає власний LLM-сервіс, перше відчуття часто оманливе: модель відповідає, GPU завантажений, отже все ніби працює швидко. Проблема починається під реальним навантаженням. Десятки або сотні одночасних запитів змінюють поведінку черг, KV-cache, prefill і decode, а сам тестовий клієнт інколи стає повільнішим за сервер, який він намагається виміряти. NVIDIA 18 вересня представила AIPerf — новий інструмент для бенчмаркінгу AI inference, який має замінити GenAI-Perf і прибрати саме цей клас похибок.
Чому звичайний load test уже недостатній
Для класичного HTTP API достатньо знати requests per second і затримку. Генеративна модель поводиться інакше: користувач бачить не лише повний час відповіді, а й те, скільки чекає на перший токен і наскільки рівномірно приходять наступні. Сервер може мати красиву середню latency, але поганий p99 — і саме ці рідкісні «довгі хвости» робитимуть чат неприємним у години пікового навантаження.
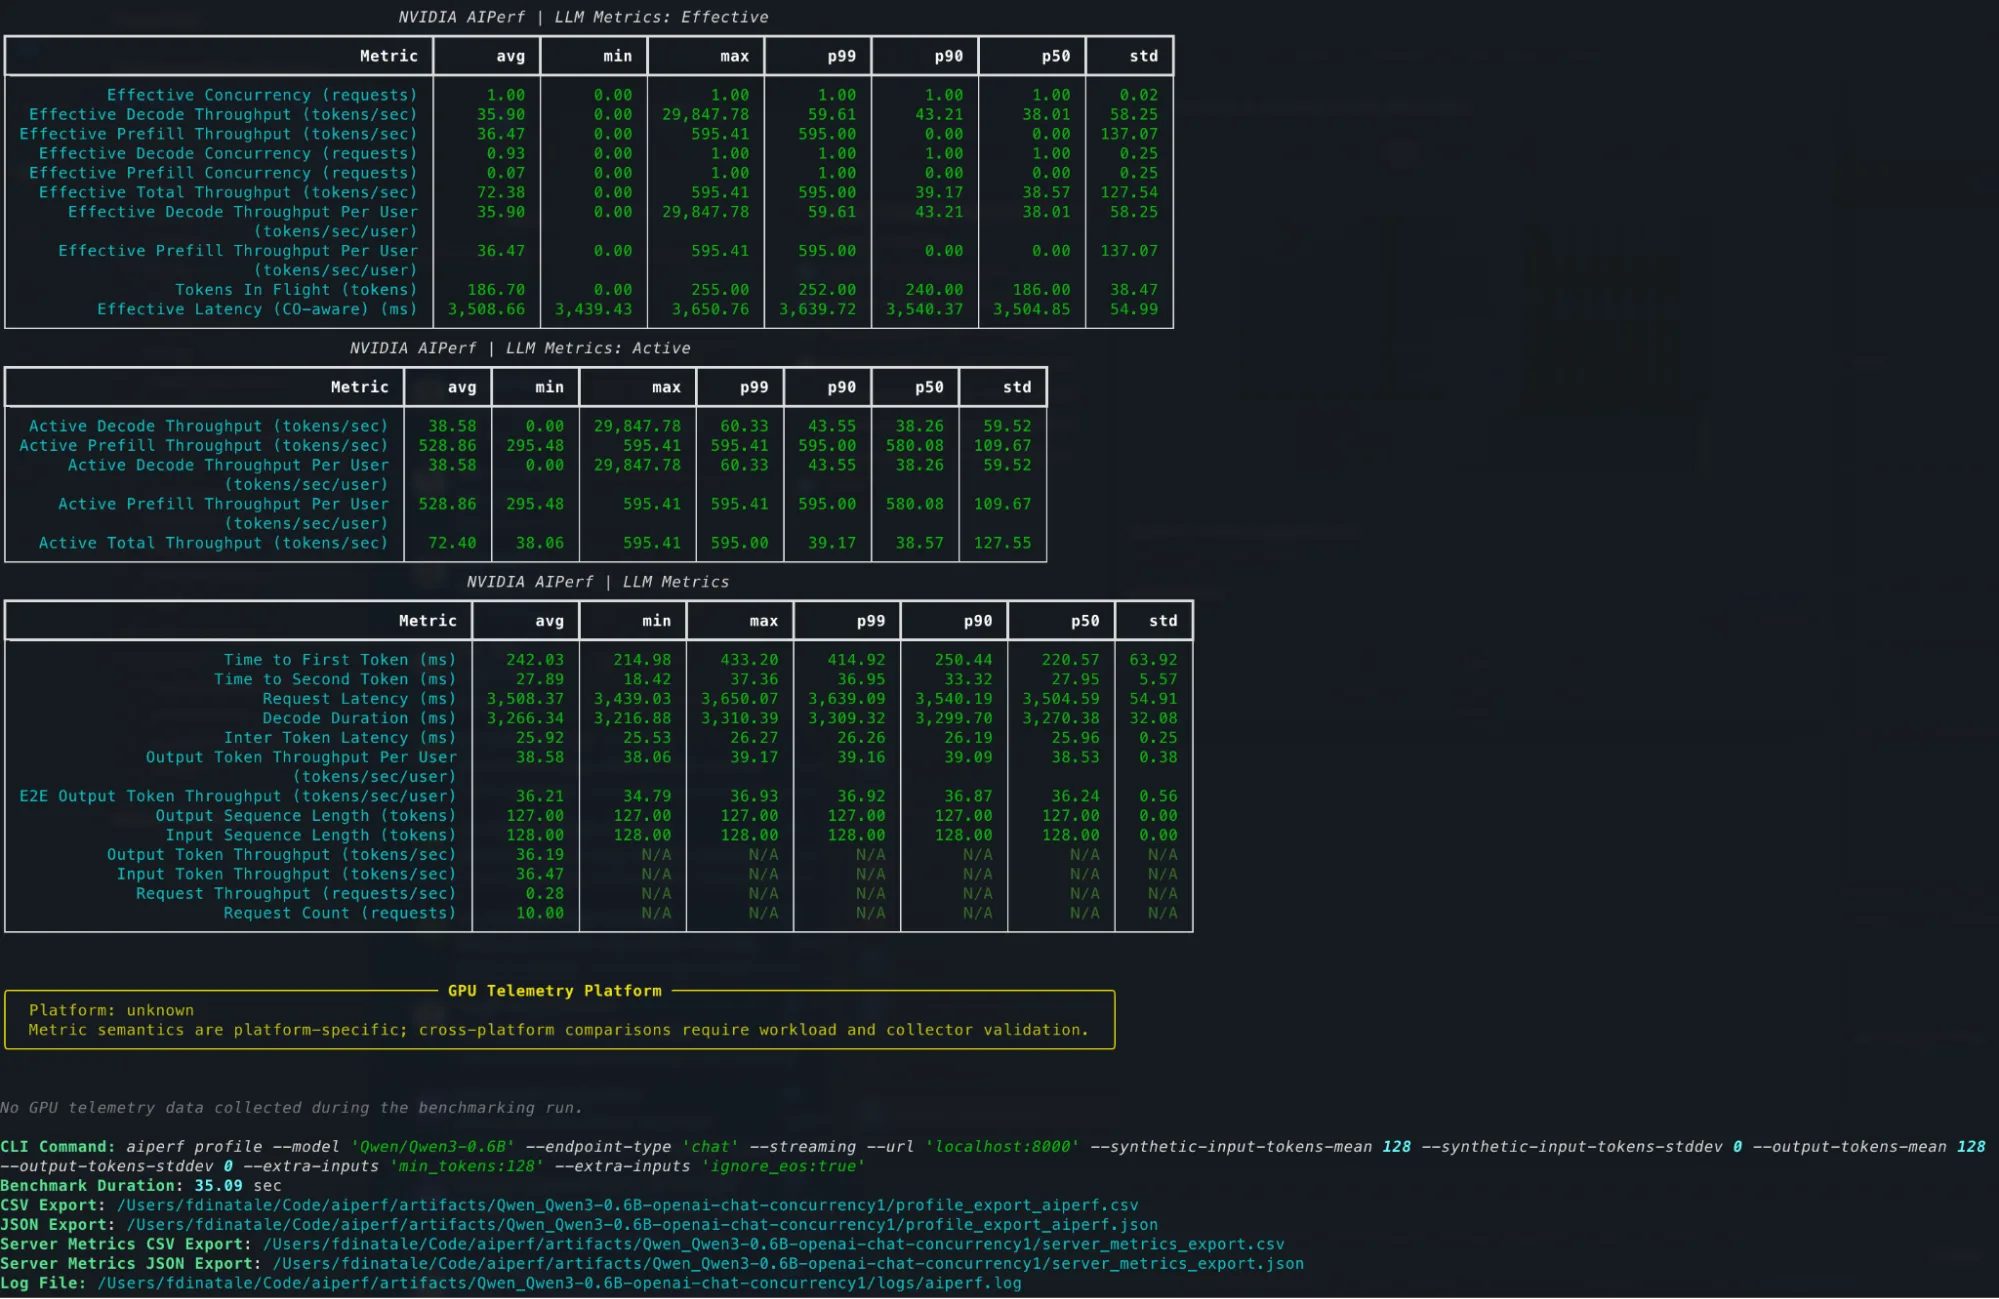
AIPerf виносить у центр чотири метрики: Time to First Token (TTFT), Inter-Token Latency (ITL), загальну request latency та output token throughput. Результати показуються не лише середнім значенням, а й percentile-розподілами до p99. Якщо доступні DCGM або pynvml, тест також підтягує використання GPU, пам’яті й енергоспоживання, щоб інженер міг побачити, чи збіглася просадка latency, наприклад, із тиском на пам’ять.
Головна зміна — тестувальник не повинен бути вузьким місцем
NVIDIA називає AIPerf повністю переписаним наступником GenAI-Perf. Замість одного Python-процесу використовується multiprocess-архітектура: окремі worker-процеси генерують навантаження, окремі record processors обробляють результати, а координація відбувається через ZMQ. Ідея проста: якщо benchmarking client упирається у GIL або власну CPU-продуктивність, цифри вже описують не LLM-сервер, а слабке місце генератора навантаження.
Це особливо важливо для multi-GPU та multi-node систем. На невеликій моделі один клієнт ще може встигати генерувати запити, але на кластері з високою пропускною здатністю помилка методики швидко стає великою. AIPerf розрахований і на Kubernetes-сценарії, replay виробничих трас, прогрів KV-cache та sweeps по різних рівнях concurrency.
Навантаження можна зробити схожим на живий трафік
Статичний тест із однаковими prompt та output length корисний для базової точки, але люди не надсилають запити через рівні проміжки часу. AIPerf підтримує constant, Poisson і gamma arrival patterns, керовану burstiness та поступове нарощування request rate. Для prompt/output length можна задавати розподіли замість одного числа. У демонстрації NVIDIA Poisson-потік із середніми десятьма запитами на секунду створює природні паузи й сплески — саме в таких умовах ширшає розподіл TTFT.
Підтримка охоплює понад 15 типів endpoint, зокрема chat, responses, NIM rankings та image generation. Є ShareGPT та replay форматів Mooncake, Baseten і WEKA AgentX. Тобто один інструмент можна використовувати як для швидкого synthetic smoke test, так і для більш близького до production повторення реального профілю трафіку.
Що це змінює для команд, які рахують економіку AI
Для бізнесу правильний benchmark — це не спортивне число «токенів за секунду». Він відповідає на практичні питання: скільки одночасних користувачів витримає GPU, коли p95 стає неприйнятним, чи варто додати ще одну карту, чи є сенс міняти batch policy, модель або inference engine. Помилка в тесті легко перетворюється на зайві сервери або, навпаки, на систему, що падає під реальним піком.
Українським командам, які запускають локальні LLM, RAG, voice-ботів або AI-функції у власних SaaS, AIPerf цікавий саме як відтворюваний шар вимірювання. Він не робить модель швидшою сам по собі. Його користь у тому, що зміни в vLLM, SGLang, Dynamo, quantization чи конфігурації GPU можна порівнювати однаковою методикою, а не «на око».
Де варто бути обережним
Навіть хороший benchmark не перетворює synthetic workload на реальних користувачів. Prompt mix, довжина контексту, cache hit rate, tool calls і мережеві затримки можуть сильно змінити результат. Тому AIPerf найкраще сприймати не як одну магічну цифру, а як лабораторію для контрольованих експериментів. Найсильніший сценарій — спочатку зафіксувати чистий baseline, потім відтворити розподіли, близькі до production, а після запуску звірити їх із реальною телеметрією.
TTFT і ITL: дві цифри, які користувач реально відчуває
Практична цінність AIPerf у тому, що він не зводить усе до одного «середнього часу відповіді». TTFT показує паузу до появи першого токена: саме вона визначає, чи здається чат миттєвим або «завислим». ITL вимірює інтервал між наступними токенами й допомагає побачити ривки під час генерації. Для production-сервісу ці метрики треба дивитися не лише в середньому, а й по перцентилях, бо p95 або p99 часто краще описують досвід користувачів у пікові моменти.
AIPerf також дозволяє відтворювати різні профілі трафіку — рівномірний, Poisson, gamma, сплески й поступове нарощування навантаження. Це важливо для capacity planning: одна й та сама модель на тому самому GPU може поводитися зовсім по-різному при стабільних 50 запитах за секунду й при коротких піках, коли черга раптово виростає в кілька разів.
Чому trace replay корисніший за «ідеальний» синтетичний тест
У реальному продукті запити мають різну довжину контексту й відповіді, а користувачі не приходять через однакові інтервали. Тому AIPerf підтримує public datasets на кшталт ShareGPT і replay реальних traces. Для команди це дає можливість перевірити не абстрактний максимум сервера, а сценарій, максимально схожий на власний workload. А окрема GPU-телеметрія через DCGM або pynvml допомагає співвіднести деградацію latency з утилізацією прискорювача, пам’яттю та іншими апаратними показниками.
AIPerf — новий інструмент NVIDIA для відтворюваного вимірювання inference під реалістичним навантаженням.
- Multiprocess-архітектура зменшує ризик, що bottleneck виникне на стороні benchmark-клієнта.
- Понад 15 типів endpoint і production trace replay.
- TTFT, ITL, latency, throughput та percentile-розподіли — в одному запуску.
Що вимірює AIPerf
Chat, responses, image generation та інші сценарії.
Latency і token metrics показуються по percentile.
Constant, Poisson і gamma навантаження.
Джерела та перевірка
- NVIDIA Technical BlogBenchmarking LLM Inference at Scale with AIPerf
- NVIDIA / GitHubAIPerf repository
Коментарі0 коментарів
Коментарі