
В материале
6 разд.Четыре буквы — не закон природы
Когда в школе объясняют DNA, четыре базы быстро начинают казаться чем-то неизбежным: adenine спаривается с thymine, guanine — с cytosine, и на этом будто всё. На самом деле это лишь один химический алфавит, который исторически закрепила земная эволюция. Нет фундаментального физического закона, запрещающего молекулам хранить информацию в большем количестве взаимно совместимых base pairs.
Именно эту идею годами развивает synthetic genetics. Hachimoji — японское слово, буквально означающее “восемь букв”, — добавляет к природным A, T, G и C ещё четыре синтетические базы: P, Z, B и S. Они образуют две дополнительные ортогональные пары P:Z и B:S. “Ортогональные” здесь означает, что новые партнёры должны узнавать друг друга и как можно меньше путаться с природными парами.
В предыдущих работах Hachimoji DNA уже показала, что расширенный double helix может хранить информацию, иметь предсказуемую thermodynamics и в целом сохранять привычную геометрию DNA. Но хранить последовательность — лишь половина биологии. Информация полезна, когда клеточная машина способна её прочитать. И здесь появляется гораздо более жёсткий тест: пропустит ли чужие bases активный центр RNA polymerase, эволюционировавшей миллиарды лет на четырёхбуквенном алфавите?
Новая работа в Nature Communications отвечает: как минимум на этапе transcription — да, и заметно лучше, чем можно было бы ожидать. Исследователи использовали E. coli RNA polymerase и показали, что она способна включать RNA counterparts для неприродных P:Z и B:S pairs. Фермент не пришлось полностью перепроектировать: природная машина оказалась достаточно пластичной, чтобы принять неприродную химию.
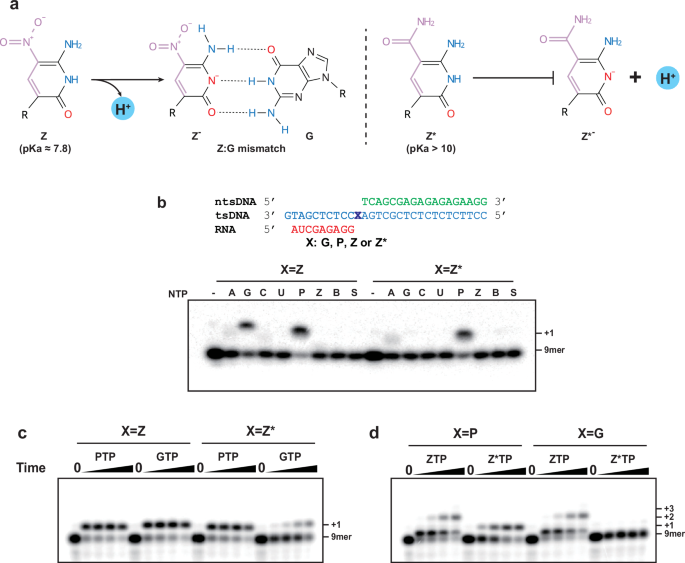
Авторы проверили не пару красивых примеров, а полную небольшую матрицу selectivity: 32 template–NTP combinations — четыре scaffolds с dZ, dP, dS или dB против восьми возможных nucleotide triphosphates. Для правильных unnatural partners чёткий band shift появлялся уже в течение 15 секунд, а observed rates для dZ:PTP и dP:ZTP были лишь примерно вдвое ниже природной dG:CTP pair в тех же условиях.
Cryo-EM показал, почему фермент не “видит” катастрофы
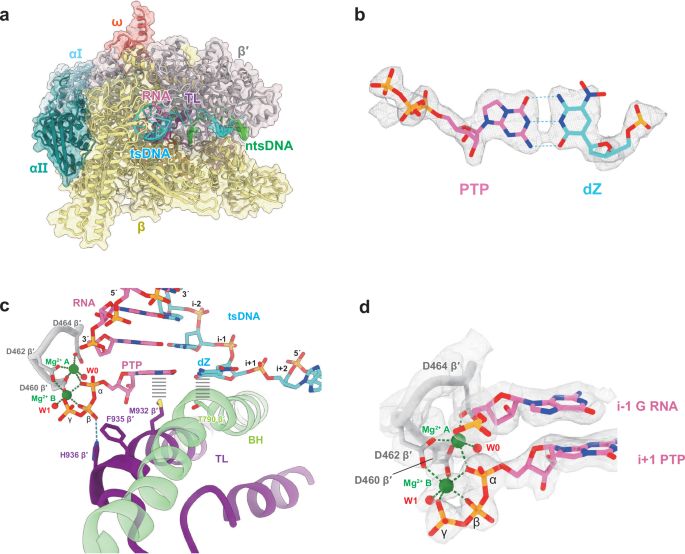
Самая сильная часть работы — не просто biochemical assay, а структурное объяснение. Команда получила четыре cryo-EM structures transcription complexes с resolution примерно 2.42–2.75 Å. На таком уровне уже можно смотреть не на абстрактную схему, а на то, как base pair реально размещается в active site polymerase.
Оказалось, что неприродные P:Z и B:S ведут себя очень хитро: несмотря на другую химию, их геометрия достаточно близка к привычной Watson–Crick-like architecture. Для enzyme это критично. Polymerase не “читает название буквы”; она проверяет набор пространственных и химических условий — форму, hydrogen-bonding pattern, правильную геометрию nascent base pair. Если неприродная пара проходит этот контроль, machinery может работать с ней без полного переписывания active site.
Скорость, впрочем, не идеальна. Для P:Z incorporation авторы получили rates примерно вдвое ниже, чем для природной reference reaction в сопоставимых условиях. Но это не провал: для искусственной пары, которую природа никогда не отбирала для работы с E. coli polymerase, “в два раза медленнее” выглядит скорее как неожиданно высокая совместимость.
Работа одновременно показывает, где расширенный alphabet ещё спотыкается. Самая заметная проблема — misincorporation между Z и природным G. Химические свойства Z могут создавать нежелательные tautomeric/protonation states, из-за чего fidelity падает. Авторы поэтому тестируют модифицированную базу Z*: nitro group заменена на carboxamide, а 2′-fluoro substitution помогает поднять pKa выше 10. В итоге нежелательное G:Z* pairing уменьшается. Это характерная история synthetic biology: “добавить букву” мало — нужно ещё сделать так, чтобы cellular machinery не путала её с уже существующим alphabet.
Самая интересная химическая проблема оказалась не в том, что polymerase “не принимает чужую букву”, а в том, что одна из чужих букв оказалась слишком химически гибкой. Nitro group в Z снижает pKa nucleobase примерно до 7,8; после deprotonation Z⁻ может образовать Watson–Crick-like mismatch с G. Авторы заменили nitro group на carboxamide и добавили 2′-fluoro — так появился Z* с pKa выше 10, который заметно уменьшил G-mispairing без потери правильного P:Z* recognition.
Что можно сделать с восемью буквами — и чего пока нельзя
Самое простое искушение — сразу сказать, что учёные “создали восьмибуквенную жизнь”. Это неправильно. В работе показана transcription: DNA template с неприродными bases может быть прочитан RNA polymerase и переписан в RNA. Но полный информационный цикл DNA → RNA → protein для произвольного восьмибуквенного code ещё не собран. Рибосома, tRNA, aminoacyl-tRNA synthetases и весь translation layer имеют свои ограничения, и никто здесь не продемонстрировал organism, живущий на полностью Hachimoji genome.
Однако transcription уже открывает практические двери. Расширенный alphabet увеличивает chemical diversity nucleic acids и может дать RNA/DNA molecules со свойствами, которых сложнее добиться четырьмя природными bases. Один из направлений — aptamers и так называемые AegisBinders: synthetic nucleic-acid binders, где дополнительные functional groups и новые hydrogen-bonding patterns могут повышать affinity и specificity к target molecules.
Есть и информационный аргумент. Четырёхбуквенный alphabet имеет 4^n возможных sequence combinations для n positions. Восьмибуквенный — 8^n. Это не означает, что биологическая система автоматически использует весь этот combinatorial space, но потенциальная плотность sequence space растёт драматически. Для molecular barcoding, data storage, diagnostics и directed evolution это может быть очень полезно.
Ещё интереснее фундаментальный вопрос. Если natural polymerase способна принять чужие base pairs, то “жизнеподобная” molecular information processing может быть меньше привязана к конкретным A/T/G/C, чем мы привыкли думать. Это не доказательство существования иной биохимии во Вселенной, но хороший reminder для astrobiology: земной генетический alphabet — пример того, что работает, а не обязательно единственно возможный вариант.
В этом и сила работы. Она не создаёт фантастический организм с новым genetic code. Она делает нечто более технически важное: показывает, что один из центральных ферментов жизни имеет запас совместимости с химией, которой эволюция никогда ему не давала. А если transcription layer уже настолько гибок, следующий вопрос звучит естественно: сколько ещё “правил жизни” на самом деле являются лишь привычками земной биологии?
Исследователи проверили не просто стабильность Hachimoji DNA, а совместимость восьмибуквенного алфавита с реальной bacterial transcription machinery.
- Hachimoji alphabet содержит 8 bases: природные A, T, G, C и synthetic P, Z, B, S.
- Новые ортогональные пары — P:Z и B:S.
- E. coli RNA polymerase смогла транскрибировать templates с обеими неприродными pairs.
- Cryo-EM structures получены с resolution примерно 2.42–2.75 Å.
- P:Z incorporation в тестах была примерно в 2× медленнее природной reference reaction, но оставалась эффективной.
- Полного восьмибуквенного цикла DNA → RNA → protein работа не демонстрирует.
- Главной fidelity-проблемой стала не “чужеродность” буквы, а химия Z: её deprotonation позволяла Z:G mismatch. Аналог Z* существенно это исправил.
Восьмибуквенная генетика в цифрах
Четыре природные и четыре синтетические nucleobases.
P:Z и B:S добавляются к A:T и G:C.
Структуры transcription complexes с unnatural pairs.
Детальность структурного анализа active site.
Полная матрица четырёх unnatural templates против восьми NTPs.
Правильные unnatural incorporations давали чёткий продукт уже на раннем time point.
Carboxamide analogue подавляет deprotonation и Z:G mismatch.
Где мы уже находимся — и где ещё нет
| Уровень | Что показано | Чего пока нет |
|---|---|---|
| Хранение информации | Hachimoji DNA может формировать стабильный расширенный double helix | Не означает, что клетка автоматически поддерживает такой genome |
| Transcription | E. coli RNA polymerase читает P:Z и B:S templates | Fidelity и kinetics ещё требуют оптимизации |
| Translation | Эта работа не демонстрирует полный 8-letter protein code | Нет organism, который переводит произвольный Hachimoji code в proteins |
Короткие ответы
Это уже новая форма жизни?
Почему обычная RNA polymerase вообще это читает?
Зачем больше букв, если четырёх хватает жизни?
Источники и проверка
- Nature CommunicationsStructural basis of transcription of the hachimoji eight-letter alphabet by E. coli RNA polymerase
- UC San Diego TodayBreakthrough helps expand genetic alphabet
Комментарии0 комментариев
Комментарии