
У матеріалі
6 розд.Чотири літери — не закон природи
Коли в школі пояснюють DNA, чотири бази швидко починають здаватися чимось неминучим: adenine парує з thymine, guanine — з cytosine, і на цьому ніби все. Насправді це лише один хімічний алфавіт, який історично закріпила земна еволюція. Немає фундаментального фізичного закону, який забороняє молекулам зберігати інформацію в більшій кількості взаємно сумісних base pairs.
Саме цю ідею роками розвиває напрям synthetic genetics. Hachimoji — японське слово, яке буквально означає “вісім літер” — додає до природних A, T, G і C ще чотири синтетичні бази: P, Z, B і S. Вони утворюють дві додаткові ортогональні пари P:Z та B:S. Ключове слово тут “ортогональні”: нові партнери мають впізнавати одне одного й мінімально плутатися з природними парами.
Ще у попередніх роботах Hachimoji DNA показала, що розширений double helix може зберігати інформацію, мати передбачувану thermodynamics і загалом нагадувати природну DNA за геометрією. Але зберігати послідовність — лише половина життя. Біологічна інформація корисна тоді, коли клітинна машина може її прочитати. І тут виникає набагато жорсткіша перевірка: чи пропустить чужі bases активний центр RNA polymerase, яка еволюціонувала мільярди років на чотирилітерному алфавіті?
Нова робота в Nature Communications відповідає: принаймні на етапі transcription — так, і значно краще, ніж можна було б очікувати. Дослідники використали E. coli RNA polymerase і показали, що вона здатна включати RNA counterparts для неприродних P:Z та B:S pairs. Тобто enzyme не довелося повністю перепроєктовувати під новий alphabet: природна машина виявилася достатньо пластичною, щоб прийняти неприродну хімію.
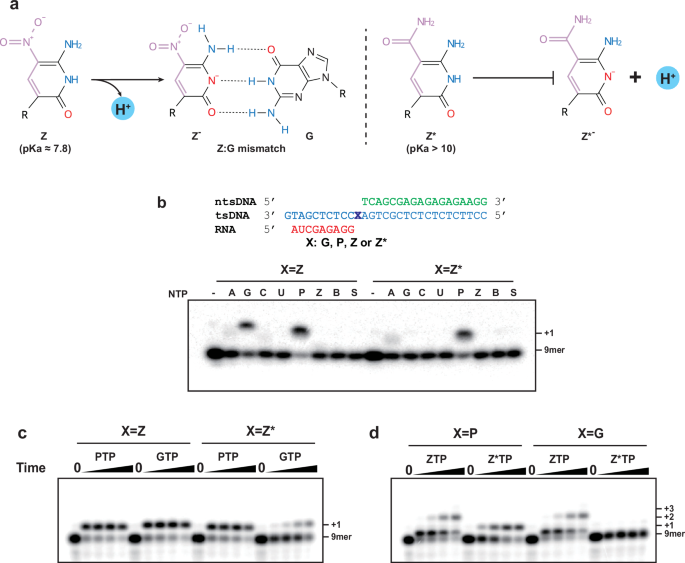
Автори перевірили не пару красивих прикладів, а повну маленьку матрицю selectivity: 32 template–NTP combinations — чотири scaffolds із dZ, dP, dS або dB проти восьми можливих nucleotide triphosphates. Для правильних unnatural partners чіткий band shift з’являвся вже протягом 15 секунд, а observed rates для dZ:PTP і dP:ZTP були лише приблизно вдвічі нижчими за природну dG:CTP pair у тих самих умовах.
Cryo-EM показав, чому фермент не “бачить” катастрофи
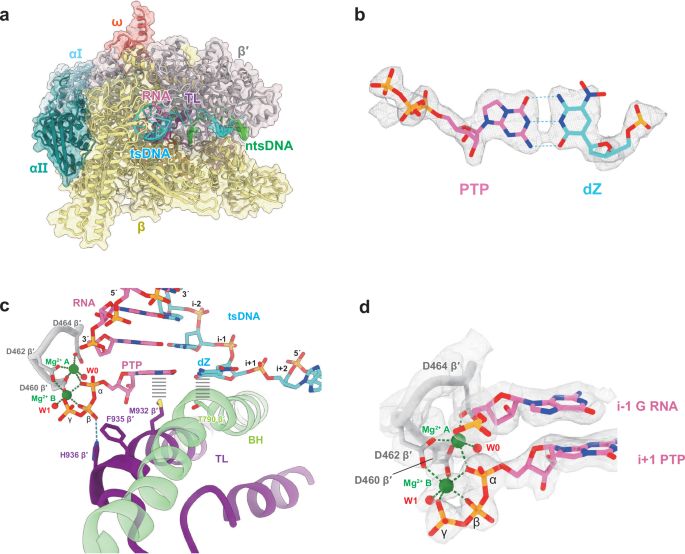
Найсильніша частина роботи — не просто biochemical assay, а структурне пояснення. Команда отримала чотири cryo-EM structures transcription complexes із resolution приблизно 2.42–2.75 Å. На такому рівні вже можна дивитися не на абстрактну схему, а на те, як base pair реально розміщується в active site polymerase.
І виявилося, що неприродні P:Z і B:S поводяться дуже хитро: попри іншу хімію, їхня геометрія достатньо близька до звичної Watson–Crick-like architecture. Для enzyme це критично. Polymerase не “читає назву букви”; вона перевіряє набір просторових і хімічних умов — форму, hydrogen-bonding pattern, правильну геометрію nascent base pair. Якщо неприродна пара проходить цей геометричний контроль, machinery може працювати з нею без повного переписування active site.
Швидкість, однак, не ідеальна. Для P:Z incorporation автори отримали rates приблизно вдвічі нижчі за природну G:C-like reaction у зіставних умовах. Але це не провал: для штучної пари, яку природа ніколи не відбирала для роботи з E. coli polymerase, “у два рази повільніше” виглядає радше як несподівано висока сумісність.
Робота одночасно показує, де розширений alphabet ще спотикається. Найпомітніша проблема — misincorporation між Z і природним G. Хімічні властивості Z можуть створювати небажані tautomeric/protonation states, через які fidelity падає. Автори тому тестують модифіковану базу Z*: nitro group замінена на carboxamide, а 2′-fluoro substitution допомагає підняти pKa вище 10. У результаті небажане G:Z* pairing зменшується. Це дуже характерна історія synthetic biology: “додати літеру” мало — треба ще зробити так, щоб cellular machinery не плутала її з уже існуючим alphabet.
Найцікавіша хімічна проблема виявилася не в тому, що polymerase “не приймає чужу літеру”, а в тому, що одна з чужих літер виявилася занадто хімічно гнучкою. Nitro group у Z знижує pKa nucleobase приблизно до 7,8; після deprotonation Z⁻ може утворити Watson–Crick-like mismatch із G. Автори замінили nitro group на carboxamide і додали 2′-fluoro — так з’явився Z* із pKa понад 10, що значно зменшило G-mispairing без втрати правильного P:Z* recognition.
Що можна зробити з вісьмома літерами — і чого поки не можна
Найпростіша спокуса — одразу сказати, що вчені “створили восьмилітерне життя”. Це неправильно. У роботі показано transcription: DNA template із неприродними bases може бути прочитаний RNA polymerase й переписаний у RNA. Але повний інформаційний цикл DNA → RNA → protein для довільного восьмилітерного code ще не зібраний. Рибосома, tRNA, aminoacyl-tRNA synthetases та весь translation layer мають свої обмеження, і ніхто тут не продемонстрував organism, який живе на повністю Hachimoji genome.
Проте transcription уже відкриває практичні двері. Розширений alphabet збільшує chemical diversity nucleic acids і може дати RNA/DNA molecules із властивостями, яких важче досягти чотирма природними bases. Один із напрямів — aptamers і так звані AegisBinders: synthetic nucleic-acid binders, де додаткові functional groups та нові hydrogen-bonding patterns можуть підвищувати affinity і specificity до target molecules.
Є й інформаційний аргумент. Чотирилітерний alphabet має 4^n можливих sequence combinations для n positions. Восьмилітерний — 8^n. Це не означає, що біологічна система автоматично використовує весь цей combinatorial space, але потенційна density sequence space росте драматично. Для molecular barcoding, data storage, diagnostics і directed evolution це може бути дуже корисно.
Ще цікавіше фундаментальне питання. Якщо natural polymerase здатна прийняти чужі base pairs, то “життєподібна” molecular information processing може бути менш прив’язана до конкретних A/T/G/C, ніж ми звикли думати. Це не доказ існування іншої біохімії у Всесвіті, але хороший reminder для astrobiology: земний генетичний alphabet — приклад того, що працює, а не обов’язково єдиний можливий варіант.
У цьому й сила роботи. Вона не створює фантастичний організм із новим genetic code. Вона робить щось більш технічно важливе: показує, що один із центральних ферментів життя має запас сумісності з хімією, якої еволюція ніколи йому не давала. А якщо transcription layer уже настільки гнучкий, наступне питання звучить природно: скільки ще “правил життя” насправді є лише звичками земної біології?
Дослідники перевірили не просто стабільність Hachimoji DNA, а сумісність восьмилітерного алфавіту з реальною bacterial transcription machinery.
- Hachimoji alphabet містить 8 bases: природні A, T, G, C та synthetic P, Z, B, S.
- Нові ортогональні пари — P:Z і B:S.
- E. coli RNA polymerase змогла транскрибувати templates з обома неприродними pairs.
- Cryo-EM structures отримані з resolution приблизно 2.42–2.75 Å.
- P:Z incorporation у тестах була приблизно у 2× повільнішою за природну reference reaction, але залишалася ефективною.
- Повного восьмилітерного циклу DNA → RNA → protein робота не демонструє.
- Головною fidelity-проблемою стала не “чужість” літери, а хімія Z: її deprotonation дозволяла Z:G mismatch. Аналог Z* суттєво це виправив.
Восьмилітерна генетика в цифрах
Чотири природні та чотири синтетичні nucleobases.
P:Z та B:S додаються до A:T і G:C.
Структури transcription complexes з unnatural pairs.
Детальність структурного аналізу active site.
Повна матриця чотирьох unnatural templates проти восьми NTPs.
Правильні unnatural incorporations давали чіткий продукт уже на ранньому time point.
Carboxamide analogue пригнічує deprotonation і Z:G mismatch.
Де ми вже є — і де ще ні
| Рівень | Що показано | Чого поки немає |
|---|---|---|
| Зберігання інформації | Hachimoji DNA може формувати стабільний розширений double helix | Не означає, що клітина автоматично підтримує такий genome |
| Transcription | E. coli RNA polymerase читає P:Z і B:S templates | Fidelity і kinetics ще потребують оптимізації |
| Translation | Ця робота не демонструє повний 8-letter protein code | Немає organism, який перекладає довільний Hachimoji code у proteins |
Короткі відповіді
Це вже нова форма життя?
Чому звичайна RNA polymerase взагалі це читає?
Навіщо більше літер, якщо чотирьох вистачає життю?
Джерела та перевірка
- Nature CommunicationsStructural basis of transcription of the hachimoji eight-letter alphabet by E. coli RNA polymerase
- UC San Diego TodayBreakthrough helps expand genetic alphabet
Коментарі0 коментарів
Коментарі