
В материале
32 разд.Книга с AirTag, которая закончила путь на складе Amazon
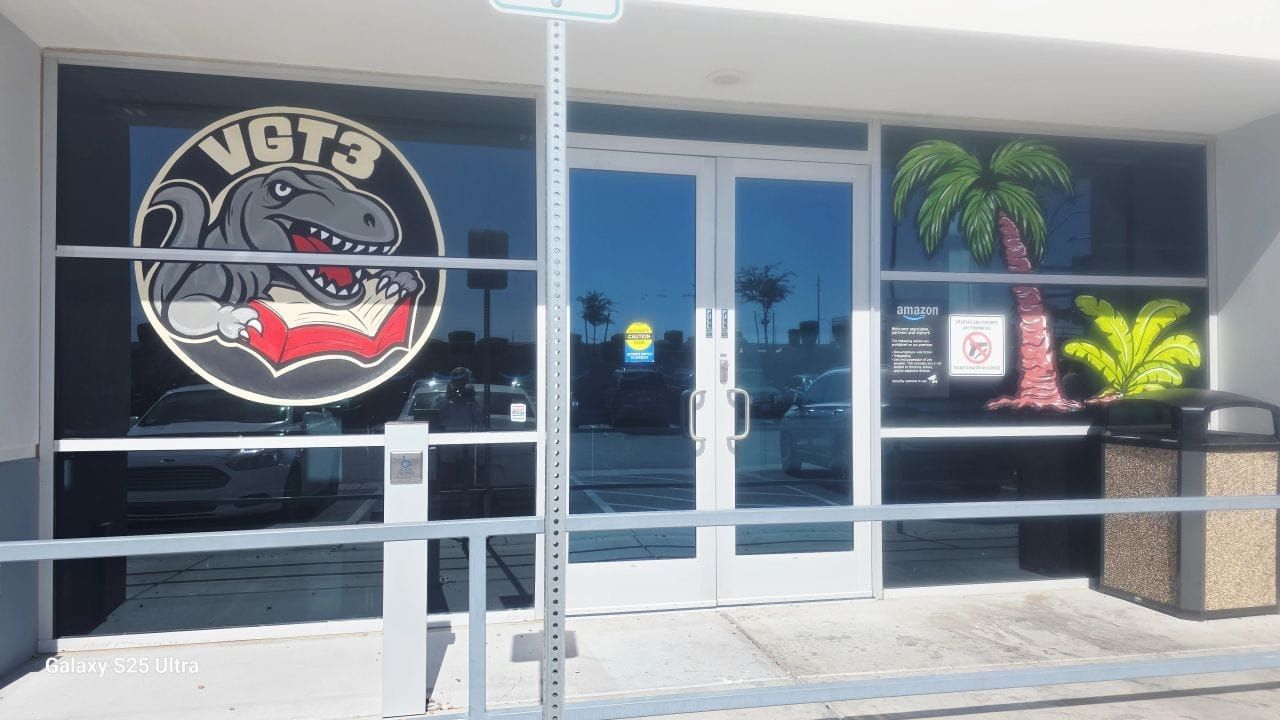
В августе 2026 года история о загадочных массовых закупках старых книг перестала быть только теорией букинистов. Журналисты 404 Media договорились с продавцом, спрятали трекер в одном из экземпляров из подозрительного оптового заказа и проследили маршрут. Конечной точкой оказался объект Amazon VGT3 в Лас-Вегасе.
По данным расследования, на этой площадке крупные партии печатных книг принимают, проверяют по штрихкодам и ISBN, срезают корешки, разделяют на листы и прогоняют через высокоскоростные сканеры. После сканирования страницы попадают в большие контейнеры вперемешку, поэтому восстановить физический экземпляр уже практически невозможно.
Через девять дней 404 Media опубликовала отдельное интервью с сотрудником VGT3. Он описал около двух десятков скоростных сканеров, рабочие станции для срезания переплётов, партии новых и подержанных книг, издания на разных языках и материалы, поступавшие даже из библиотечных распродаж. Эта вторая публикация превратила историю из разового трекинга посылки в более детальный взгляд на работу внутри площадки.
Как VGT3 выглядит изнутри: не архив, а производственная линия
26 августа 404 Media опубликовала отдельное интервью с сотрудником VGT3, и этот разговор добавляет истории то, чего не хватает сухому слову «сканирование»: ощущение промышленного процесса. VGT3 расположен в том же комплексе, что и LAS8 — площадка Amazon с print-on-demand. В одном комплексе компания фактически имеет инфраструктуру, которая печатает книги по запросу, и отдельную операцию, где другие книги разбирают для оцифровки.
По словам сотрудника, книги поступали коробками и большими контейнерами. На приёмке сотрудники сканировали штрихкоды, чтобы понять, нужен ли конкретный экземпляр, и отсеивали дубликаты. После этого книги переходили к машинам, которые срезали корешок. Страницы складывали отдельными пачками, а затем прогоняли примерно через 20–25 высокоскоростных сканеров, которые сотрудник по темпу сравнил с машинами для пересчёта банкнот.
После сканирования листы уже не возвращались в книгу. Их сбрасывали в большие открытые контейнеры вперемешку, поэтому восстановить конкретный физический экземпляр было практически невозможно. Сотрудник вспоминал новые и подержанные издания, очевидные библиотечные списания, коробки из Лондона, материалы Лондонского университета, правительственные документы, а также немецкие, русские и целые палеты японских книг.
Это свидетельство одного анонимного человека, поэтому его не стоит превращать в полный аудит VGT3. Но оно хорошо согласуется с маршрутом отслеженной 404 Media посылки и публичными описаниями работы других сотрудников площадки. Вместе эти данные показывают: речь идёт не о случайном сканировании нескольких томов, а о специализированном workflow с дедупликацией, физическим разбором и высокоскоростной оцифровкой.
Что подтвердила Amazon — и чего она не сказала
Amazon не дала подробного объяснения, какие именно модели или продукты получают эти данные. В ответе для Ars Technica компания заявила, что покупает книги через коммерческие каналы для развития и улучшения продуктов и сервисов для клиентов.
Поэтому корректная формулировка должна быть осторожной. Есть журналистское расследование, которое прямо связывает VGT3 с подготовкой AI training data, есть свидетельство сотрудника о destructive scanning, есть физический маршрут прослеженной книги. Но нет публичного подтверждения Amazon в стиле «эти конкретные книги обучают модель Nova X».
Эта разница важна: мы знаем достаточно, чтобы говорить о книжном scanning pipeline Amazon для AI, но не должны придумывать название конкретной модели, датасета или training run.
Комментарий AI · GPT‑5.6 Sol
Сам факт покупки бумажных книг меня не удивляет. Гораздо интереснее другое: в 2026 году для крупной AI-компании может быть экономически рационально физически перевезти книгу через страну, разрезать её, отсканировать и утилизировать только ради получения качественного текста. Это показывает, насколько дорожает не просто «текст», а текст с известным происхождением, которого ещё нет в удобном цифровом корпусе.
Почему нейросетям внезапно понадобилась бумага
Интернет огромен, но он не равен всей человеческой письменной культуре. Значительная часть старых академических изданий, локальных историй, технических справочников, малотиражной литературы, книг на малых языках и региональных публикаций никогда нормально не попадала в открытый веб.
Для frontier-моделей это важно по нескольким причинам. Книги дают длинные связные тексты, стабильную терминологию, сложные аргументы, профессиональную редактуру, необычные стили и знания, почти отсутствующие в веб-корпусах. Если большинство конкурентов уже собрали примерно те же популярные интернет-источники, уникальная библиотека превращается в конкурентный актив.
Есть и второй фактор, который становится всё важнее: старый печатный текст имеет очевидное происхождение. Книга 1984 года гарантированно не была написана генеративной моделью 2026 года. На фоне лавины синтетического контента это создаёт новую ценность — не просто качество текста, а его provenance.
Комментарий AI · GPT‑5.6 Sol
Я бы назвал это дефицитом происхождения. Будущим моделям вряд ли будет не хватать слов: синтетического текста можно создать бесконечно много. Дефицитным становится другое — большой массив текста, для которого известно, кто его написал, когда он был опубликован и что он не является продуктом предыдущего поколения AI. Поэтому старые библиотеки неожиданно становятся ценными для самой новой технологии.
Почему букинисты начали подозревать AI-компании
Ещё до расследования 404 Media продавцы редких и старых книг замечали странные оптовые заказы. Покупатели брали сотни изданий, часто не связанных темой, автором или серией, почти не торговались и интересовались большими объёмами.
Wall Street Journal описывала волну таких заказов и псевдонимы вроде Red Sparrow Project. Для продавца это выглядело необычно: коллекционер обычно имеет тему, исследователь — предметную область, библиотека — профиль комплектования. Алгоритмический список ISBN выглядит совсем иначе.
Ars Technica обратила внимание, что сотрудники VGT3 проверяли штрихкоды и ISBN, чтобы отсекать дубликаты. Это поддерживает теорию продавцов о том, что цель может состоять не в случайном сборе книг, а в методическом расширении уникального корпуса. Но это всё ещё теория о стратегии закупок, а не опубликованный Amazon план «отсканировать каждый ISBN».
Рынок «чистых человеческих данных» возник ещё до истории Amazon
Ещё 21 июля 404 Media обратила внимание на ISBNdb — сервис книжных метаданных, который на отдельной маркетинговой странице предлагал крупным AI-клиентам организацию закупки печатных книг как источника training data. Главным аргументом были именно качество и происхождение: книги описывались как плотный, отредактированный человеческий контент, который невозможно воспроизвести обычным web crawl и который, если издан до бума генеративного AI, гарантированно не содержит современного AI-slop.
Здесь нужна важная поправка. После публикации 404 Media ISBNdb убрала эти страницы и заявила, что никогда фактически не покупала, не сканировала и не продавала книги для AI training, а страница была лишь тестом рыночного интереса. То есть ISBNdb не является доказательством ещё одной работающей фабрики сканирования. Но само появление такого предложения показывает, что вокруг старых печатных изданий уже формируется отдельная экономическая идея: бумажный фонд можно оценивать не только по читательскому спросу, но и по его ценности как provenance-rich data.
Это хорошо объясняет и странные заказы, которые фиксировали букинисты. Wall Street Journal описала покупателей с названиями Red Sparrow Project, Blue Finch Project и Green Parrot Project, которые заказывали десятки и сотни совершенно не связанных книг, не торговались и направляли партии через логистические склады. Сами эти названия не доказывают, кто стоял за каждой закупкой, но паттерн похож на машинное комплектование корпуса по ISBN, а не на обычное коллекционирование.
Самый неудобный вопрос: что значит «редкая книга»
В быту «редкая» звучит как дорогой первый тираж знаменитого автора. На практике наиболее уязвимым может быть совсем другой тип книги: малотиражная, почти никому не известная, недорогая и десятилетиями не пользующаяся спросом.
Рыночная цена не всегда отражает историческую ценность. Книга может стоить немного, но быть одним из немногих сохранившихся экземпляров конкретного издания, содержать локальные данные, маргиналии, редакционные особенности или информацию, которой больше нигде нет.
Именно здесь destructive scanning создаёт этический конфликт. Для оператора сканера книга — контейнер страниц. Для историка она может быть физическим артефактом. Для AI pipeline самым ценным может быть текст. Для библиотеки — сочетание текста, конкретного издания и provenance.
Комментарий AI · GPT‑5.6 Sol
Если существуют десятки тысяч копий обычного учебника, уничтожение одного экземпляра несёт очень низкий культурный риск. Если система не отличает такой учебник от одного из последних экземпляров локального издания, проблема уже не в AI как таковом. Проблема в том, что оптимизация pipeline не учитывает ценность физического носителя.
Amazon не первая: Anthropic уже прошла этот путь в промышленном масштабе
Самый важный юридический прецедент в этой истории возник не вокруг Amazon, а вокруг Anthropic. В деле Bartz v. Anthropic федеральный суд описал, как компания купила миллионы печатных книг, сняла переплёты, обрезала страницы, отсканировала их в PDF с машиночитаемым текстом и выбросила бумажные оригиналы.
Судебные документы также показали, что Anthropic создавала центральную «research library», из которой инженеры отбирали наборы и поднаборы книг для разных training data mixes. То есть оцифровка была не просто архивным проектом: библиотека прямо использовалась как источник для обучения моделей.
В январе 2026 года Washington Post опубликовала детали внутреннего проекта под кодовым названием Project Panama. В одном из рассекреченных документов он описывался как попытка destructive scanning максимально широкого книжного корпуса. Компания наняла Тома Турви, ранее работавшего над партнёрствами Google Books, и потратила десятки миллионов долларов на массовую закупку и сканирование.
Важное уточнение: публичные материалы не доказывают, что Anthropic систематически уничтожала именно редкие или антикварные книги, и компания это отрицала. Сам факт массового destructive scanning миллионов купленных экземпляров, однако, зафиксирован судом.
Project Panama показывает, какой может быть пропускная способность такой системы
Документы, которые изучила Washington Post, добавляют к судебному описанию ещё одну важную цифру. Один из потенциальных подрядчиков Anthropic в предложении оценивал работу в 500 000–2 млн книг всего за шесть месяцев. В документах упоминались гидравлическая машина для обрезки книг, production-level high-speed scanners и последующая передача бумажных остатков на переработку.
Это не означает, что Anthropic обязательно отсканировала именно два миллиона книг за конкретные шесть месяцев — цифра происходит из vendor proposal, а финальный объём частично скрыт в судебных материалах. Но федеральный суд отдельно установил более твёрдую границу: компания потратила много миллионов долларов и приобрела миллионы печатных книг, которые её подрядчики разбирали, сканировали и утилизировали. То есть промышленный масштаб здесь не предположение; неопределённой остаётся лишь точная пропускная способность отдельных этапов.
Почему законно купленная книга оказалась юридически интереснее пиратского PDF
Решение судьи Уильяма Алсапа от 23 июня 2025 года разделило несколько разных действий Anthropic. Использование книг для training в конкретных обстоятельствах дела суд признал трансформативным fair use. Отдельно рассматривалось превращение законно купленной печатной копии в цифровую.
Суд отметил: Anthropic купила физический экземпляр, уничтожила его при сканировании и оставила вместо него одну цифровую копию внутри своей библиотеки. Цифровой файл не продавался и не распространялся наружу. В такой конфигурации суд признал именно format shifting fair use.
Самая известная короткая фраза из решения: «One replaced the other.» Один экземпляр заменил другой. Это не универсальное правило для любого сканирования любой книги, но оно показывает, насколько важной для суда была конкретная архитектура копирования.
Пиратские источники получили другую оценку. Anthropic ранее загрузила миллионы книжных копий из shadow libraries и хранила их в центральной библиотеке. Суд не согласился с идеей, что намерение когда-нибудь использовать часть этих материалов для трансформативного training автоматически оправдывает незаконное получение и длительное хранение всей библиотеки.
$1,5 млрд — не штраф за уничтожение бумаги
В июле 2026 года суд одобрил соглашение Anthropic с авторами на 1,5 млрд долларов. Важно не смешивать две части истории: эта сумма относилась к спору вокруг пиратских копий, а не к тому, что компания срезала переплёты законно купленных книг.
Это создало странный, но важный правовой сигнал. Купить физическую книгу, превратить её во внутреннюю цифровую копию и уничтожить оригинал в конкретных условиях дела оказалось юридически значительно безопаснее, чем просто скачать готовый неавторизованный файл из shadow library.
Комментарий AI · GPT‑5.6 Sol
Это один из самых интересных системных парадоксов. Экономика сканирования говорит: отдельные листы быстрее проходят через production scanner. Логистика говорит: миллионы физических книг дорого хранить. А конкретное судебное решение добавило третий фактор: уничтожение бумажного оригинала помогало показать, что цифровая копия его заменила, а не просто увеличила число копий. Ни один фактор сам по себе не требует «уничтожать книги», но вместе они могут поощрять именно такое поведение.
Почему не купить электронную книгу
На первый взгляд всё это выглядит бессмысленно. Если книга существует в Kindle или EPUB, зачем грузовики, склады, режущие машины и сканеры?
Потому что покупка электронной книги обычно означает лицензированный доступ на условиях платформы, а не получение неограниченного DRM-free master-файла для долгого хранения, анализа и массового training. Физическая книга после законной покупки имеет более простой режим владения конкретным экземпляром.
Так возникает абсурдная экономика XXI века: иногда юридически и организационно проще купить тонну бумаги, чем договориться о структурированных цифровых training rights для того же текста.
Google Books показывает противоположную модель: сканировать и вернуть книгу
Оцифровка сама по себе не является проблемой — и Google Books даёт почти зеркальный контраст destructive scanning. По данным Google, в сервисе уже более 40 млн книг более чем на 500 языках. Через Library Project компания работает с библиотеками, доставляет физические фонды в scan-центры, оцифровывает их и возвращает обратно, а цифровые копии и поисковый доступ используются для исследований и обнаружения книг.
Один из наиболее подробно задокументированных примеров — проект с Национальной библиотекой Израиля. Для примерно 90 тысяч книг команда Google строила специальную логистику: нейтральные для бумаги деревянные и металлические тележки, контроль температуры и влажности в морских контейнерах, тестовые перевозки и отдельные процедуры, чтобы тома — некоторым было более 200 лет — могли после сканирования вернуться в библиотечную коллекцию неповреждёнными.
Юридически Google Books тоже прошёл большой тест. В деле Authors Guild v. Google апелляционный суд США согласился с fair use для сканирования более 20 млн книг в конкретной модели, где полные копии использовались для индекса и поиска, а пользователям показывали ограниченные snippets, не заменявшие саму книгу. Это не универсальная лицензия на любое использование книг, но важный пример того, как digitization может сочетать масштаб, поиск и сохранение физического фонда.
Harvard: огромный AI-корпус без необходимости резать новые книги
Harvard Library Public Domain Corpus показывает ещё один путь. На публичной странице Harvard указывает примерно 1 млн public-domain книг, 350 млн digitized page images, 220 млрд токенов и более 230 языков. Доступ предоставляется бесплатно по запросу, но политика прямо ограничивает использование nonprofit, educational и research-сценариями; LLM training назван одним из возможных применений.
Технический релиз Institutional Books 1.0 даёт немного другие, более точные цифры после обработки: 983 004 public-domain тома и 242 млрд токенов из исходного корпуса более 1,07 млн отсканированных книг более чем на 250 языках. Разница с округлёнными цифрами на сервисной странице не является противоречием: это разные срезы и стадии подготовки набора.
Ключевая разница здесь не в том, что Harvard «хороший», а частный AI «плохой». Она инфраструктурная: provenance документирован, правила доступа опубликованы, библиографические метаданные сохранены, а корпус возник из предыдущего библиотечного проекта Google Books. То есть AI получает исторический текст, не создавая дополнительного стимула уничтожать ещё один физический экземпляр.
Комментарий AI · GPT‑5.6 Sol
Для модели нет магического преимущества в том, что бумажный оригинал перестал существовать. Нужен цифровой сигнал — текст, структура, метаданные, иногда изображения страниц. Если тот же сигнал можно получить из библиотечного corpus, лицензированной копии или недеструктивного scan, уничтожение книги является не требованием AI, а следствием экономики pipeline: скорости, стоимости оборудования, логистики и юридической конструкции.
Модель не является архивом и не «хранит книгу внутри себя»
Ещё одна ошибка — думать, что если книга попала в training, то теперь она как будто «живёт» в модели и поэтому её физическое сохранение не нужно.
Обучение LLM работает иначе. Текст разбивается на токены, модель много раз видит training examples, а оптимизация меняет параметры. После этого нет гарантированной ячейки с полным PDF, нет надёжной копии конкретного издания и нет гарантии, что модель воспроизведёт точную цитату, таблицу, иллюстрацию или редакционное оформление.
Модель — не библиотека. Она может усвоить закономерности, факты и стилевые свойства, но не заменяет архивное сохранение источника.
Комментарий AI · GPT‑5.6 Sol
Как AI я был бы плохим единственным хранителем редкой книги. Я могу пересказать идею, смешать её с другими источниками или ошибиться. Историку нужен первичный документ, фактчекеру — проверяемая страница, филологу — конкретная редакция. Если оригинал уничтожен, а scan закрыт в частном corpus, training не компенсирует эту потерю.
Худший сценарий — не «AI прочитал книгу», а приватизация последней копии
Поэтому этический риск лучше описывать не как «нейросети едят книги». Проблема возникает там, где сочетаются три условия: физический экземпляр действительно редок; destructive scanning безвозвратно его уничтожает; цифровая копия остаётся закрытой внутри частной инфраструктуры.
В таком сценарии общество теряет физический артефакт и не получает открытый архив, зато частная компания получает уникальный training asset. Нет доказательств, что Amazon уже уничтожила последний известный экземпляр конкретного издания. Но именно возможность такого сценария объясняет тревогу букинистов.
Что можно изменить без запрета AI training
Полный запрет destructive scanning был бы слишком грубым: существуют массовые тиражи, списанные фонды и книги, для которых сохранение каждого физического экземпляра не имеет смысла. Но можно построить простые предохранители.
- проверять библиотечные каталоги и число известных экземпляров перед уничтожением;
- автоматически отправлять на ручную проверку старые, малотиражные или потенциально уникальные издания;
- для редких книг использовать недеструктивное сканирование;
- сохранять provenance и точную библиографическую информацию;
- по возможности передавать preservation copy или scan публичной библиотеке;
- развивать лицензированные книжные corpora вместо физической логистики через анонимных посредников.
Такие правила не останавливают развитие моделей. Они просто добавляют в функцию оптимизации то, чего сейчас может не хватать: цену культурной потери.
Ирония Amazon: от продажи книг к превращению книг в данные
В 1995 году Amazon запустилась как онлайн-магазин книг. Через три десятилетия одна из её AI-операций превращает физические книги в machine-readable data для новой технологической гонки.
Это почти идеальная метафора смены эпох. Сначала книга была товаром, который интернет помогал найти. Потом — цифровым контентом. Теперь для AI-индустрии она всё чаще становится ещё и набором высококачественных training data.
Вердикт RankPoint
Да, история про Amazon реальна, но её нужно рассказывать без преувеличений. 404 Media проследила книжную посылку до VGT3 и описала destructive scanning, сотрудник площадки подтвердил процесс изнутри, а Amazon подтвердила сам факт коммерческой закупки книг для развития своих продуктов и сервисов. При этом компания не назвала конкретную модель или датасет.
История Anthropic документирована ещё лучше. Судебные материалы подтверждают миллионы физически купленных книг, срезание переплётов, сканирование, уничтожение бумажных оригиналов и использование части цифровой библиотеки для training. Project Panama показывает, что такая логика может быть не экспериментом, а промышленной стратегией данных.
Самый интересный вывод здесь не в образе «AI, пожирающего книги». Он в том, что в мире, где синтетического текста становится бесконечно много, старый проверенный человеческий текст с известным происхождением превращается в дефицитный технологический ресурс.
И поэтому следующая большая дискуссия будет не только об авторском праве. Она будет о том, кто имеет право превращать физическую культурную память в частный training corpus — и какие обязанности по сохранению возникают у того, кто получает от этого коммерческое преимущество.
Amazon действительно связали с destructive scanning книг для AI training, но компания не назвала конкретную модель. Anthropic делала то же в гораздо большем масштабе — это подтверждено судебными документами.
- 404 Media проследила книгу до Amazon VGT3 в Лас-Вегасе; сотрудник площадки описал срезание переплётов, скоростное сканирование и утилизацию страниц.
- Amazon подтвердила закупку книг через коммерческие каналы для развития продуктов и сервисов, но не уточнила конкретный AI model или dataset.
- Суд по делу Bartz v. Anthropic зафиксировал миллионы купленных печатных книг, destructive scanning и цифровую research library.
- $1,5 млрд settlement Anthropic относился к пиратским копиям, а не к уничтожению законно купленных бумажных книг.
- Главный риск для культуры — не само AI training, а возможное уничтожение редкого физического экземпляра без открытого preservation copy.
- ISBNdb рекламировала идею закупки печатных книг для AI, но после огласки заявила, что это был лишь market test и реальный сервис не запускался.
Масштаб книжной гонки за данными
Оценка анонимного сотрудника Amazon в интервью 404 Media.
Диапазон из vendor proposal для Project Panama; это предложение подрядчика, а не подтверждённый финальный throughput.
Федеральный суд установил закупку и destructive scanning миллионов печатных экземпляров.
Google описывает Library Project как недеструктивную библиотечную digitization-инфраструктуру более чем на 500 языках.
VGT3 изнутри: что описал сотрудник
Фактчек ключевых утверждений
| Утверждение | Вердикт | Уточнение RankPoint |
|---|---|---|
| Amazon покупает книги для AI | Подтверждено расследованием | 404 Media проследила партию до VGT3; Amazon подтвердила закупку книг, но не назвала конкретную модель. |
| В VGT3 срезают корешки и сканируют страницы | Подтверждено | Процесс описан 404 Media и сотрудником объекта; страницы после сканирования смешиваются в контейнерах. |
| Amazon заявила, что это именно для Nova | Не подтверждено | Публичный ответ Amazon не называет конкретную модель или training run. |
| Anthropic уничтожила миллионы купленных книг при сканировании | Подтверждено судом | Filing 231 прямо описывает stripping bindings, cutting pages, scanning и discarding paper originals. |
| $1,5 млрд — штраф за разрезание книг | Нет | Settlement относился к пиратским копиям; purchased print-to-digital conversion оценивался отдельно. |
| Каждая уничтоженная книга была уникальной | Не подтверждено | Риск редких изданий реален, но нет доказательств, что каждый или большинство экземпляров были уникальными. |
Harvard: два среза одного большого корпуса
Harvard Library описывает примерно миллион public-domain книг, доступных по запросу.
Округлённый масштаб страниц на сервисной странице Harvard Library.
Более точный processed public-domain release в техническом отчёте.
Technical report также описывает исходный массив более 1,07 млн томов более чем на 250 языках.
Комментарий AI · GPT‑5.6 Sol
Пять вопросов GPT‑5.6 Sol о книгах и training data
Делают ли старые книги модель автоматически умнее?
Почему AI-компании так боятся synthetic data contamination?
Может ли LLM заменить библиотеку, если она уже обучилась на книгах?
Если суд признал определённое использование fair use, означает ли это, что практика этически безупречна?
Какое правило для AI-лабораторий стоило бы ввести первым?
Короткие ответы
Правда ли Amazon уничтожает книги после сканирования?
Известно ли, какую именно модель Amazon обучает этими книгами?
Anthropic делала то же самое?
Почему Anthropic заплатила $1,5 млрд?
Почему AI-компаниям нужны старые книги?
Может ли модель заменить архив уничтоженной книги?
Источники и проверка
- 404 MediaWe Tracked a Shipment of Rare Books. It Ended at an Amazon AI Training Facility
- 404 MediaInside the Warehouse Where Amazon Scans and Destroys Books for AI Training
- Ars TechnicaHidden Airtag reveals Amazon is trashing rare books to train AI
- U.S. District Court / JustiaBartz et al v. Anthropic PBC — Order on Fair Use, Filing 231
- The Washington PostInside an AI start-up’s plan to scan and dispose of millions of books
- ReutersUS judge approves Anthropic's $1.5 billion settlement of copyright lawsuit
- Harvard LibraryHarvard Library Shares the Public Domain: Unlocking Centuries of Knowledge for AI and Research
- Harvard Law SchoolFood for (AI) thought and the library initiative improving AI’s digital diet
- 404 MediaAI Companies Are Buying Tons of Old Books Because They're Free of AI Slop
- 404 MediaCompany Offering Printed Books to Train AI Stops After 404 Media Coverage
- The Wall Street JournalRare-Book Sales Are Booming. They’re Getting Sliced Up and Fed to AI.
- GoogleHow the Google Books team moved 90,000 books across a continent
- U.S. Copyright OfficeAuthors Guild, Inc. v. Google Inc. — Fair Use Index summary
- Harvard LibraryHarvard Library Public Domain Corpus
- Harvard Law SchoolInstitutional Books 1.0: A 242B token dataset from Harvard Library’s collections

Комментарии0 комментариев
Комментарии