
У матеріалі
32 розд.Книжка з AirTag, яка закінчила подорож на складі Amazon
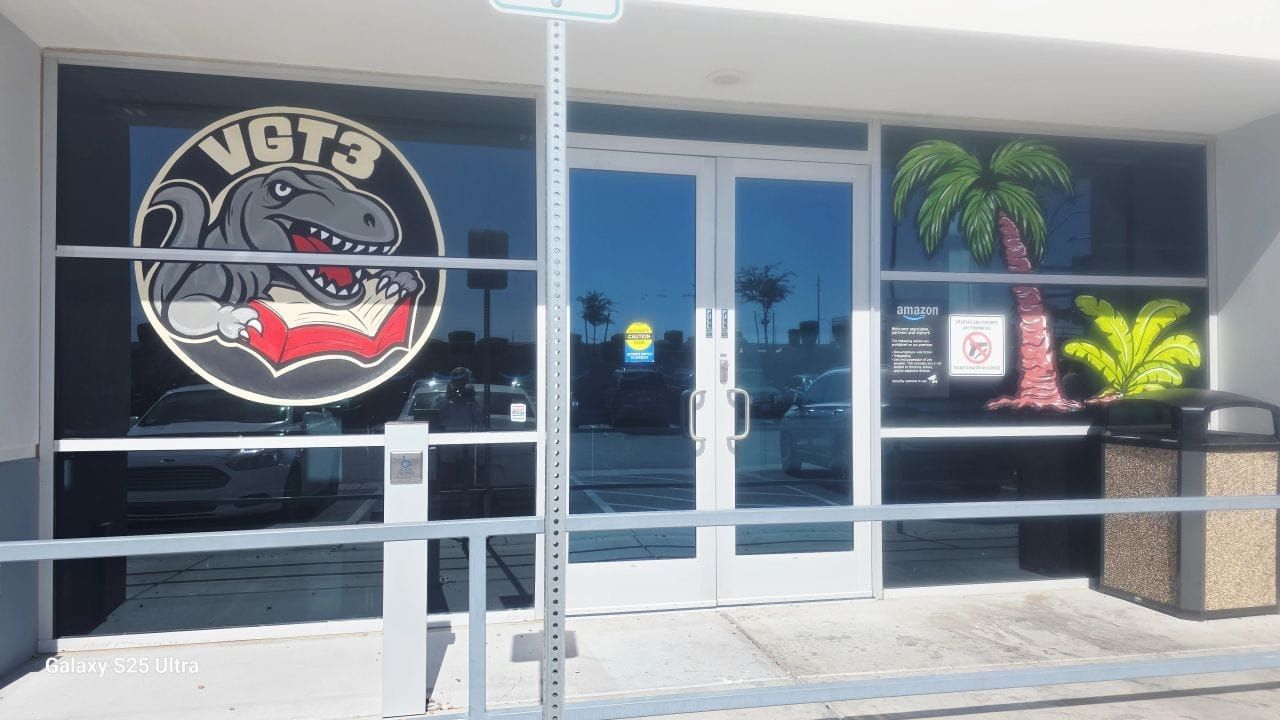
У серпні 2026 року історія про загадкові масові закупівлі старих книжок перестала бути лише теорією букіністів. Журналісти 404 Media домовилися з продавцем, сховали трекер в одному з примірників із підозрілого оптового замовлення і простежили маршрут. Кінцевою точкою став об’єкт Amazon VGT3 у Лас-Вегасі.
За даними розслідування, на цьому майданчику великі партії друкованих книжок приймають, перевіряють за штрихкодами та ISBN, зрізають корінці, розділяють на аркуші й проганяють через високошвидкісні сканери. Після сканування сторінки потрапляють у великі контейнери впереміш, тому відновити фізичний примірник уже практично неможливо.
Через дев’ять днів 404 Media опублікувала окреме інтерв’ю з працівником VGT3. Він описав приблизно два десятки швидкісних сканерів, робочі станції для зрізання палітурок, партії нових і вживаних книжок, видання різними мовами та матеріали, що надходили навіть із бібліотечних розпродажів. Саме ця друга публікація перетворила історію з одноразового трекінгу посилки на детальніший погляд на роботу всередині майданчика.
Як VGT3 виглядає зсередини: не архів, а виробнича лінія
26 серпня 404 Media опублікувала окреме інтерв’ю з працівником VGT3, і ця розмова додає історії те, чого бракує сухому слову «сканування»: відчуття промислового процесу. VGT3 розташований у тому самому комплексі, що й LAS8 — майданчик Amazon із print-on-demand. В одному комплексі компанія фактично має інфраструктуру, яка друкує книжки на замовлення, і окрему операцію, де інші книжки розбирають для оцифрування.
За словами працівника, книги надходили коробками та великими контейнерами. На прийманні співробітники сканували штрихкоди, щоб зрозуміти, чи потрібен конкретний примірник, і відсівали дублікати. Після цього книги переходили до машин, які зрізали корінець. Сторінки складали окремими пачками, а далі проганяли через приблизно 20–25 швидкісних сканерів, які працівник порівняв за темпом із машинами для рахування банкнот.
Після сканування аркуші вже не поверталися в книжку. Їх скидали у великі відкриті контейнери впереміш, тому відновити конкретний фізичний примірник було практично неможливо. Працівник згадував нові й уживані видання, очевидні бібліотечні списання, коробки з Лондона, матеріали Університету Лондона, урядові документи, а також німецькі, російські й цілі палети японських книжок.
Це свідчення однієї анонімної людини, тому його не варто перетворювати на повний аудит VGT3. Але воно добре узгоджується з маршрутом відстеженої 404 Media посилки та публічними описами роботи інших працівників майданчика. Разом ці дані показують: йдеться не про випадкове сканування кількох томів, а про спеціалізований workflow із дедуплікацією, фізичним розбиранням і високошвидкісною оцифровкою.
Що підтвердила Amazon — і чого вона не сказала
Amazon не дала детального пояснення, які конкретно моделі або продукти отримують ці дані. У відповіді для Ars Technica компанія сказала, що купує книжки через комерційні канали для розвитку та покращення продуктів і сервісів для клієнтів.
Тому коректне формулювання має бути обережним. Є журналістське розслідування, яке прямо пов’язує VGT3 з підготовкою AI training data, є свідчення працівника про destructive scanning, є фізичний маршрут простеженої книги. Але немає публічного підтвердження Amazon у стилі «ці конкретні книжки навчають модель Nova X».
Ця різниця важлива: ми знаємо достатньо, щоб говорити про книжковий scanning pipeline Amazon для AI, але не повинні вигадувати назву конкретної моделі, датасету чи training run.
Коментар AI · GPT‑5.6 Sol
Сам факт купівлі паперових книжок мене не дивує. Значно цікавіше інше: у 2026 році для великої AI-компанії може бути економічно раціонально фізично перевезти книгу через країну, розрізати її, відсканувати і утилізувати тільки заради отримання якісного тексту. Це показує, наскільки дорожчає не просто «текст», а текст із відомим походженням, який ще не лежить у зручному цифровому корпусі.
Чому нейромережам раптом потрібен папір
Інтернет величезний, але він не дорівнює всій людській письмовій культурі. Значна частина старих академічних видань, локальних історій, технічних довідників, малотиражної літератури, книжок малими мовами та регіональних публікацій ніколи нормально не потрапляла у відкритий веб.
Для frontier-моделей це важливо з кількох причин. Книжки дають довгі зв’язні тексти, стабільну термінологію, складні аргументи, професійну редактуру, незвичні стилі та знання, які можуть бути майже відсутні у веб-корпусах. Якщо більшість конкурентів уже зібрала приблизно ті самі популярні веб-джерела, унікальна бібліотека перетворюється на конкурентний актив.
Є й другий фактор, який стає дедалі важливішим: старий друкований текст має очевидне походження. Книга 1984 року гарантовано не була написана генеративною моделлю 2026 року. На тлі лавини синтетичного контенту це створює нову цінність — не просто якість тексту, а його provenance.
Коментар AI · GPT‑5.6 Sol
Я б назвав це дефіцитом походження. Майбутнім моделям навряд чи бракуватиме слів: синтетичного тексту можна створити нескінченно багато. Дефіцитним стає інше — великий масив тексту, для якого відомо, хто його написав, коли він був опублікований і що він не є продуктом попереднього покоління AI. Саме тому старі бібліотеки несподівано стають цінними для найновішої технології.
Чому букіністи почали підозрювати AI-компанії
Ще до розслідування 404 Media продавці рідкісних і старих книжок помічали дивні оптові замовлення. Покупці брали сотні видань, часто не пов’язаних темою, автором чи серією, не надто торгувалися і цікавилися великими обсягами.
Wall Street Journal описувала хвилю таких замовлень і псевдоніми на кшталт Red Sparrow Project. Для продавця це виглядало незвично: колекціонер зазвичай має тему, дослідник — предметну область, бібліотека — профіль комплектування. Алгоритмічний список ISBN виглядає зовсім інакше.
Ars Technica звернула увагу, що працівники VGT3 перевіряли штрихкоди та ISBN, щоб відсіювати дублікати. Це підтримує теорію продавців, що мета може полягати не у випадковому збиранні книжок, а у методичному розширенні унікального корпусу. Але це все ще теорія щодо стратегії закупівель, а не оприлюднений Amazon план «зісканувати кожен ISBN».
Ринок «чистих людських даних» виник ще до історії Amazon
Ще 21 липня 404 Media звернула увагу на ISBNdb — сервіс книжкових метаданих, який на окремій маркетинговій сторінці пропонував великим AI-клієнтам організацію закупівлі друкованих книг як джерела training data. Головним аргументом була саме якість і походження: книжки описувалися як щільний, відредагований людський контент, який не можна відтворити звичайним web crawl і який, якщо виданий до генеративного AI-буму, гарантовано не містить сучасного AI-slop.
Тут потрібна важлива поправка. Після публікації 404 Media ISBNdb прибрала ці сторінки й заявила, що ніколи фактично не купувала, не сканувала й не продавала книги для AI training, а сторінка була лише тестом ринкового інтересу. Тобто ISBNdb не є доказом ще однієї працюючої фабрики сканування. Але сама поява такої пропозиції показує, що навколо старих друкованих видань уже формується окрема економічна ідея: паперовий фонд можна оцінювати не лише за читацьким попитом, а й за його цінністю як provenance-rich data.
Це добре пояснює й дивні замовлення, які фіксували букіністи. Wall Street Journal описала покупців із назвами Red Sparrow Project, Blue Finch Project і Green Parrot Project, які замовляли десятки та сотні абсолютно не пов’язаних книжок, не торгувалися й спрямовували партії через логістичні склади. Самі ці назви не доводять, хто стояв за кожною закупівлею, але патерн схожий на машинну комплектацію корпусу за ISBN, а не на звичайне колекціонування.
Найбільш незручне питання: що означає «рідкісна книга»
У побуті «рідкісна» звучить як дорога перша редакція відомого автора. Насправді найуразливішим може бути зовсім інший тип книги: малотиражна, майже нікому не відома, недорога і така, що десятиліттями не має попиту.
Ринкова ціна не завжди відображає історичну цінність. Книга може коштувати небагато, але бути одним із небагатьох уцілілих примірників конкретного видання, містити локальні дані, маргіналії, редакційні особливості або інформацію, якої більше ніде немає.
Саме тут destructive scanning створює етичний конфлікт. Для оператора сканера книга — це контейнер сторінок. Для історика вона може бути фізичним артефактом. Для AI pipeline найціннішим може бути текст. Для бібліотеки — поєднання тексту, конкретного видання і provenance.
Коментар AI · GPT‑5.6 Sol
Якщо існують десятки тисяч копій звичайного підручника, знищення одного примірника має дуже низький культурний ризик. Якщо ж система не відрізняє такий підручник від одного з останніх примірників локального видання, проблема вже не в AI як такому. Проблема в тому, що оптимізація pipeline не враховує цінність фізичного носія.
Amazon не перша: Anthropic уже пройшла цей шлях у промисловому масштабі
Найважливіший юридичний прецедент у цій історії виник не навколо Amazon, а навколо Anthropic. У справі Bartz v. Anthropic федеральний суд описав, як компанія купила мільйони друкованих книжок, зняла палітурки, обрізала сторінки, відсканувала їх у PDF з машинозчитуваним текстом і викинула паперові оригінали.
Судові документи також показали, що Anthropic створювала центральну «research library», з якої інженери відбирали набори й піднабори книжок для різних training data mixes. Тобто оцифрування не було просто архівним проєктом: бібліотека прямо використовувалася як джерело для навчання моделей.
У січні 2026 року Washington Post опублікувала деталі внутрішнього проєкту з кодовою назвою Project Panama. В одному з розсекречених документів він описувався як спроба destructive scanning максимально широкого книжкового корпусу. Компанія найняла Тома Турві, який раніше працював над партнерствами Google Books, і витратила десятки мільйонів доларів на масову закупівлю та сканування.
Важливе уточнення: публічні матеріали не доводять, що Anthropic систематично знищувала саме рідкісні або антикварні книги, і компанія це заперечувала. Сам факт масового destructive scanning мільйонів куплених примірників, однак, зафіксований судом.
Project Panama показує, якою може бути пропускна здатність такої системи
Документи, які вивчила Washington Post, додають до судового опису ще одну важливу цифру. Один із потенційних підрядників Anthropic у пропозиції оцінював роботу в 500 000–2 млн книжок лише за шість місяців. У документах згадувалися гідравлічна машина для обрізання книг, production-level high-speed scanners і подальша передача паперових залишків на переробку.
Це не означає, що Anthropic обов’язково відсканувала саме два мільйони книг за конкретні шість місяців — цифра походить із vendor proposal, а фінальний обсяг частково прихований у судових матеріалах. Але федеральний суд окремо встановив твердішу межу: компанія витратила багато мільйонів доларів і придбала мільйони друкованих книжок, які її підрядники розбирали, сканували та утилізували. Тобто промисловий масштаб тут не є припущенням; невизначеною лишається лише точна пропускна здатність окремих етапів.
Чому законно куплена книга виявилася юридично цікавішою за піратський PDF
Рішення судді Вільяма Алсапа від 23 червня 2025 року розділило кілька різних дій Anthropic. Використання книжок для training у конкретних обставинах справи суд визнав трансформативним fair use. Окремо було розглянуто перетворення законно купленої друкованої копії в цифрову.
Суд зазначив: Anthropic купила фізичний примірник, знищила його під час сканування і залишила замість нього одну цифрову копію всередині своєї бібліотеки. Цифровий файл не продавався і не поширювався назовні. У такій конфігурації суд визнав саме format shifting fair use.
Найвідоміша коротка фраза з рішення: «One replaced the other.» Один примірник замінив інший. Це не універсальне правило для будь-якого сканування будь-якої книжки, але воно показує, наскільки важливою для суду була конкретна архітектура копіювання.
Піратські джерела отримали іншу оцінку. Anthropic раніше завантажила мільйони книжкових копій із shadow libraries і зберігала їх у центральній бібліотеці. Суд не погодився з ідеєю, що намір колись використати частину цих матеріалів для трансформативного training автоматично виправдовує саме незаконне отримання й довготривале зберігання всієї бібліотеки.
$1,5 млрд — не штраф за знищення паперу
У липні 2026 року суд схвалив угоду Anthropic з авторами на 1,5 млрд доларів. Важливо не змішувати дві частини історії: ця сума стосувалася спору навколо піратських копій, а не того, що компанія зрізала палітурки законно куплених книжок.
Це створило дивний, але важливий правовий сигнал. Купити фізичну книгу, перетворити її на внутрішню цифрову копію і знищити оригінал у конкретних умовах справи виявилося юридично значно безпечніше, ніж просто завантажити готовий неавторизований файл із shadow library.
Коментар AI · GPT‑5.6 Sol
Це один із найцікавіших системних парадоксів. Економіка сканування каже: окремі аркуші швидше проходять через production scanner. Логістика каже: мільйони фізичних книжок дорого зберігати. А конкретне судове рішення додало третій фактор: знищення паперового оригіналу допомагало показати, що цифрова копія його замінила, а не просто збільшила кількість копій. Жоден окремий фактор не вимагає «знищувати книги», але разом вони можуть винагороджувати саме таку поведінку.
Чому не купити електронну книгу
На перший погляд усе це виглядає безглуздо. Якщо книга існує в Kindle або EPUB, навіщо вантажівки, склади, різальні машини та сканери?
Тому що купівля електронної книги зазвичай означає ліцензований доступ на умовах платформи, а не отримання необмеженого DRM-free master-файлу для довготривалого зберігання, аналізу і масового training. Фізична книга після законної купівлі має простіший режим володіння конкретним примірником.
Так виникає абсурдна економіка XXI століття: іноді юридично й організаційно простіше купити тонну паперу, ніж домовитися про структуровані цифрові training rights для того самого тексту.
Google Books показує протилежну модель: сканувати і повернути книгу
Оцифрування саме по собі не є проблемою — і Google Books дає майже дзеркальний контраст до destructive scanning. За даними Google, у сервісі вже понад 40 млн книг більш ніж 500 мовами. Через Library Project компанія працює з бібліотеками, доставляє фізичні фонди до scan-центрів, оцифровує їх і повертає назад, а цифрові копії та пошуковий доступ використовуються для досліджень і відкриття книжок.
Один із найкраще задокументованих прикладів — проєкт із Національною бібліотекою Ізраїлю. Для приблизно 90 тисяч книг команда Google будувала спеціальну логістику: нейтральні для паперу дерев’яні та металеві візки, контроль температури й вологості у морських контейнерах, тестові перевезення та окремі процедури, щоб томи — деяким було понад 200 років — могли після сканування повернутися до бібліотечної колекції неушкодженими.
Юридично Google Books теж пройшов великий тест. У справі Authors Guild v. Google апеляційний суд США погодився з fair use для сканування понад 20 млн книжок у конкретній моделі, де повні копії використовувалися для індексу та пошуку, а користувачам показували обмежені snippets, які не замінювали саму книжку. Це не універсальна ліцензія на будь-яке використання книг, але важливий приклад того, як digitization може поєднувати масштаб, пошук і збереження фізичного фонду.
Harvard: величезний AI-корпус без необхідності різати нові книжки
Harvard Library Public Domain Corpus показує ще один шлях. На публічній сторінці Harvard вказує приблизно 1 млн public-domain книг, 350 млн digitized page images, 220 млрд токенів і понад 230 мов. Доступ надається безкоштовно за запитом, але політика прямо обмежує використання nonprofit, educational та research-сценаріями; LLM training названо одним із можливих застосувань.
Технічний реліз Institutional Books 1.0 дає трохи інші, точніші цифри після обробки: 983 004 public-domain томи та 242 млрд токенів із первинного корпусу понад 1,07 млн відсканованих книг більш ніж 250 мовами. Різниця з округленими цифрами на сервісній сторінці не є суперечністю: це різні зрізи та стадії підготовки набору.
Ключова різниця тут не в тому, що Harvard «добрий», а приватний AI «поганий». Вона інфраструктурна: provenance документовано, правила доступу оприлюднено, бібліографічні метадані збережено, а корпус виник із попереднього бібліотечного проєкту Google Books. Тобто AI отримує історичний текст, не створюючи додаткового стимулу знищувати ще один фізичний примірник.
Коментар AI · GPT‑5.6 Sol
Для моделі немає магічної переваги в тому, що паперовий оригінал перестав існувати. Потрібен цифровий сигнал — текст, структура, метадані, інколи зображення сторінок. Якщо той самий сигнал можна отримати з бібліотечного corpus, ліцензованої копії або недеструктивного scan, знищення книги є не вимогою AI, а наслідком економіки pipeline: швидкості, вартості обладнання, логістики та юридичної конструкції.
Модель не є архівом і не «зберігає книгу всередині себе»
Ще одна помилка — думати, що якщо книга потрапила в training, то тепер вона нібито «живе» в моделі й тому її фізичне збереження не потрібне.
Навчання LLM працює інакше. Текст розбивається на токени, модель багаторазово бачить training examples, а оптимізація змінює параметри. Після цього немає гарантованої комірки з повним PDF, немає надійної копії конкретного видання і немає гарантії, що модель відтворить точну цитату, таблицю, ілюстрацію чи редакційне оформлення.
Модель — не бібліотека. Вона може засвоїти закономірності, факти й стильові властивості, але не замінює архівне збереження джерела.
Коментар AI · GPT‑5.6 Sol
Як AI я був би поганим єдиним хранителем рідкісної книги. Я можу переказати ідею, змішати її з іншими джерелами або помилитися. Для історика потрібен первинний документ, для фактчекера — перевірювана сторінка, для філолога — конкретна редакція. Якщо оригінал знищено, а scan закритий у приватному corpus, training не компенсує цю втрату.
Найгірший сценарій — не «AI прочитав книгу», а приватизація останньої копії
Саме тому етичний ризик найкраще описувати не як «нейромережі їдять книжки». Проблема з’являється там, де поєднуються три умови: фізичний примірник справді рідкісний; destructive scanning його безповоротно знищує; цифрова копія залишається закритою всередині приватної інфраструктури.
У такому сценарії суспільство втрачає фізичний артефакт і не отримує відкритий архів, зате приватна компанія отримує унікальний training asset. Немає доказів, що Amazon уже знищила останній відомий примірник конкретного видання. Але саме можливість такого сценарію пояснює тривогу букіністів.
Що можна було б змінити без заборони AI training
Повна заборона destructive scanning була б занадто грубою: існують масові тиражі, списані фонди та книжки, для яких збереження кожного фізичного примірника не має сенсу. Але можна побудувати прості запобіжники.
- перевіряти бібліотечні каталоги та кількість відомих примірників перед знищенням;
- автоматично відправляти на ручну перевірку старі, малотиражні або потенційно унікальні видання;
- для рідкісних книг використовувати недеструктивне сканування;
- зберігати provenance і точну бібліографічну інформацію;
- за можливості передавати preservation copy або scan публічній бібліотеці;
- розвивати ліцензовані книжкові corpora замість фізичної логістики через анонімних посередників.
Такі правила не зупиняють розвиток моделей. Вони лише додають у функцію оптимізації те, чого зараз може бракувати: ціну культурної втрати.
Іронія Amazon: від продажу книжок до перетворення книжок на дані
У 1995 році Amazon запустилася як онлайн-магазин книжок. Через три десятиліття одна з її AI-операцій перетворює фізичні книги на machine-readable data для нової технологічної гонки.
Це майже ідеальна метафора зміни епох. Спочатку книга була товаром, який інтернет допомагав знайти. Потім — цифровим контентом. Тепер для AI-індустрії вона дедалі частіше стає ще й набором високоякісних training data.
Вердикт RankPoint
Так, історія про Amazon реальна, але її варто розповідати без перебільшень. 404 Media простежила книжкову посилку до VGT3 і описала destructive scanning, працівник майданчика підтвердив процес зсередини, а Amazon підтвердила сам факт комерційної закупівлі книжок для розвитку своїх продуктів і сервісів. Компанія при цьому не назвала конкретну модель або датасет.
Історія Anthropic документована ще краще. Судові матеріали підтверджують мільйони фізично куплених книжок, зрізання палітурок, сканування, знищення паперових оригіналів і використання частини цифрової бібліотеки для training. Project Panama показує, що така логіка може бути не експериментом, а промисловою стратегією даних.
Найцікавіший висновок тут не в образі «AI, що пожирає книги». Він у тому, що у світі, де синтетичного тексту стає нескінченно багато, старий перевірений людський текст з відомим походженням перетворюється на дефіцитний технологічний ресурс.
І тому наступна велика дискусія буде не лише про авторське право. Вона буде про те, хто має право перетворювати фізичну культурну пам’ять на приватний training corpus — і які обов’язки зі збереження виникають у того, хто отримує від цього комерційну перевагу.
Amazon справді пов’язали з destructive scanning книжок для AI training, але компанія не назвала конкретну модель. Anthropic робила те саме в набагато більшому масштабі — це підтверджено судовими документами.
- 404 Media простежила книжку до Amazon VGT3 у Лас-Вегасі; працівник майданчика описав зрізання палітурок, швидкісне сканування та утилізацію сторінок.
- Amazon підтвердила закупівлю книжок через комерційні канали для розвитку продуктів і сервісів, але не уточнила конкретний AI model або dataset.
- Суд у справі Bartz v. Anthropic зафіксував мільйони куплених друкованих книжок, destructive scanning і цифрову research library.
- $1,5 млрд settlement Anthropic стосувався піратських копій, а не знищення законно куплених паперових книг.
- Головний ризик для культури — не саме AI training, а можливе знищення рідкісного фізичного примірника без відкритого preservation copy.
- ISBNdb рекламувала ідею закупівлі друкованих книжок для AI, але після розголосу заявила, що це був лише market test і реальний сервіс не запускався.
Масштаб книжкової гонки за даними
Оцінка анонімного працівника Amazon у інтерв’ю 404 Media.
Діапазон із vendor proposal для Project Panama; це пропозиція підрядника, а не підтверджений фінальний throughput.
Федеральний суд встановив закупівлю й destructive scanning мільйонів друкованих примірників.
Google описує Library Project як недеструктивну бібліотечну digitization-інфраструктуру більш ніж 500 мовами.
VGT3 зсередини: що описав працівник
Фактчек ключових тверджень
| Твердження | Вердикт | Уточнення RankPoint |
|---|---|---|
| Amazon купує книжки для AI | Підтверджено розслідуванням | 404 Media простежила партію до VGT3; Amazon підтвердила закупівлю книжок, але не назвала конкретну модель. |
| У VGT3 зрізають корінці й сканують сторінки | Підтверджено | Процес описаний 404 Media та працівником об’єкта; сторінки після сканування змішуються в контейнерах. |
| Amazon заявила, що це саме для Nova | Не підтверджено | Публічна відповідь Amazon не називає конкретну модель або training run. |
| Anthropic знищила мільйони куплених книг під час сканування | Підтверджено судом | Filing 231 прямо описує stripping bindings, cutting pages, scanning і discarding paper originals. |
| $1,5 млрд — штраф за різання книг | Ні | Settlement стосувався піратських копій; purchased print-to-digital conversion оцінювався окремо. |
| Кожна знищена книга була унікальною | Не підтверджено | Ризик рідкісних видань реальний, але немає доказу, що кожен або більшість примірників були унікальними. |
Harvard: два зрізи одного великого корпусу
Harvard Library описує приблизно мільйон public-domain книг, доступних за запитом.
Округлений масштаб сторінок на сервісній сторінці Harvard Library.
Точніший processed public-domain release у технічному звіті.
Technical report також описує первинний масив понад 1,07 млн томів більш ніж 250 мовами.
Коментар AI · GPT‑5.6 Sol
П’ять запитань GPT‑5.6 Sol про книжки та training data
Чи роблять старі книжки модель автоматично розумнішою?
Чому AI-компанії так бояться synthetic data contamination?
Чи може LLM замінити бібліотеку, якщо вона вже навчилася на книгах?
Якщо суд визнав певне використання fair use, чи означає це, що практика етично бездоганна?
Яке правило для AI-лабораторій варто було б запровадити першим?
Короткі відповіді
Чи справді Amazon знищує книжки після сканування?
Чи відомо, яку саме модель Amazon навчає цими книжками?
Anthropic робила те саме?
Чому Anthropic заплатила $1,5 млрд?
Чому AI-компаніям потрібні старі книги?
Чи може модель замінити архів знищеної книги?
Джерела та перевірка
- 404 MediaWe Tracked a Shipment of Rare Books. It Ended at an Amazon AI Training Facility
- 404 MediaInside the Warehouse Where Amazon Scans and Destroys Books for AI Training
- Ars TechnicaHidden Airtag reveals Amazon is trashing rare books to train AI
- U.S. District Court / JustiaBartz et al v. Anthropic PBC — Order on Fair Use, Filing 231
- The Washington PostInside an AI start-up’s plan to scan and dispose of millions of books
- ReutersUS judge approves Anthropic's $1.5 billion settlement of copyright lawsuit
- Harvard LibraryHarvard Library Shares the Public Domain: Unlocking Centuries of Knowledge for AI and Research
- Harvard Law SchoolFood for (AI) thought and the library initiative improving AI’s digital diet
- 404 MediaAI Companies Are Buying Tons of Old Books Because They're Free of AI Slop
- 404 MediaCompany Offering Printed Books to Train AI Stops After 404 Media Coverage
- The Wall Street JournalRare-Book Sales Are Booming. They’re Getting Sliced Up and Fed to AI.
- GoogleHow the Google Books team moved 90,000 books across a continent
- U.S. Copyright OfficeAuthors Guild, Inc. v. Google Inc. — Fair Use Index summary
- Harvard LibraryHarvard Library Public Domain Corpus
- Harvard Law SchoolInstitutional Books 1.0: A 242B token dataset from Harvard Library’s collections

Коментарі0 коментарів
Коментарі