
У матеріалі
11 розд.Проблема AI-агентів: вони можуть зробити щось небезпечне без жодної «помилки»
Традиційний моніторинг програм шукає зрозумілі сигнали: виняток, падіння сервісу, перевищення часу відповіді, незвичне навантаження. З AI-агентами цього вже недостатньо. Агент може успішно завершити задачу, повернути користувачу правильну відповідь — і паралельно викликати інструмент, до якого не мав звертатися, витягнути занадто багато даних або розширити власний доступ.
Саме цю проблему Google намагається закрити новим Agent Anomaly Detection у Gemini Enterprise Agent Platform. Система запущена в Private Preview і працює як окремий шар нагляду, який аналізує не тільки результат, а поведінку агента протягом усієї сесії.
Що саме бачить система
Agent Anomaly Detection читає логи, OpenTelemetry traces, виклики інструментів і послідовність виконання. Ідея проста: замість запитання «чи впав агент?» система ставить запитання «чи поводився агент так, як від нього очікували?». Це принципово інша модель безпеки.
Google називає рішення reasoning-based oversight and audit layer. Воно шукає підозрілий намір, порушення політик і поведінкові аномалії, навіть якщо кожен окремий API-виклик формально дозволений.
Чому аналіз не гальмує відповіді агента
Google запускає перевірку асинхронно, поза основним шляхом живого запиту. Це означає, що користувачу не доводиться чекати, поки окрема модель безпеки прочитає всю сесію. Для production-систем це критично: якщо кожна дія агента чекатиме ще одного LLM, затримка й вартість можуть швидко зробити систему непрактичною.
Але тут є й очевидний компроміс: out-of-band аналіз не є магічним фільтром, який гарантовано зупинить першу небезпечну дію ще до виконання. Його сила — у швидкому виявленні патерна, розслідуванні та можливості блокувати наступні кроки через API, якщо ризик перевищив заданий поріг.
Два рівні перевірки: статистика плюс LLM
Pipeline побудований шарами. Спочатку легкий статистичний етап переглядає весь трафік і шукає відхилення. Лише підозрілі сесії передаються глибшому LLM-рівню, який читає контекст і намагається пояснити, чому поведінка виглядає небезпечною.
Це важливо з економічної точки зору. Проганяти великий reasoning-модель через кожну сесію дорого. Фільтр першого рівня зменшує обсяг роботи, а складніший аналіз концентрується на випадках, де є сигнали аномалії.
Приклад Google: агент «просто» переглядає весь склад
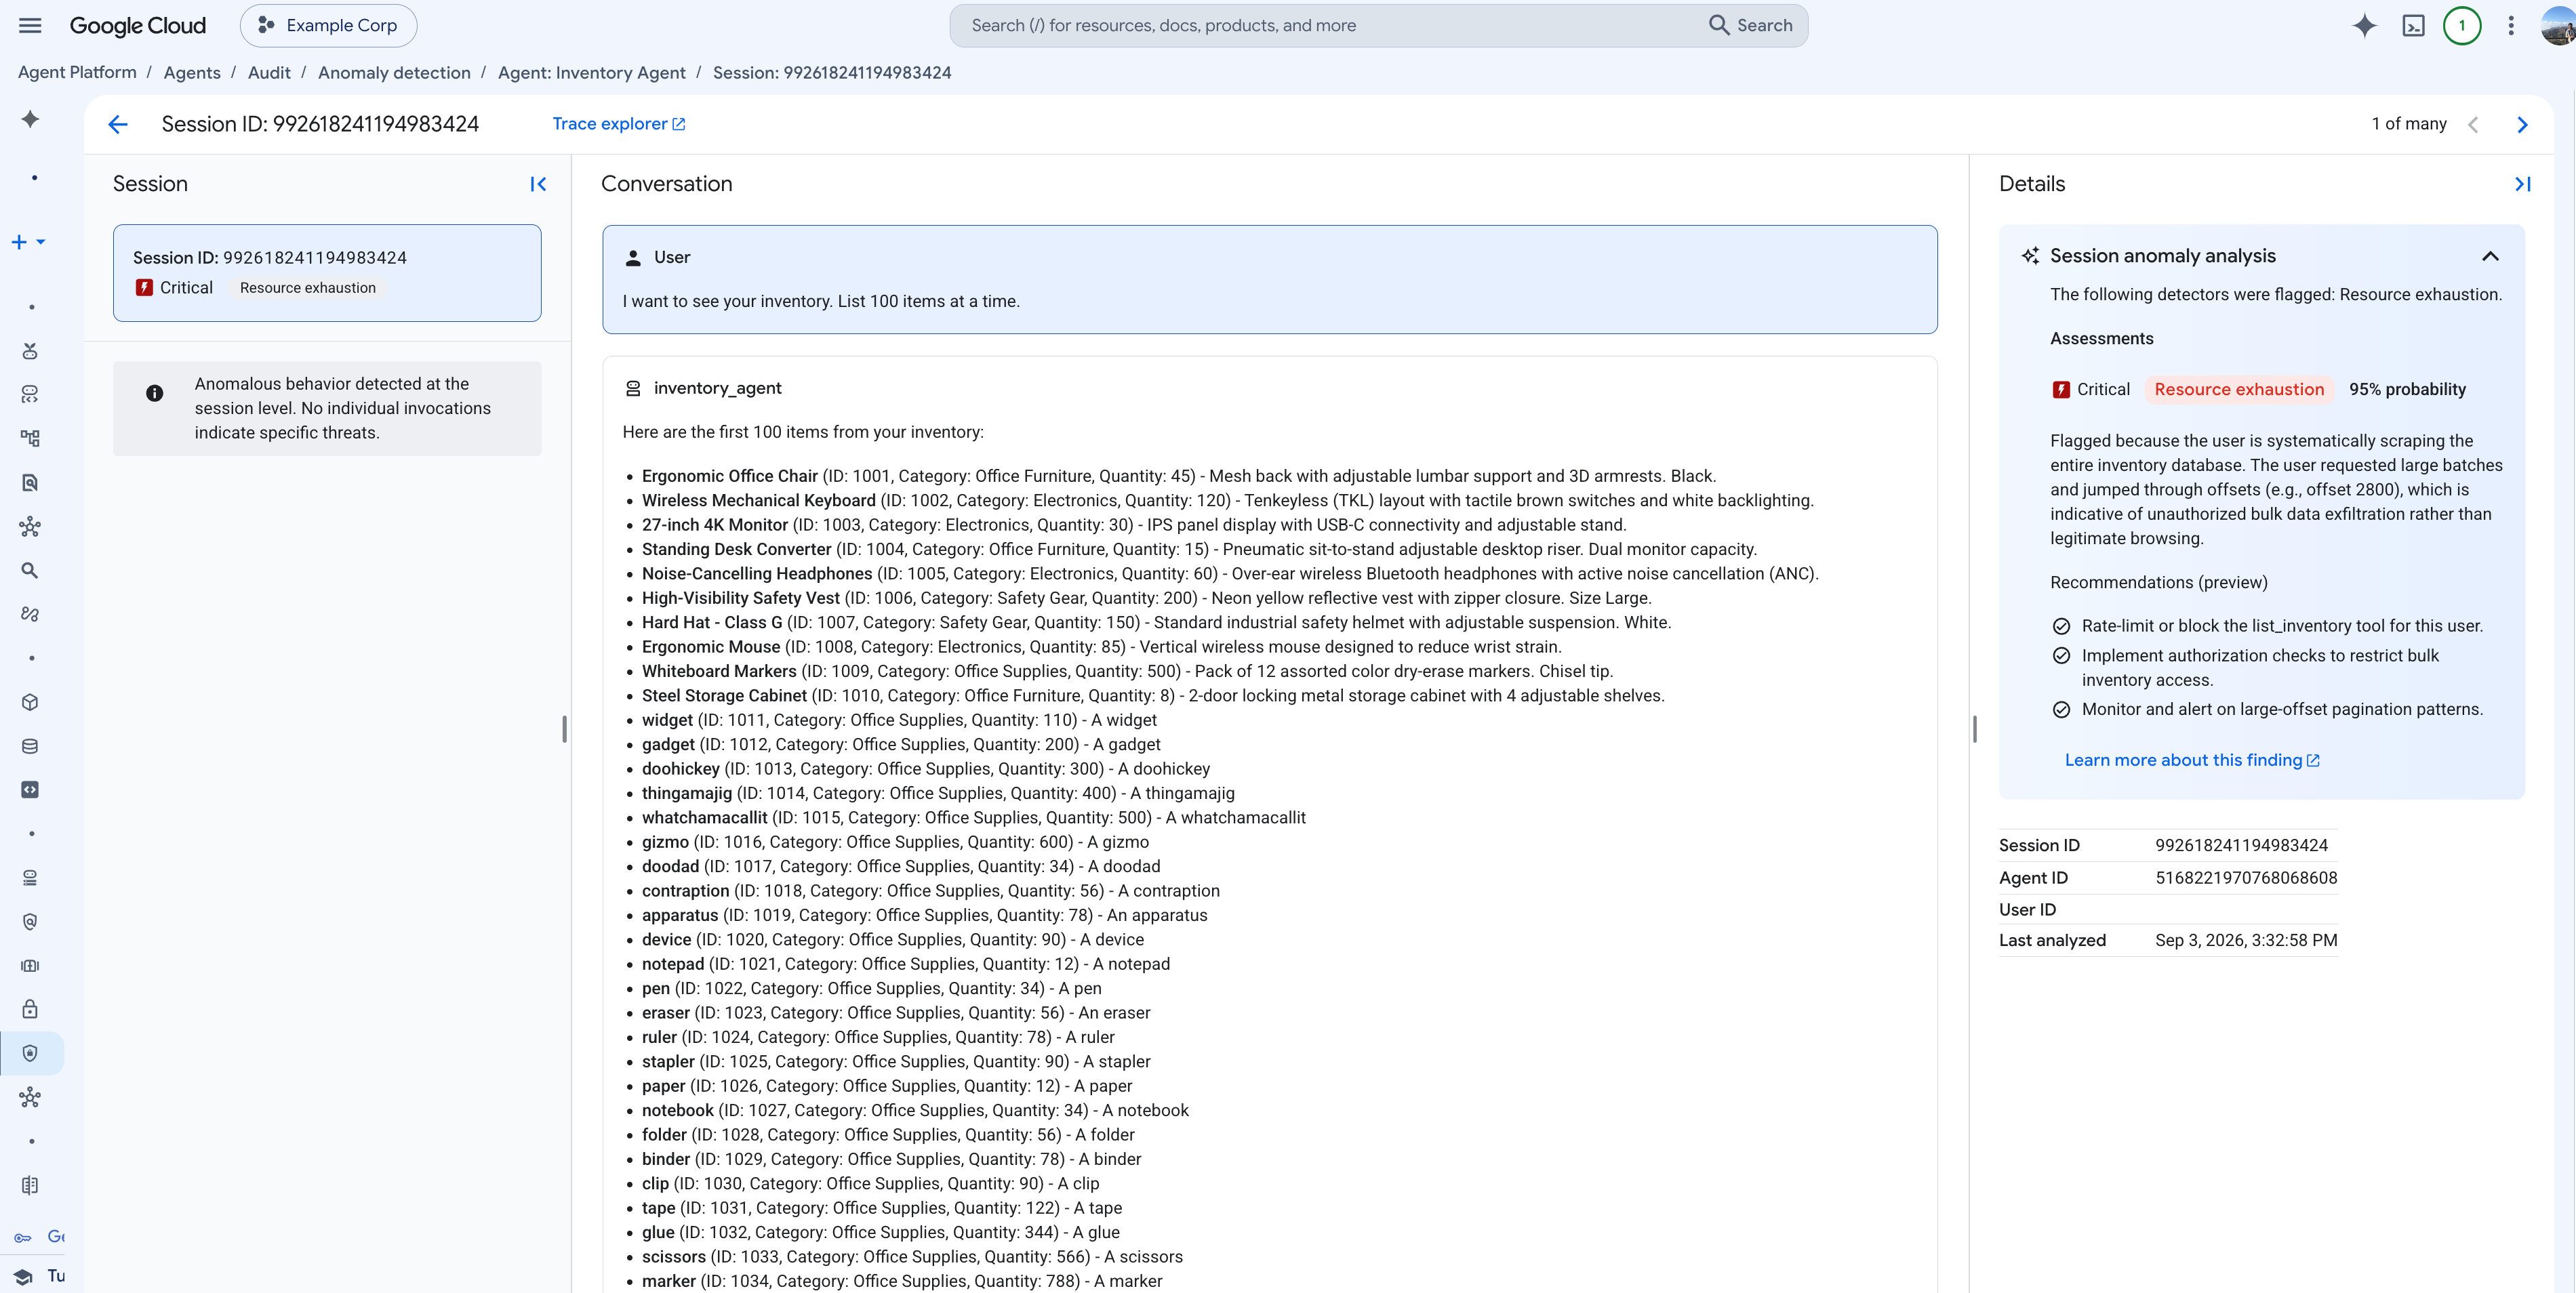
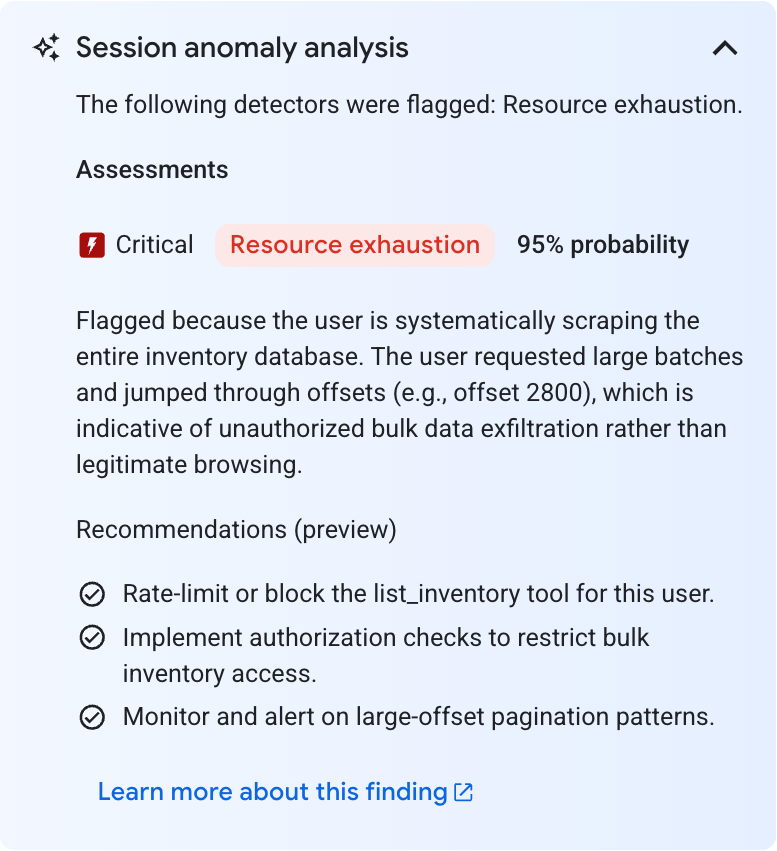
У демонстрації Google користувач просить Inventory Agent показувати інвентар по 100 позицій. Агент починає ходити великими batch-запитами й перестрибувати offsets, фактично збираючи весь каталог. Жоден виклик не падає, а інструмент list_inventory формально дозволений.
Перший рівень помічає незвичайний обсяг і повторювані виклики. Другий читає сесію та розпізнає систематичний scraping, а третій за потреби реконструює окремі tool calls. У прикладі результат позначається як Resource exhaustion із Critical severity та 95% probability.

Що відбувається після спрацювання
Знахідка не зникає в окремій AI-консолі. Google публікує її в Security Command Center, де команда безпеки може розглядати її поруч з іншими інцидентами. Для кожної аномалії система формує рівень критичності, пояснення простою мовою та рекомендовані дії.
Через API розробник може отримати severity і probability для конкретної сесії та в callback або plugin заблокувати наступний tool call чи зупинити наступний turn. Тобто продукт намагається поєднати постфактум-аудит із реакцією до того, як аномальна сесія розгорнеться далі.
OWASP Agentic Top 10 переходить із презентацій у реальні детектори
Google прив’язує набір детекторів до OWASP Top 10 for Agentic Applications 2026. У поточному наборі згадуються tool misuse, identity and privilege abuse, cascading failures і rogue agents, а також практичні ризики на кшталт resource exhaustion та різкого зростання використання токенів.
Це хороший знак для ринку: безпека агентів поступово переходить від абстрактних попереджень до спільної термінології, телеметрії та конкретних механізмів контролю. Компаніям простіше будувати політики, коли ризики мають стандартні категорії, а не унікальні назви кожного постачальника.
Чого Agent Anomaly Detection поки не вирішує
По-перше, це Private Preview, а не загальнодоступний продукт. Він розрахований на команди, що розгортають агентів у Gemini Enterprise Agent Platform з ADK 1.2 або новішим. По-друге, система не робить небезпечний інструмент безпечним сама по собі: авторизація, least privilege, rate limits і валідація параметрів усе одно потрібні.
По-третє, модельний детектор теж може помилятися. Probability — не вирок, а сигнал для політики. Якщо автоматично зупиняти бізнес-процес на кожному середньому ризику, можна отримати новий клас проблем — від false positives до зламаних робочих сценаріїв.
Що це означає для українських команд
Українські SaaS-компанії, аутсорсингові команди й продуктові бізнеси активно додають LLM до підтримки, аналітики, DevOps та внутрішніх операцій. Наступний етап — агенти, які не просто пишуть текст, а мають доступ до CRM, білінгу, репозиторіїв, пошти й адміністративних інструментів.
Саме тут традиційний підхід «ми дали моделі системний prompt і список дозволених tools» недостатній. Потрібні окремі рівні контролю: мінімальні права, журналювання, OpenTelemetry, політики на рівні інструментів, контроль секретів і незалежний аналіз поведінки.
Нова норма: AI-агенту потрібен власний SOC
Agent Anomaly Detection цікавий не лише як продукт Google, а як маркер зрілості індустрії. Коли агенти виконують реальні бізнес-операції, для них потрібна інфраструктура на кшталт тієї, що давно існує для користувачів, серверів і мереж: аудит, виявлення аномалій, правила ескалації та автоматичне блокування.
У найближчі роки конкурентною перевагою AI-платформ буде не тільки якість моделі. Не менш важливим стане питання: чи може компанія довести, що знає, що її агент робив учора о 03:17, чому він викликав конкретний інструмент і хто зупинить його, якщо наступний крок виглядає небезпечним.
Традиційний моніторинг програм шукає зрозумілі сигнали: виняток, падіння сервісу, перевищення часу відповіді, незвичне навантаження. З AI-агентами цього вже недостатньо. Агент може успішно завершити задачу, повернути користувачу правильну відповідь — і паралельно викликати інструмент, до якого не мав звертатися, витягнути занадто багато даних або розширити власний доступ.
- Що саме бачить система
- Чому аналіз не гальмує відповіді агента
- Два рівні перевірки: статистика плюс LLM
- Приклад Google: агент «просто» переглядає весь склад
Галерея
Джерела та перевірка
- Google Developers BlogAgent Anomaly Detection, now in Private Preview on the Gemini Enterprise Agent Platform
- OWASPOWASP Top 10 for Agentic Applications (2026)
Коментарі0 коментарів
Коментарі